ИИ-тренд GENER8ION: как создать видео нейросетью в Seedance 2.5
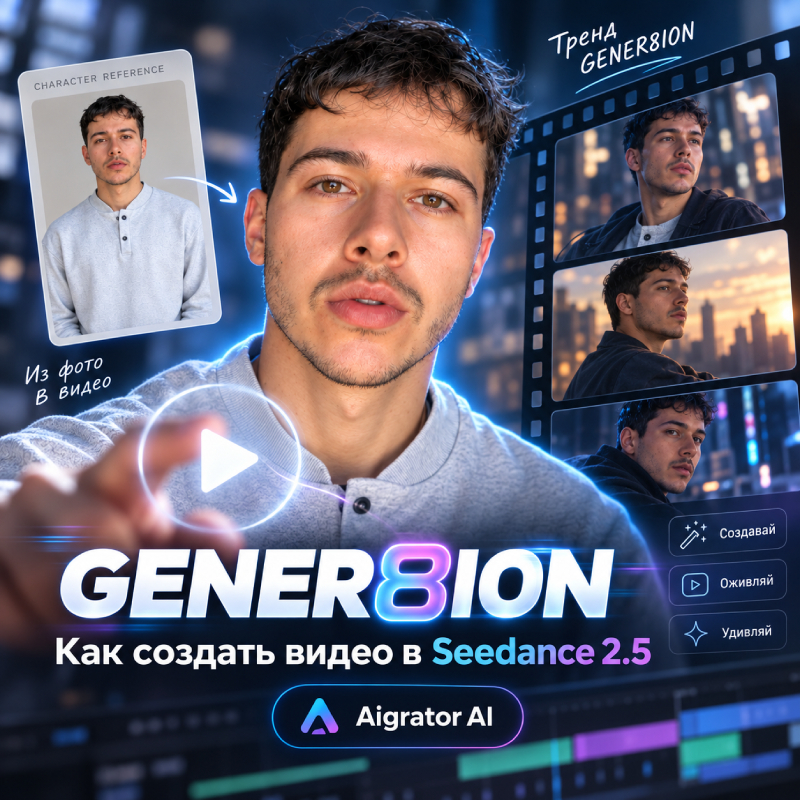
ИИ-тренд GENER8ION позволяет взять готовое видео и заменить главного героя на себя или другого персонажа, сохранив исходную постановку сцены. Камера, движение людей, локация, свет, тайминг и действия остаются максимально близкими к референсу, а внешность центрального персонажа берется с загруженной фотографии.
Сделать такой ролик можно через Seedance 2.5 в Aigrator AI. Для генерации понадобятся исходное видео GENER8ION и фотография персонажа. Главное правильно подготовить референс и подробно объяснить нейросети, что из видео нужно сохранить, а что заменить.
Ниже пошагово разберем весь процесс.
Что представляет собой тренд GENER8ION
Суть тренда не в обычной генерации видео по тексту. Здесь используется готовая сцена как основа.
Нейросеть получает два главных референса:
- исходное видео с движением камеры, героя и толпы;
- фотографию человека, который должен заменить оригинального персонажа.
После этого Seedance 2.5 должна повторить постановку исходного ролика, но показать в центре уже нового героя.
В нашем случае важно сохранить сцену с красным яблоком: персонаж подносит его ко рту, откусывает, жует, опускает руку, разворачивается и уходит в движущуюся толпу.
При этом заменить нужно только самого героя.
Как сделать тренд GENER8ION в Seedance 2.5
Шаг 1. Скачиваем исходное видео
Сначала скачайте видео GENER8ION, которое будет использоваться как основной видеореференс.
Не нужно заранее обрезать сцену, менять скорость или добавлять эффекты. Для этого способа важно передать Seedance исходную последовательность движений.
Нейросеть должна использовать видео как шаблон для:
- движения камеры;
- расстояния до героя;
- движения толпы;
- тайминга;
- действий с яблоком;
- освещения;
- атмосферы;
- локации.
То есть видео определяет, что происходит в кадре, а фотография определяет, кто находится на месте главного героя.
Шаг 2. Переходим в Aigrator AI
Открываем Aigrator AI и переходим к генерации видео.
Здесь не потребуется отдельно устанавливать Seedance или настраивать модель на компьютере. Нужная модель доступна непосредственно внутри сервиса.
Для этого сценария нас интересует именно Seedance 2.5, поскольку генерация строится одновременно вокруг видео и изображения-референса.
Шаг 3. Выбираем Видео / Seedance 2.5
В разделе генерации видео выбираем Seedance 2.5.
Дальше важно не перепутать файлы.
Исходный ролик GENER8ION загружаем во вкладку:
«Правка видео»
Фотографию человека загружаем во вкладку:
«Референс»
Таким образом:
Video1 = исходный ролик GENER8ION
Image1 = ваш персонаж
Фотография здесь особенно важна. Если загрузить только случайный портрет низкого качества, модели будет сложнее сохранить внешность при поворотах и изменении расстояния до камеры.
Лучше использовать фото-карту, где есть крупное лицо и человек во весь рост.
Шаг 4. Вставляем промт
После загрузки видео и фотографии вставляем следующий промт:
TASK: Reference (video-to-video), character replacement. @Video1 = camera, timing, choreography, the apple action, the crowd, the location, the light and the atmosphere - repeat all of it exactly, same distances, same pull-back, never wider than @Video1. Replace ONLY the hero in the white suit with the person from @Image1. HERO (@Image1, strict lock): the exact person from @Image1 and no one else. Take EVERYTHING from @Image1: face shape, eye color, skin tone, hair color and hairstyle, facial hair or no facial hair, age, body build, height, clothing and shoes. Face 100% matched to @Image1, no modifications, same face and same outfit from the first frame to the last frame. Zero blending with the original hero from @Video1: not the face, not the beard, not the eyes, not the skin, not the suit, not the tie. If @Image1 and the original hero differ, @Image1 wins in every detail. The hero performs exactly what the original hero does in @Video1: holds the red apple at the mouth, bites it with a crunch, chews, lowers it, turns, walks into the crowd, stands still while the crowd moves. The hero is the only person in the frame not dressed in black. CROWD, LOCATION, LIGHT, SOUND: unchanged from @Video1. Real time only. [Strictly exclude] face inherited from video reference, clothing inherited from video reference, white suit, red tie; blended face, mixed identity, average of two faces, original hero's beard, original hero's eyes, original hero's skin tone; different face, another person, face swap, identity drift, face morphing, changed hairstyle, changed outfit; camera wider than reference, extra pull-back; changed location, changed crowd, changed light; mirrored, flipped; monochrome, black and white; slow motion, static frozen, stiff; extra limbs, extra fingers, deformed hands; text, watermark, subtitles, logos; real celebrities, real famous faces.
После этого запускаем генерацию.
Зачем нужен такой длинный промт
Для тренда GENER8ION недостаточно написать:
Замени человека в видео на человека с фотографии.
В таком случае модель получает слишком много свободы.
Она может взять лицо из фотографии, но оставить костюм оригинального героя. Или смешать черты двух людей. Иногда меняется движение камеры, сцена становится шире или персонаж начинает двигаться иначе.
Поэтому промт жестко разделяет роли двух референсов.
Из Video1 берем:
- камеру;
- движения;
- тайминг;
- толпу;
- яблоко;
- локацию;
- свет;
- атмосферу.
Из Image1 берем:
- лицо;
- глаза;
- оттенок кожи;
- волосы;
- телосложение;
- рост;
- одежду;
- обувь.
Это один из самых важных моментов всего гайда.
Почему в промте отдельно запрещен белый костюм
В исходном видео центральный персонаж одет в белое. Если просто попросить заменить человека, Seedance может сохранить часть его одежды, потому что рассматривает костюм как важный элемент видеореференса.
Поэтому в негативных инструкциях отдельно прописаны:
white suit, red tie
А выше модели явно объясняется, что одежду необходимо брать из Image1.
Иначе можно получить нужное лицо, но костюм от исходного героя.
Как лучше подготовить свое фото
Качество референса сильно влияет на результат.
Для GENER8ION лучше не использовать селфи, где видна только половина лица или человек сильно повернут в сторону.
Оптимальный вариант - создать одну фото-карту персонажа.
На ней можно разместить:
- крупный портрет анфас;
- изображение по пояс;
- фотографию во весь рост.
Особенно важно сохранить одинаковую одежду.
Если на одном изображении человек в футболке, а на другом в костюме, Seedance придется самостоятельно решать, какой вариант использовать. Это повышает вероятность изменений между кадрами.
Что делать, если лицо меняется
Если при удалении камеры лицо начинает становиться другим, проблема чаще всего связана с референсом.
Попробуйте загрузить более четкое изображение и оставить в промте жесткие формулировки:
strict lock
exact person from Image1 and no one else
Face 100% matched to Image1
same face from the first frame to the last frame
Не стоит постоянно добавлять десятки новых описаний внешности вручную. Если фотография качественная, лучше заставить модель сильнее ориентироваться именно на нее.
Что делать, если Seedance оставляет одежду из оригинала
Для этого в промте уже прописано:
clothing and shoes from Image1
и отдельно:
Zero blending with the original hero from Video1
Если проблема остается, можно дополнительно усилить инструкцию:
Use only the clothing visible in Image1. Never inherit any clothing from Video1.
Так модели становится еще понятнее, какой источник имеет приоритет.
Почему этот тренд хорошо подходит для Seedance 2.5
Здесь важна не просто красота отдельных кадров.
Нужно одновременно сохранить несколько вещей:
движение из видео + человека с фотографии + локацию + камеру + последовательность действий.
Именно поэтому обычная генерация text-to-video для такого тренда подходит хуже.
Смысл GENER8ION заключается в том, что готовая сцена остается узнаваемой, а центральным героем становитесь вы.
Кому подойдет тренд GENER8ION
Такой формат можно использовать не только как обычный вирусный ролик.
Он подойдет:
- блогерам;
- авторам TikTok и Reels;
- SMM-специалистам;
- дизайнерам;
- владельцам личного бренда;
- креаторам;
- тем, кто экспериментирует с AI-видео.
Особенно эффектно тренд работает именно с хорошо узнаваемым человеком, поскольку зритель сразу замечает замену центрального персонажа.
Итог
Чтобы повторить ИИ-тренд GENER8ION, не нужно заново описывать всю сцену текстом.
Скачиваем готовое видео, открываем Aigrator AI, выбираем Seedance 2.5, загружаем ролик в «Правка видео», а фото-карту своего персонажа в «Референс».
После этого вставляем готовый промт, который четко объясняет нейросети: всю постановку нужно взять из видео, а центрального героя полностью заменить человеком с фотографии.
Самое важное здесь - качественный референс персонажа и четкое разделение Video1 и Image1. Тогда Seedance 2.5 получает готовую хореографию сцены и одновременно понимает, чью внешность необходимо сохранить на протяжении всего ролика.