AI-краулеры меняют веб-трафик: кому открывать сайт и как ограничивать лишнюю нагрузку
В рекламном кабинете число переходов почти не изменилось, а сервер стал отвечать медленнее. В журнале запросов — новые названия роботов, которые читают статьи, карточки товаров и страницы каталога. Возникает соблазн заблокировать всех, кто связан с искусственным интеллектом. Но вместе со сборщиком обучающих данных под запрет может попасть робот, который помогает потенциальному покупателю найти ваш продукт.
Бизнесу нужно решить, кому открывать материалы и какую нагрузку считать приемлемой. Само слово «AI» в названии бота не отвечает на эти вопросы.
Начните с двух шагов: разделите роботов по назначению и выясните, какие обращения действительно замедляют сайт. Это поможет сохранить полезный доступ и ограничить лишнюю нагрузку.
Почему роботов не видно в отчёте о посетителях
Веб-аналитика и серверные журналы измеряют разные события. Робот может скачать страницу, не запустив код счётчика. Сервер обработает обращение, но в привычном маркетинговом отчёте визит может не появиться. Поэтому стабильная посещаемость ещё не означает стабильную нагрузку.
Если сайт работает на виртуальном сервере, посетители и краулеры могут использовать одни и те же ресурсы приложения и базы данных. Когда свободной мощности мало, интенсивный обход способен увеличить время ответа. Для магазина это риск задержек в каталоге и оформлении заказа, для B2B-сайта — при отправке заявки.
Однако сам факт появления AI-бота ещё не объясняет замедление. Причиной могут быть реклама, обновление системы управления сайтом или медленный запрос к базе. Чтобы выбрать действие, нужно сопоставить обращения роботов с показателями работы сайта.
Три задачи AI-ботов: обучение, поиск, чтение по запросу
Сбор материалов для обучения. У OpenAI эту задачу выполняет GPTBot, у Anthropic — ClaudeBot. Они собирают контент, который может использоваться при обучении моделей. Разрешение такого обхода само по себе не обещает переходов на сайт: это решение о допустимом использовании материалов компании.
Поддержка поиска. OAI-SearchBot помогает показывать сайты в поисковых функциях ChatGPT, Claude-SearchBot — улучшать поисковые ответы Claude. Если компания хочет, чтобы её материалы находили через соответствующий сервис, доступ такого робота имеет практический смысл.
Чтение по запросу пользователя. Человек может попросить помощника изучить товар или прочитать инструкцию. Для некоторых таких обращений OpenAI использует ChatGPT-User, Anthropic — Claude-User. Здесь пользователь уже указал страницу или задачу для изучения.
Разрешённый доступ создаёт возможность прочитать и использовать материал в соответствующем сценарии, но не гарантирует цитирования или продажи. Назначения этих роботов описаны в официальной документации OpenAI и Anthropic.
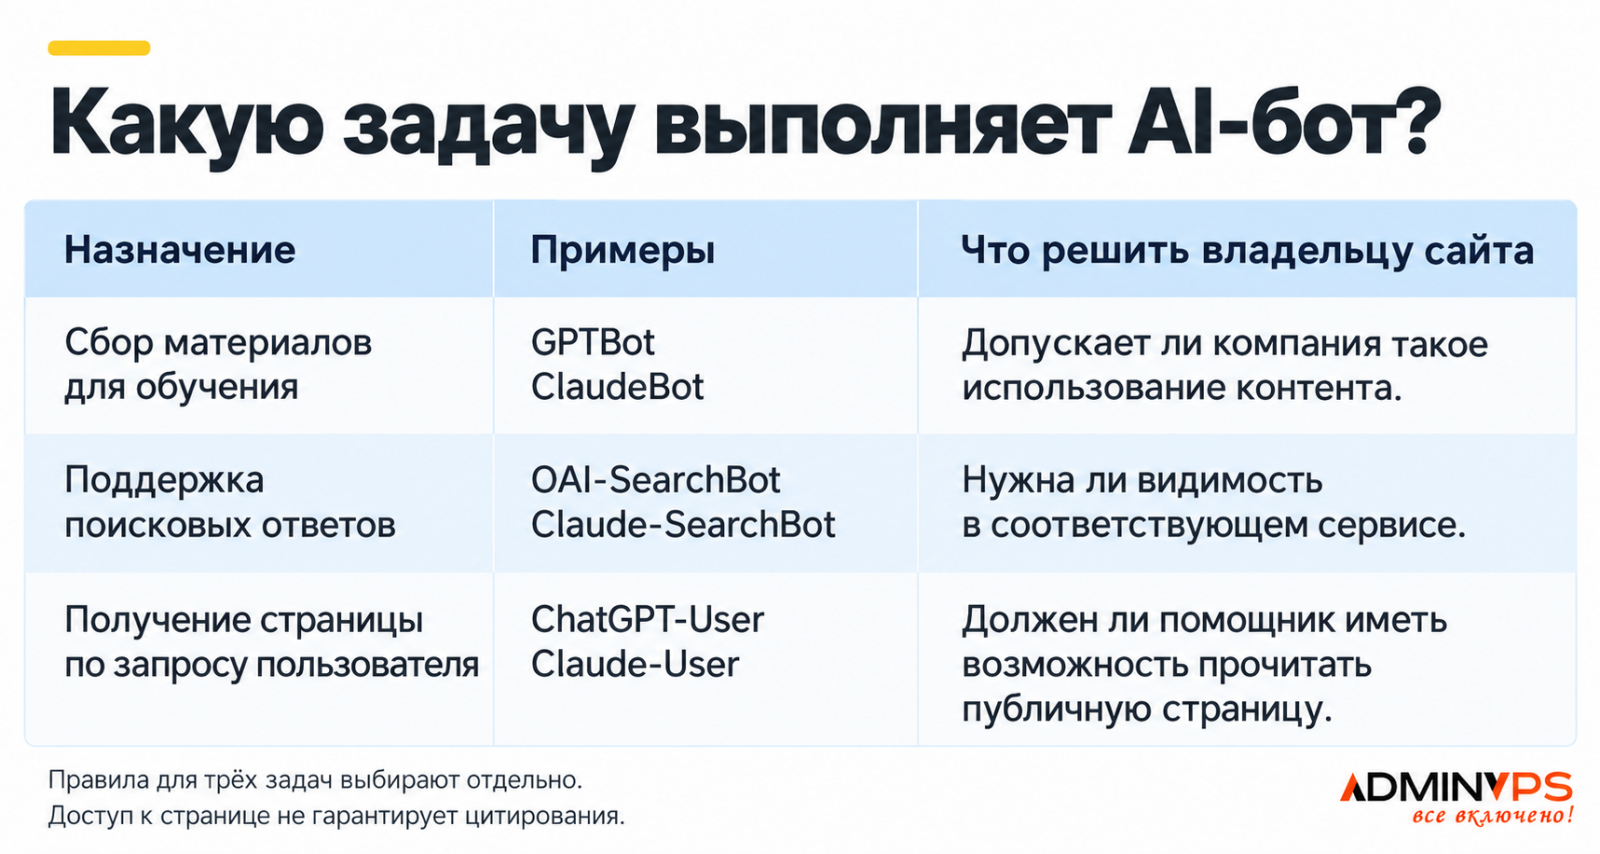
Правила доступа для трёх задач выбирают отдельно: обучающие боты собирают материалы для моделей, поисковые помогают находить контент, пользовательские получают страницу по запросу человека.
Отдельная оговорка касается Google. Google-Extended — название настройки в файле robots.txt, а не самостоятельный бот, который представляется этим именем при посещении сайта. Настройка регулирует определённые способы использования контента в Gemini и Vertex AI. Её запрет не исключает сайт из Google Search и не управляет участием в AI Overviews или AI Mode.
Для AI-функций поиска действуют механизмы Google Search, включая правила для Googlebot и ограничения показа контента. Решения об обучении моделей и видимости в поиске нужно принимать отдельно.
Почему важнее смотреть на страницы, а не считать ботов
Два робота с одинаковым числом обращений могут создавать совершенно разную нагрузку. Один читает статьи из кэша — сохранённой готовой копии страницы. Другой перебирает фильтры каталога, и сайт каждый раз заново выбирает товары из базы, рассчитывает цены и собирает ответ.
Показательный сценарий — магазин с комбинациями фильтров и сортировок. Если робот находит ссылки на многочисленные варианты одного ассортимента, число доступных адресов разрастается. Когда страницы создаются заново при каждом обращении, обход увеличивает работу приложения и базы данных. Масштаб эффекта зависит от устройства сайта и интенсивности запросов.
Что выяснить до первой блокировки
Команде нужны данные за обычные часы и за период замедления. В серверном журнале полезно видеть, кто и когда обратился, какую страницу запросил, сколько данных получил и как долго обрабатывался запрос. Эти сведения сопоставляют с загрузкой процессора, памятью, очередями и ошибками сайта.
Отдельно проверяют, действительно ли посетитель принадлежит заявленному сервису. User-Agent — строку, которой программа представляется серверу, — можно подделать. Поэтому надпись «известный бот» не должна автоматически давать исключение из защиты. Где оператор публикует диапазоны IP или другие способы проверки, используют их.
Результат диагностики — конкретная проблема, например: «при обходе фильтров замедляется каталог». Число AI-ботов само по себе ещё не объясняет причину.
Как ограничивать обход и сохранять полезный доступ
Если лишняя нагрузка от ботов подтверждена, начните с пересмотра правил отдельно для обучения, поиска и чтения по запросу. Ограничивайте обращения к тем страницам, которые создают проблему.
Разделить правила обхода и защиту сайта
Robots.txt — публичный файл, в котором владелец сообщает совместимым роботам, какие адреса разрешено обходить. Он позволяет разделять доступ разных краулеров. Например, компания может разрешить поисковый обход и ограничить сбор материалов для обучения.
Но такой файл не защищает закрытые данные: личный кабинет и непубличные документы должны быть доступны только после проверки прав пользователя. Это прямо следует из стандарта Robots Exclusion Protocol.
Есть и различия между сервисами. OpenAI предупреждает, что для действий ChatGPT-User, инициированных пользователем, правила robots.txt могут не применяться. Поэтому реальное ограничение нежелательных обращений настраивают на веб-сервере или в системе защиты сайта.
Там можно ограничить частоту запросов и выделить отдельные правила для тяжёлых страниц. Допустимую частоту выбирают по обычной работе проекта: одинаковый порог для небольшого корпоративного сайта и крупного магазина будет малоинформативен.
Сократить лишнюю работу сайта
Если нагрузку создаёт перебор фильтров, нужно проверить, откуда робот получает ссылки на все эти варианты. SEO-специалист и разработчик должны согласовать, какие страницы нужны для поиска, какие доступны для обхода и какие вообще стоит создавать. Ограничение обхода и удаление страницы из поискового индекса — разные действия.
Следующий вопрос — можно ли отдавать публичную страницу из кэша вместо повторного расчёта. Подключение внешнего сервиса доставки контента само по себе не означает, что это уже происходит: результат зависит от настроек и правил хранения ответов.
Для магазина особенно важны границы такого хранения. Корзина, личный кабинет и персональные предложения требуют отдельной логики. На публичных карточках нужно определить, как быстро обновляются цены и остатки. Ускорение не должно приводить к показу чужих данных или устаревших условий покупки.
В задачах администрирования серверов диагностику производительности имеет смысл ставить раньше увеличения ресурсов. Если причина в тяжёлой генерации страниц, более мощная конфигурация может лишь отложить повторение проблемы.
Проверить изменения на пути покупателя
Предположим, магазин обнаружил интенсивный обход фильтров. Команда проверяет источник, ограничивает проблемный поток и выясняет, какие лишние адреса сайт сам открывает для обхода. Затем оценивает кэширование публичных страниц. Чек-лист ниже поможет проверить эти изменения.
Чек-лист: до и после изменения правил
Перед ограничениями:
- Определить назначение робота и проверить его подлинность доступными средствами.
- Найти страницы, на которых обход совпадает с ростом времени ответа, очередей или ошибок.
- Зафиксировать исходные показатели и подготовить возможность отменить изменения.
После изменения правил:
- Проверить карточку товара, поиск, корзину, оплату и отправку формы.
- Проверить доступ нужных поисковых роботов, платёжных уведомлений и интеграций.
- Сравнить скорость и ошибки в сопоставимые периоды, учитывая рекламу и другие изменения нагрузки.
Как оценивать пользу AI-трафика
Запрос робота, упоминание бренда в ответе помощника и визит покупателя — три разных события. Рост первого показателя не доказывает рост остальных. Нельзя делить число обращений краулера на заявки и считать это конверсией AI-поиска.
Для оценки канала полезно отслеживать распознанные переходы из AI-сервисов, их посадочные страницы и целевые действия. Источник определяется не всегда, а часть людей возвращается позже другим способом. Эти данные показывают наблюдаемую часть результата.
Технический эффект оценивают отдельно: что произошло со скоростью, ошибками и нагрузкой. Если сайт стал быстрее одновременно с завершением рекламной кампании, весь эффект нельзя приписывать ограничениям бота.
Какие боты действительно нужны сайту
Полезность робота определяется задачами компании и стоимостью его обращений. Поисковый краулер может поддерживать обнаружение материалов, но это не требует неограниченного обхода любых адресов. Сборщик обучающих данных не становится вредоносным из-за отсутствия измеримых переходов, однако компания может ограничить такое использование своего контента.
Рабочая политика должна фиксировать, какие публичные разделы доступны каждому типу роботов, кто отвечает за правила и при каких признаках нагрузки их пересматривают. Тогда решения о видимости сайта и его производительности можно принимать согласованно. Цель управления AI-краулерами — сохранить доступность полезного контента при предсказуемой работе сайта для покупателей.