Как подключить базу знаний к нейросети в 2026 году: подготовка документов, настройка и тестирование
Чтобы подключить базу знаний к нейросети, соберите проверенные документы, удалите устаревшие версии, выберите способ загрузки или синхронизации, задайте правила ответа и проведите тесты на реальных вопросах. Для небольшого проекта хватит файлов в GPT, Claude Project или Gemini Gem. Для регулярно обновляемой базы лучше использовать Copilot Studio, Dify, Voiceflow либо другую платформу с управлением источниками. Подготовить структуру, инструкцию и тестовый набор можно через MashaGPT.
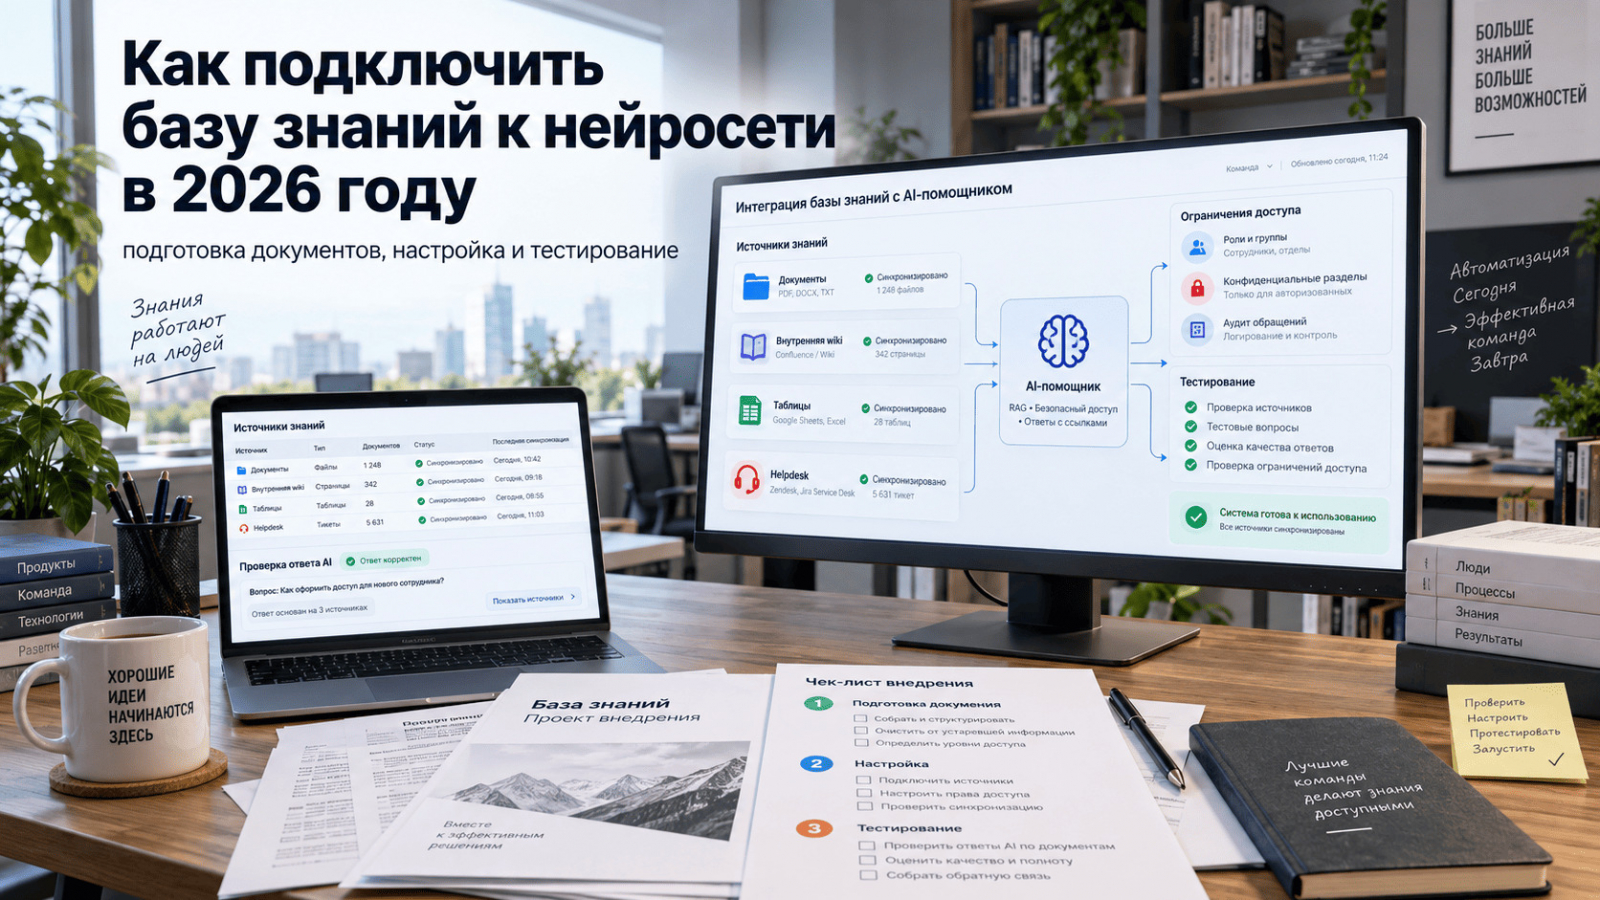
Сам факт загрузки документов не гарантирует точный ответ. Нейросеть может найти неподходящий фрагмент, смешать две версии правила или дополнить пробел общими знаниями. Поэтому рабочая база требует владельцев, дат проверки, прав доступа, цитат и понятного поведения при отсутствии ответа.
Что считается базой знаний для нейросети
База знаний — набор источников, по которым AI отвечает на вопросы: инструкции, регламенты, справочные статьи, карточки продуктов, договорные условия, учебные материалы или внутренние правила. Источником может быть отдельный файл, папка в облаке, сайт, корпоративная wiki, таблица или внешняя система.
Простая загрузка файла добавляет контекст к чату или помощнику. Такой способ подходит для ограниченного набора стабильных материалов. Если документы часто меняются, ручная замена быстро создаёт путаницу: старая копия остаётся в одном помощнике, новая — в другом.
Для крупных коллекций применяется RAG — поиск по базе перед генерацией ответа. Система получает вопрос, находит подходящие фрагменты, передаёт их модели и формирует ответ на основе найденного контекста. Качество зависит от структуры документов, разбиения текста, метаданных, поискового запроса и правил ответа.
Три способа подключить знания
Загрузить файлы в готового помощника
Это самый быстрый вариант для инструкций, учебных материалов или проектных документов. Пользователь загружает PDF, DOCX, таблицы или текст, добавляет инструкцию и задаёт вопросы. Подход поддерживают пользовательские GPTs, Claude Projects, Gemini Gems и другие сервисы.
Плюсы — быстрый старт и отсутствие отдельной инфраструктуры. Ограничения — ручное обновление, лимиты на файлы, зависимость от тарифа и слабый контроль сложных прав. Такой вариант лучше использовать для одного владельца или небольшой группы с одинаковым уровнем доступа.
Подключить управляемый источник
Здесь помощник обращается к SharePoint, Google Drive, сайту, wiki, CRM или helpdesk. Обновление происходит в исходной системе, поэтому меньше риск разнести разные версии. Copilot Studio, к примеру, работает с корпоративными источниками и учитывает разрешения пользователя в совместимых сценариях.
Перед подключением нужно проверить область поиска. Если дать агенту целый сайт или общий диск, в выдачу попадут черновики, архивы и документы соседних отделов. Лучше начать с отдельной папки или раздела с назначенным владельцем.
Собрать собственную RAG-базу
Этот путь подходит для сайта, клиентского бота или внутреннего портала с собственным интерфейсом. Dify и Voiceflow дают визуальные инструменты для импорта, поиска, метаданных, тестирования и публикации. Разработчики могут использовать API, файловый поиск и векторное хранилище.
Собственная система даёт больше контроля над обновлением, фильтрами и журналом запросов. Она требует проектирования: нужно выбрать правила разбиения, модель поиска, порог релевантности, права, хранение и процедуру удаления сведений.
Как подготовить документы для базы знаний
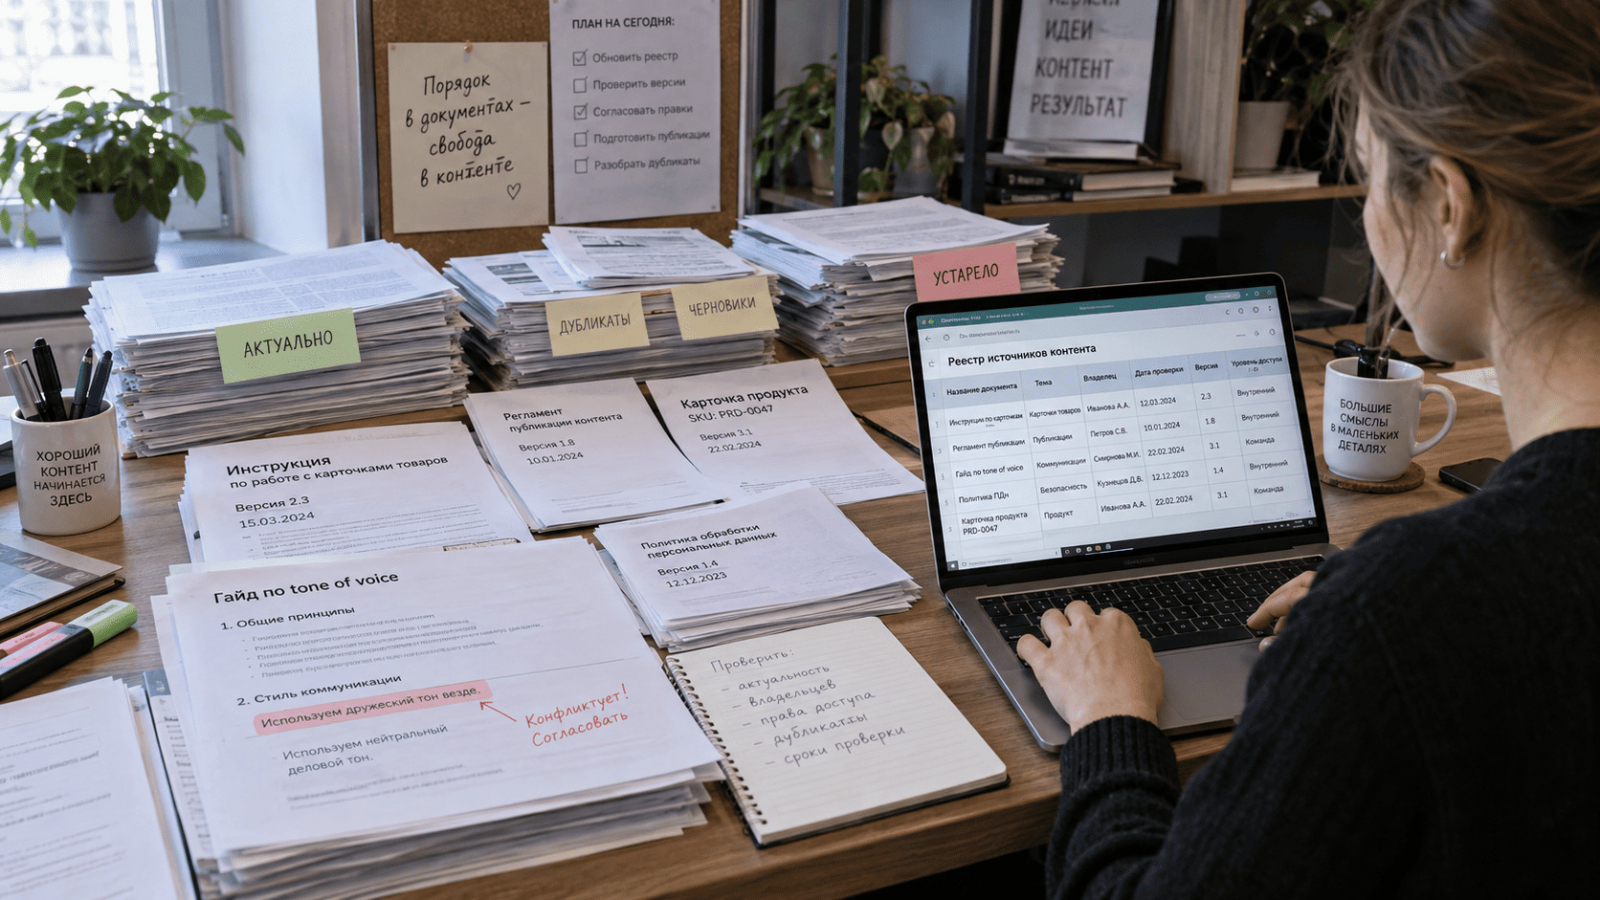
Начните с реестра. Для каждого источника укажите название, тему, владельца, дату проверки, аудиторию, уровень доступа и статус. Архивные материалы вынесите отдельно. Если два документа противоречат друг другу, не загружайте оба до решения владельца.
Один документ должен закрывать понятную тему. Длинный файл со множеством несвязанных правил сложнее искать. Используйте содержательные заголовки, короткие разделы, списки шагов и явные условия. Формулировка «действует для тарифа X с 1 сентября 2026 года» полезнее общей фразы без области применения.
Текст внутри сканов нужно проверить после распознавания. Таблицы снабдите заголовками, единицами и пояснениями. Сложные схемы продублируйте текстовым описанием. Уберите колонтитулы, повторяющиеся меню и декоративные блоки, которые мешают поиску.
Добавьте метаданные: продукт, регион, язык, аудитория, тип документа, версия и дата. В системах с фильтрацией они помогают не смешивать условия разных рынков и тарифов.
Пошаговое подключение базы знаний
1. Определите задачу и границы
Зафиксируйте, кто задаёт вопросы, по каким темам помощник отвечает и чего делать не должен. Отдельно опишите чувствительные темы, где требуется сотрудник: оплата, персональные сведения, здоровье, право, безопасность или индивидуальные обещания клиенту.
2. Выберите основной источник
Если материалов мало и они редко меняются, начните с файлов. Для корпоративной папки выбирайте синхронизацию с правами. Для публичного чат-бота с большим help-центром подойдёт платформа с RAG и журналом поиска.
3. Очистите и разметьте материалы
Удалите дубли, черновики и просроченные правила. Назначьте владельца и срок пересмотра. Проверьте извлечение текста из PDF, изображений и таблиц. Не добавляйте личные или коммерческие сведения, если они не нужны для ответов.
4. Задайте инструкцию помощнику
Укажите, что ответы строятся только по разрешённым источникам. Попросите показывать название документа и подтверждающий фрагмент. Если сведений недостаточно или источники противоречат друг другу, помощник должен сообщить об этом и передать вопрос человеку.
5. Настройте поиск
Для визуальной платформы сначала используйте настройки по умолчанию, затем проверяйте их на тестах. Слишком мало найденных фрагментов ведёт к пропускам, слишком много — к шуму и росту стоимости. Фильтры по продукту, региону и версии часто дают больший эффект, чем увеличение объёма контекста.
6. Проведите тестирование
Подготовьте обычные, сложные, неоднозначные и запрещённые вопросы. Для каждого заранее укажите ожидаемый источник и допустимый ответ. Проверяйте не красоту формулировки, а найденный документ, точность условий, цитату и корректный отказ.
7. Назначьте обновление
Определите, кто меняет документ, кто проверяет его и как обновление попадает в индекс. После важной правки повторите контрольные вопросы. В журнале сохраните дату, версию, результат теста и найденные ошибки.
Этот план удобно подготовить в MashaGPT: одна модель составит реестр, другая найдёт противоречия, третья сформирует вопросы для проверки. Итоговый доступ к документам и правила хранения настраиваются уже в выбранной платформе.
Какие сервисы подходят для подключения знаний
Пользовательские GPTs
В собственный GPT можно добавить инструкции, файлы знаний и выбранные возможности. Этот вариант подходит для справочника команды, помощника по продукту или работы с ограниченным комплектом документов. Создание и редактирование GPT зависит от тарифа и настроек рабочей области.
Отделяйте поведение от материалов: в инструкции задайте правила ответа, а в знания загрузите источники. Попросите модель цитировать документ или раздел и проверьте, как она отвечает при отсутствии сведений.
Claude Projects
Проекты Claude объединяют чаты, инструкции и базу знаний по одной теме. Можно загрузить документы, текст и код. При росте объёма сервис автоматически использует RAG для поиска по материалам.
Claude Projects удобны для исследовательской работы, редакции, продуктовой документации и анализа внутренних материалов. Проверьте доступ участников к проекту и не смешивайте документы с разными уровнями конфиденциальности.
Gemini Gems и Gemini Notebook
В Gem можно добавить файлы с устройства или Google Drive и задать постоянную инструкцию. Это подходит для персонального помощника или повторяющейся задачи. Цитаты по файлам можно показывать в ответах, что полезно для проверки.
Gemini Notebook лучше подходит для изучения набора источников. Он отвечает по выбранным материалам и показывает цитаты с переходом к фрагменту. Такой режим удобен для анализа отчётов, исследований, регламентов и учебных документов.
Microsoft Copilot Studio
Copilot Studio поддерживает загруженные файлы, сайты, SharePoint, OneDrive for Business, Dataverse, Salesforce, ServiceNow, Confluence и другие источники в зависимости от среды. Корпоративные подключения могут учитывать разрешения конкретного пользователя.
Платформа подходит организациям с Microsoft 365 и требованиями к администрированию. Перед публикацией проверьте аутентификацию, область источника, отображение цитат и поведение веб-поиска. Последний способен добавить сведения вне утверждённой базы.
Dify
Dify позволяет создать готовую базу, настроить собственный процесс обработки или подключить внешнее хранилище через API. В интерфейсе доступны управление фрагментами, метаданные и тест извлечения.
Инструмент полезен для собственного приложения или внутреннего портала. Начните с небольшой коллекции и контрольных запросов. Меняйте стратегию поиска только после выявленной проблемы, фиксируя результат до и после настройки.
Voiceflow
Voiceflow ориентирован на клиентских и разговорных агентов. База знаний включается как инструмент, после чего можно настраивать условие вызова, переписывание запроса, число фрагментов, фильтры и показ ссылок на источники.
Сервис подходит для сайта, поддержки и диалоговых сценариев с передачей оператору. Фильтры особенно полезны, если один бот обслуживает несколько продуктов, регионов или тарифов.
Дополнительные решения можно сравнить в каталоге лучших нейросетей, а требования к будущей базе проверить через MashaGPT.
10 промптов для подготовки базы знаний
1. Паспорт базы
Роль: управляющий корпоративными знаниями.Задача: определи цель базы и найди недостающие решения.Исходные данные: аудитория [описание], вопросы [список], источники [список], ограничения [список].Критерии: разделить известное, предположения и пробелы; не придумывать доступы.Формат ответа: цель, пользователи, темы, источники, ограничения и вопросы.
2. Реестр источников
Роль: координатор документации.Задача: подготовь реестр материалов для подключения.Исходные данные: документы [список], владельцы [роли], даты [данные], аудитории [список].Критерии: отметить дубли, черновики, устаревшие версии и неизвестный статус.Формат ответа: источник, тема, владелец, версия, доступ, риск и действие.
3. Поиск противоречий
Роль: независимый редактор базы знаний.Задача: найди несовместимые правила в приложенных материалах.Исходные данные: документы [файлы], тема [описание], дата проверки [значение], приоритеты [список].Критерии: приводить фрагмент каждого источника, не выбирать версию без основания.Формат ответа: вопрос, источник A, источник B, противоречие, владелец и решение.
4. Подготовка документа
Роль: информационный редактор.Задача: перестрой материал для точного поиска без добавления новых фактов.Исходные данные: документ [текст], аудитория [описание], частые вопросы [список], формат [значение].Критерии: сохранить смысл, добавить ясные заголовки, условия, исключения и дату действия.Формат ответа: новая структура, изменённые фрагменты, пропуски и вопросы владельцу.
5. Метаданные
Роль: архитектор информационной системы.Задача: предложи минимальную схему метаданных для фильтрации.Исходные данные: источники [список], продукты [список], регионы [список], права [описание].Критерии: использовать наблюдаемые поля, исключить лишние персональные сведения.Формат ответа: поле, тип, допустимые значения, источник, обязательность и пример.
6. Инструкция помощнику
Роль: проектировщик AI-помощников.Задача: подготовь правила ответа по утверждённой базе.Исходные данные: цель [текст], источники [список], запреты [список], формат цитаты [описание].Критерии: запретить догадки, описать конфликт источников, отсутствие ответа и передачу человеку.Формат ответа: роль, порядок поиска, правила ответа, цитирование, отказ и эскалация.
7. Контрольные вопросы
Роль: инженер по качеству поиска.Задача: составь тестовый набор для базы знаний.Исходные данные: темы [список], документы [файлы], риски [список], аудитория [описание].Критерии: включить прямые, перефразированные, неоднозначные, отсутствующие и запрещённые вопросы.Формат ответа: вопрос, ожидаемый источник, обязательные условия, допустимый ответ и ошибка.
8. Разбор плохого ответа
Роль: аналитик RAG-систем.Задача: определи, на каком этапе возникла ошибка.Исходные данные: вопрос [текст], найденные фрагменты [список], ответ [текст], эталон [текст].Критерии: разделить проблему источника, поиска, инструкции и генерации.Формат ответа: симптом, этап, доказательство, гипотеза, тест и исправление.
9. План обновления
Роль: владелец базы знаний.Задача: создай регламент актуализации источников.Исходные данные: реестр [данные], владельцы [роли], изменчивые темы [список], события [список].Критерии: назначить триггер, проверяющего, повторную индексацию и контрольные тесты.Формат ответа: источник, сигнал, действие, владелец, срок, тест и журнал.
10. Решение о запуске
Роль: контролёр качества AI-сервиса.Задача: оцени готовность базы к ограниченному пилоту.Исходные данные: тесты [результаты], ошибки [список], права [описание], регламент [текст].Критерии: проверить точность поиска, цитаты, отказы, доступы, обновление и ручной выход.Формат ответа: критерий, статус, доказательство, блокер, обязательная правка и решение.
Эти шаблоны можно запускать через MashaGPT до загрузки документов в целевой сервис: так легче исправить структуру источников до настройки поиска.
Частые ошибки
- Первая ошибка — загружать всё хранилище сразу. Чем больше дублей, архивов и черновиков, тем выше шум. Начните с одной темы и проверенного набора.
- Вторая ошибка — смешивать инструкцию и знания. Правила поведения храните в системной инструкции, факты и процедуры — в документах.
- Третья ошибка — тестировать только точные заголовки. Пользователи формулируют вопросы разговорно, с ошибками и без внутренних терминов. Добавляйте перефразированные запросы.
- Четвёртая ошибка — оценивать лишь итоговый текст. Проверяйте найденный фрагмент, источник, версию и условия. Хорошо написанный ответ может использовать ошибочный документ.
- Пятая ошибка — забыть обновление. У каждой изменчивой темы должен быть владелец, событие для пересмотра и контрольный вопрос после переиндексации.
Вопросы и ответы
⬇︎ Можно ли подключить базу знаний без программирования?
Да. Для небольшого набора подойдут GPTs, Claude Projects, Gemini Gems или Gemini Notebook. Для сайта и корпоративного помощника можно использовать визуальные платформы вроде Copilot Studio, Dify или Voiceflow.
⬇︎ Какие файлы лучше загружать?
Подходят текстовые документы с ясными заголовками, датами, условиями и владельцами. PDF со сканами, сложные таблицы и изображения нужно проверить после извлечения текста.
⬇︎ Чем база знаний отличается от длинного промпта?
Промпт задаёт поведение и текущую задачу. База хранит справочные материалы, из которых система извлекает подходящие фрагменты по запросу.
⬇︎ Что такое RAG простыми словами?
Это поиск по подключённым материалам перед ответом. Нейросеть получает найденные фрагменты как контекст и формирует результат на их основе.
⬇︎ Как заставить нейросеть отвечать только по документам?
Добавьте явное правило, требуйте цитату и настройте отказ при отсутствии сведений. Затем проверьте вопросы, ответа на которые в базе заведомо нет. Абсолютную гарантию одна инструкция не даёт.
⬇︎ Как часто обновлять базу?
Частота зависит от темы. Цены, условия и расписания проверяют при каждом изменении, стабильные регламенты — по графику. После правки нужно обновить индекс и повторить тесты.
⬇︎ Как защитить конфиденциальные сведения?
Используйте минимальные права, отдельные коллекции для разных аудиторий и корпоративные настройки хранения. Не загружайте лишние сведения, проверяйте договорные условия сервиса и тестируйте доступ под разными ролями.
Итог
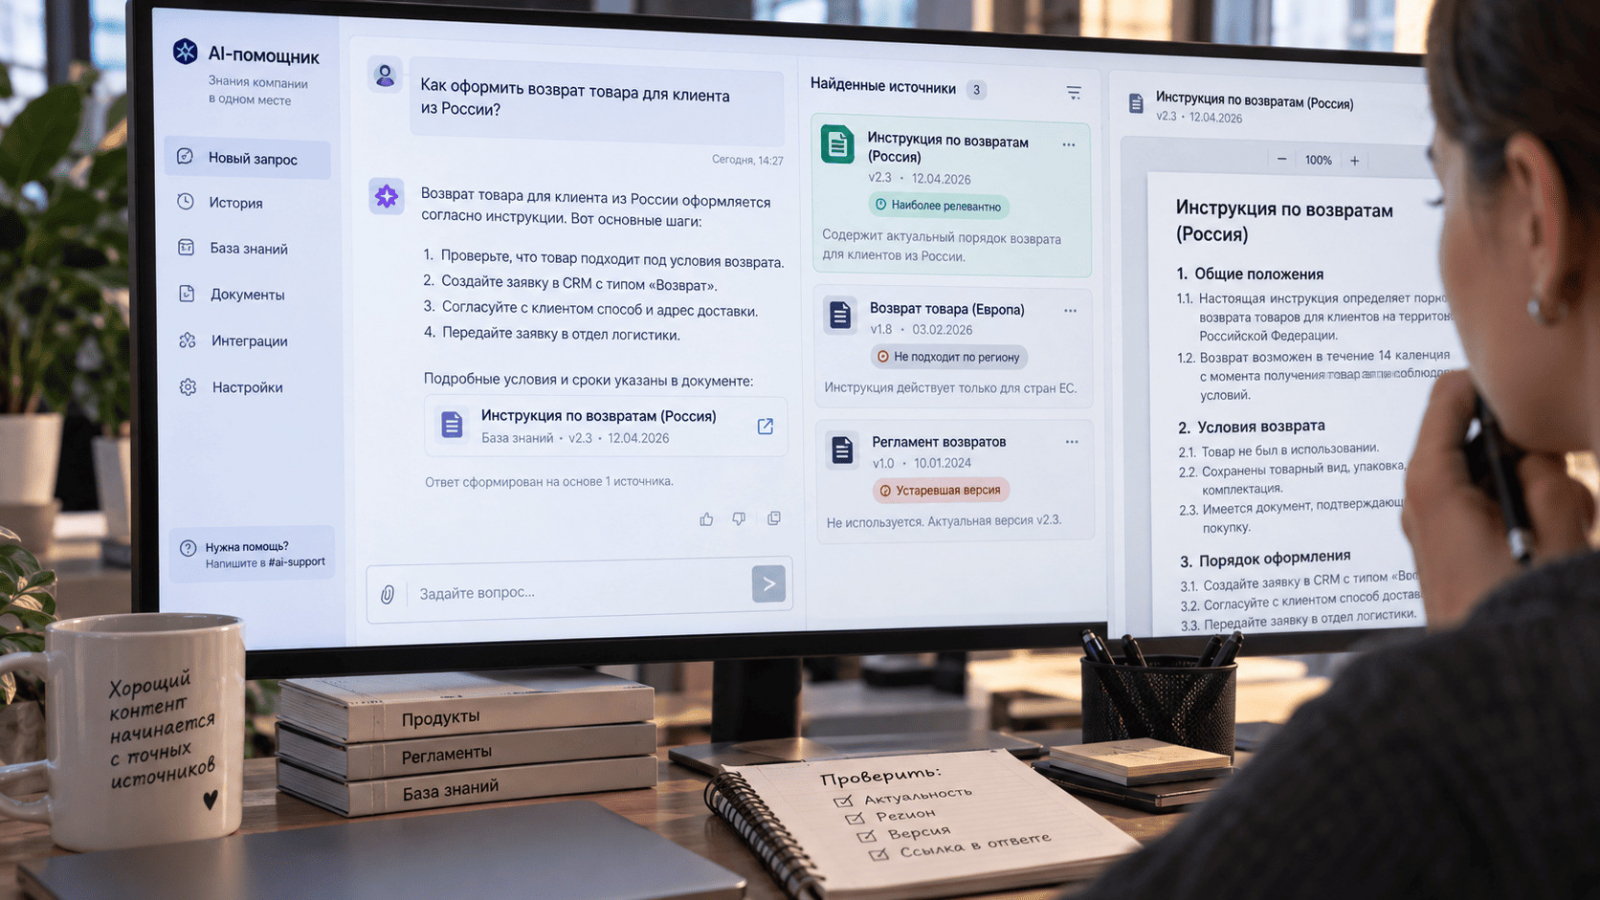
Подключение базы знаний к нейросети начинается с документов. Выбор модели идёт после подготовки источников. Сначала удалите дубли и противоречия, назначьте владельцев и метаданные, затем выберите загрузку файлов, синхронизацию источника или собственную RAG-систему. После настройки проверяйте поиск, цитаты, отказ и доступы на реальных вопросах. Подготовить реестр, инструкцию и тестовый набор можно через MashaGPT.