Лучшие нейросети для поиска научных статей в 2026 году
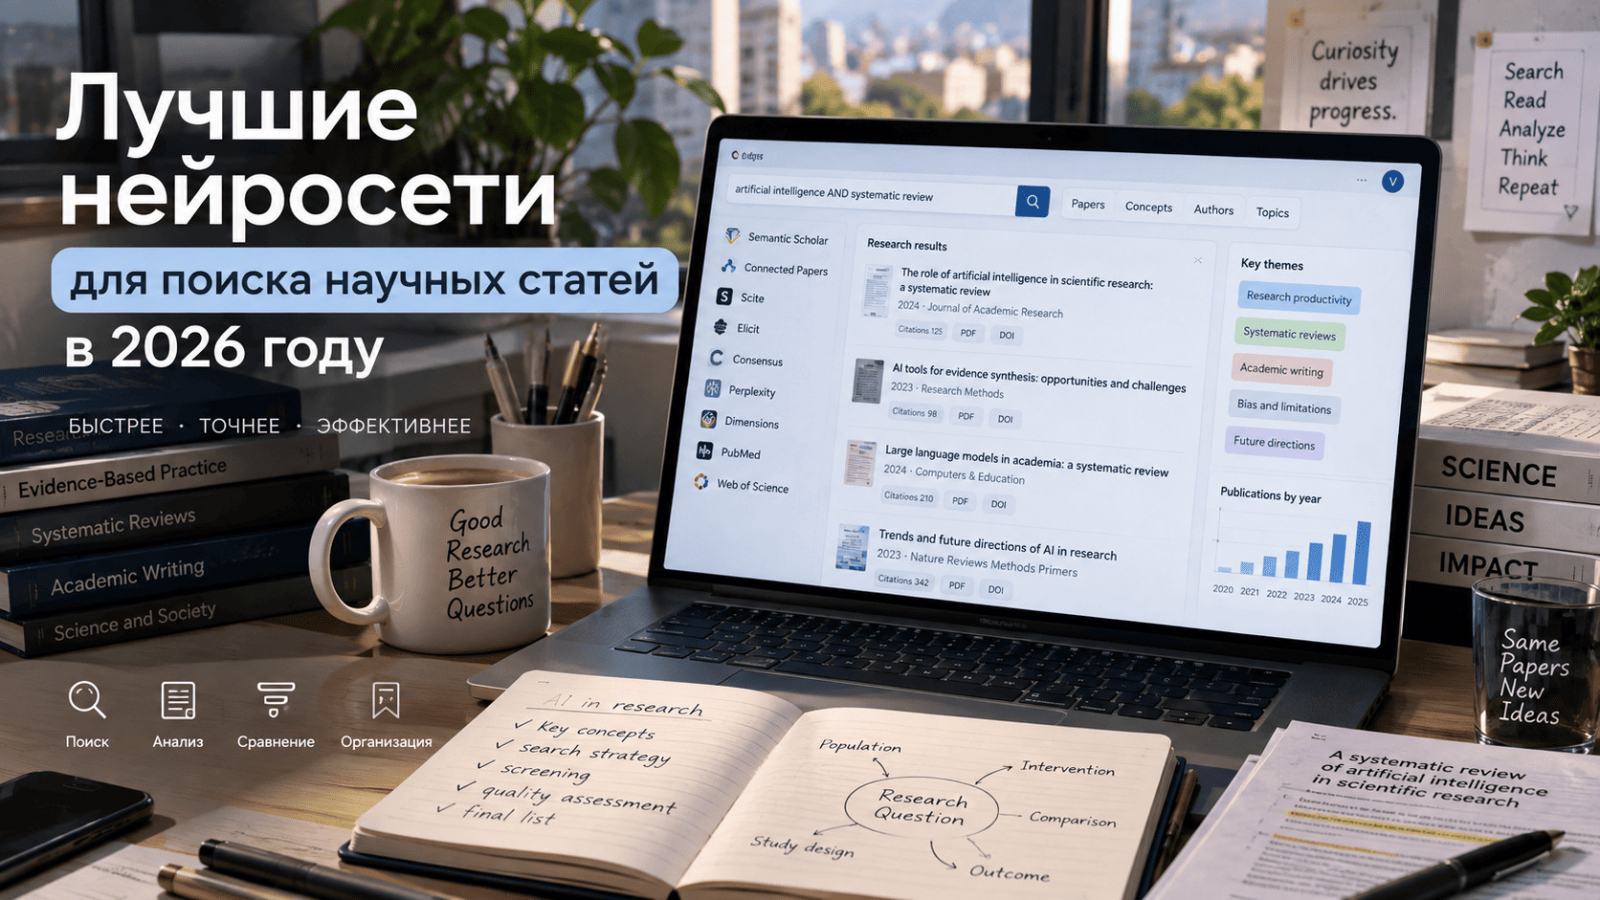
Нейросети помогают сформулировать исследовательский вопрос, найти публикации по смыслу, пройти по сети цитирований и собрать материалы для обзора. Главный риск — принять сгенерированную ссылку за реальную работу. В MashaGPT удобно уточнить терминологию, подготовить поисковые запросы и сравнить уже найденные статьи, сохраняя проверку библиографических данных за исследователем.
Короткий ответ: какой сервис выбрать
Для ответа на вопрос с подборкой исследований подходит Consensus. Elicit удобен для поиска эмпирических работ, скрининга и извлечения данных. Semantic Scholar даёт широкий академический поиск, рекомендации и навигацию по цитированиям. Scite показывает контекст цитирования и помогает увидеть, поддерживает ли последующая работа утверждение или спорит с ним. ResearchRabbit и Connected Papers строят карты связей. SciSpace объединяет поиск, сравнение и чтение PDF. MashaGPT полезна до поиска и после него: формулирует запросы, переводит термины и анализирует предоставленные материалы.
Выбирайте инструмент по этапу:
- первый обзор темы — Consensus, Semantic Scholar или SciSpace;
- систематический поиск и скрининг — Elicit вместе с профильными базами;
- поиск ключевых предшественников и новых продолжений — ResearchRabbit либо Connected Papers;
- оценка того, как работу цитируют другие авторы, — Scite;
- чтение и сопоставление найденных PDF — SciSpace, Elicit или MashaGPT;
- разработка словаря запроса на русском и английском — MashaGPT.
Для диссертации, клинического обзора, стандарта или регуляторного решения одной нейросети недостаточно. Методика должна включать профильные библиографические базы, документированный запрос, критерии отбора и ручную проверку.
Чем AI-поиск отличается от обычного
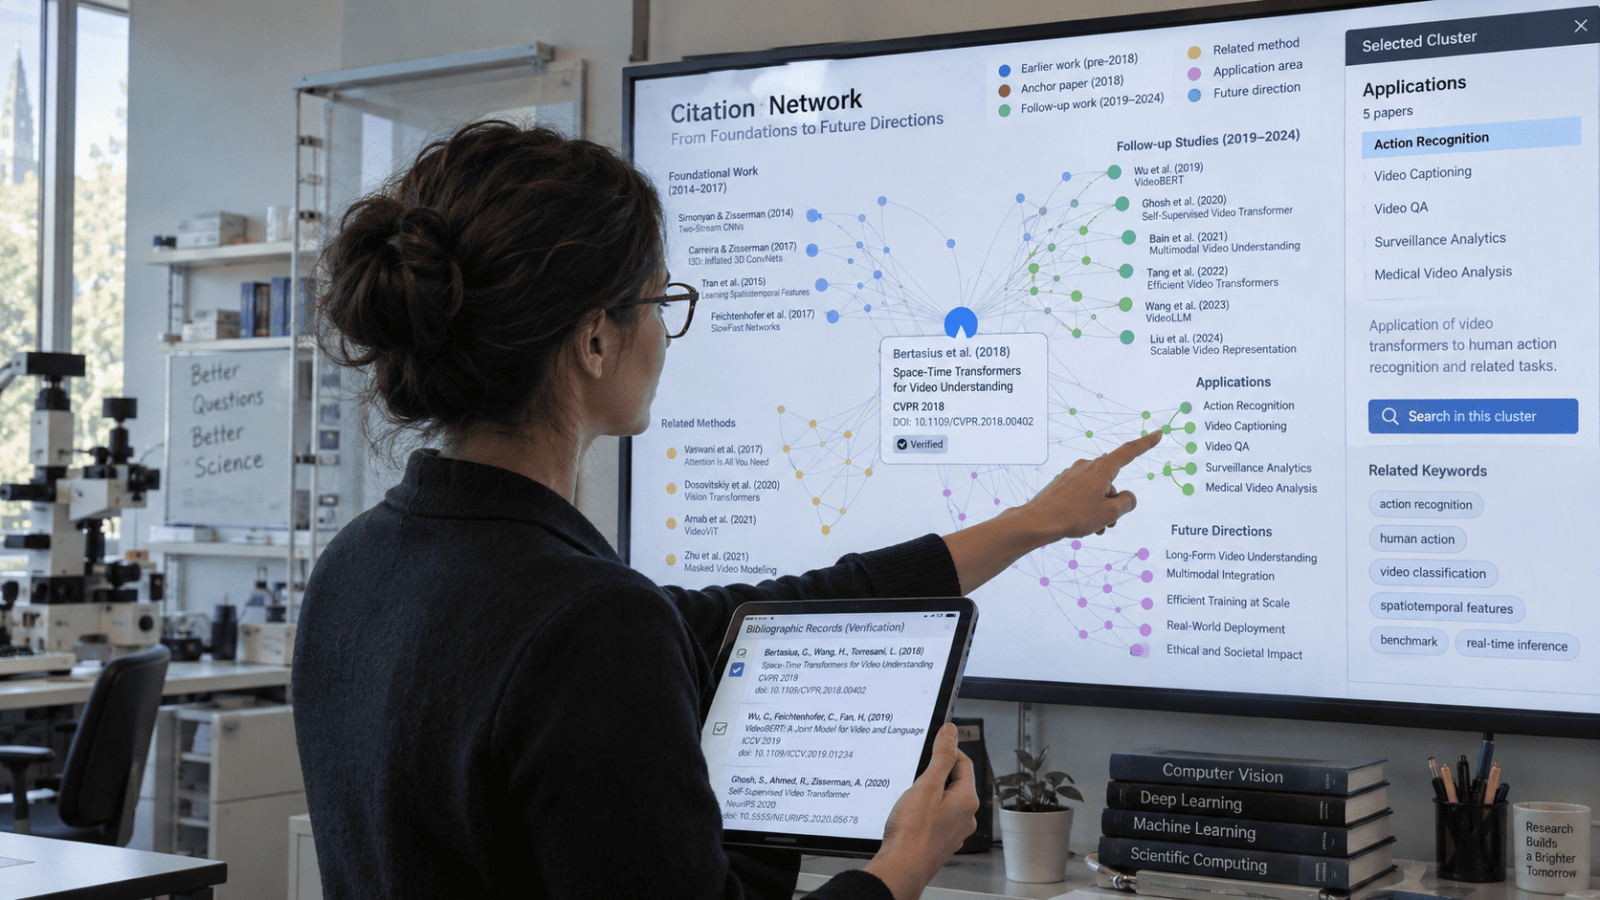
Классическая поисковая строка опирается на слова, операторы и фильтры. Семантический поиск пытается понять смысл вопроса и способен найти работу с другой терминологией. Это полезно на старте, когда исследователь ещё не знает словарь области. Однако широкий смысловой поиск хуже воспроизводится без сохранённой истории и может скрывать логику ранжирования.
Хороший процесс соединяет оба подхода. Сначала естественный вопрос помогает найти несколько сильных публикаций. Из их названий, ключевых слов и предметных рубрик собирают словарь. Затем формируют точный запрос с синонимами, датами, типами работ и областью исследования. После поиска выполняют обратное и прямое прослеживание цитирований.
AI-аннотация экономит время, но не заменяет чтение. Короткое резюме способно потерять ограничения выборки, условия эксперимента и размер эффекта. Решение о включении принимают по полному тексту или минимум по оригинальному абстракту, если протокол допускает такой этап.
Как сформулировать поисковый вопрос
Начните с объекта, воздействия или метода, сравнения и результата. Для медицинской темы часто подходит структура PICO, для качественных исследований — SPIDER, для широкого обзора — PCC. Название схемы менее важно, чем ясные границы: кто или что изучается, в каких условиях и какие результаты нужны.
Далее составьте двуязычный словарь. Включите научные термины, старые названия, аббревиатуры, варианты написания и контролируемую лексику выбранной базы. Отдельно запишите слова, которые создают шум. Не копируйте запрос из одной базы в другую без адаптации: синтаксис полей и операторов различается.
До запуска задайте критерии включения и исключения: годы, языки, дизайн исследования, популяция, тип публикации, нужный исход и минимальный набор данных. Критерии фиксируют заранее, чтобы результаты не подгонялись под желаемый вывод. Рабочие версии вопроса и словаря удобно сопоставлять в MashaGPT, а точный синтаксис проверять в справке каждой академической базы.
Лучшие нейросети для поиска научных статей
MashaGPT — подготовка запроса и анализ найденных материалов
MashaGPT полезна как исследовательский помощник вокруг поисковой системы. Модели помогают разложить тему на понятия, подобрать английские термины, создать варианты запроса и сформулировать критерии отбора. После выгрузки статей можно сравнить определения, методы и ограничения.
Через MashaGPT удобно поручить одной модели извлечение тезисов, а другой — проверку соответствия первичному тексту. Не просите придумывать библиографию по памяти. Перед добавлением источника откройте запись издателя или репозитория и сверьте DOI, авторов, название и год.
Consensus — ответы с опорой на научную литературу
Consensus принимает вопрос естественным языком, ключевые слова, логические операторы, название, автора или DOI. Поиск сочетает смысловое и точное совпадение, затем ранжирует результаты с учётом релевантности и некоторых сигналов качества. Ответ сопровождается найденными публикациями.
Сервис удобен для быстрого знакомства с состоянием исследований и сравнения выводов. Режимы углублённого обзора способны анализировать больше работ и доступный полный текст. Итоговая сводка остаётся вторичным представлением: спорное утверждение проверяют в оригинальной статье.
Elicit — поиск и систематический скрининг
Elicit ориентирован на обзоры литературы, особенно в эмпирических областях. Он ищет работы, помогает сформировать критерии, проводить скрининг и извлекать сведения в заданные поля. Для каждого извлечённого элемента полезно смотреть подтверждающую цитату из публикации.
Платные планы расширяют объём обработки и экспорт. Результаты можно передать в менеджер библиографии через RIS или BIB. При строгом систематическом обзоре автоматическое решение о включении проверяют вручную, а поиск дублируют в утверждённых базах.
Semantic Scholar — широкий поиск и рекомендации
Semantic Scholar — бесплатный AI-сервис от Ai2 для научной литературы. Поиск поддерживает фильтры по области, датам, авторам, типам публикаций, журналам и конференциям. На карточках части работ есть краткие TLDR, списки ссылок и цитирующих публикаций.
Сохранённые статьи можно организовать в папки и использовать для персональных рекомендаций. Research Feeds учатся на оценках релевантности, поэтому подходят для наблюдения за новой литературой. Краткие AI-описания и классификация цитат помогают расставить приоритеты, но не доказывают качество исследования.
Scite — контекст и характер цитирования
Scite связывает публикацию с фрагментами, где её цитируют. Smart Citations помогают увидеть, служит ли ссылка фоном, поддерживает утверждение или содержит противоположный результат. Это полезнее простого счётчика цитирований, который не раскрывает отношение авторов к работе.
Scite подходит для проверки ключевого тезиса, спорной методики и статьи с большим влиянием. Классификацию AI нужно читать вместе с цитирующим фрагментом и первичной публикацией. Несогласие между исследованиями может объясняться разными выборками, методами или определениями.
ResearchRabbit — развитие темы через сеть связей
ResearchRabbit начинает с одной или нескольких опорных статей и показывает связанные работы, авторов и направления. Алгоритм учитывает действия пользователя и улучшает рекомендации по мере отбора. Коллекции помогают разделять ветви обзора.
Сервис особенно полезен после первичного поиска. Он находит статьи, которые трудно обнаружить одной строкой запроса, и показывает эволюцию темы. Полноту карта гарантировать не может, поэтому её используют как дополнительный канал обнаружения.
Connected Papers — карта похожих публикаций
Connected Papers строит граф вокруг выбранной статьи. Близость узлов отражает сходство, основанное на совместном цитировании и общих библиографических связях. Это не обычное дерево прямых ссылок: рядом могут оказаться работы, которые не цитируют друг друга.
Инструмент помогает быстро увидеть кластеры, ранние основополагающие публикации и более поздние производные работы. Начальная статья сильно влияет на карту. Для устойчивого результата стоит построить несколько графов от разных опорных работ.
SciSpace — поиск, сравнение и чтение PDF
SciSpace объединяет поиск по большой коллекции научных работ, фильтры, AI-сводки, сравнение результатов и диалог с PDF. Пользователь может добавлять поля извлечения, сортировать публикации, сохранять результаты и экспортировать список для дальнейшей работы.
Сервис удобен, когда поиск сразу переходит в чтение и матрицу обзора. Заявления о сравнительном превосходстве продукта лучше оценивать критически, особенно если исследование проведено самим поставщиком. Качество конкретной выдачи проверяют на собственном эталонном наборе запросов.
Проверяемый процесс поиска литературы
Первый этап — протокол. Запишите вопрос, базы, даты поиска, полные строки, фильтры и критерии. Даже для учебного обзора журнал помогает понять, почему статья попала в выборку. Для систематической работы придерживайтесь принятого в дисциплине стандарта отчётности.
Второй этап — разведочный поиск. Найдите несколько известных или обзорных работ, уточните терминологию и проверьте предметные рубрики. Затем запустите адаптированные запросы в нескольких базах. Экспортируйте результаты с идентификаторами и удалите дубли.
Третий этап — скрининг. Сначала проверяют названия и абстракты по заранее утверждённым критериям, затем полные тексты. Для спорных записей сохраняют причину решения. В важных обзорах независимый второй исследователь снижает риск субъективного отбора.
Четвёртый этап — цитатная цепочка. Просмотрите источники ключевых статей и более новые работы, которые их цитируют. Карты ResearchRabbit и Connected Papers ускоряют навигацию, но список проверяют по библиографическим записям.
Последний этап — контроль качества. Проверьте рецензирование, статус препринта, исправления и отзывы о публикации, конфликт интересов, дизайн, выборку и статистику. Цитируемость не равна надёжности, а новизна сама по себе ещё ничего не говорит о качестве.
10 промптов для поиска научных статей
Шаблоны удобно готовить в MashaGPT, затем переносить адаптированные запросы в академические базы. Не добавляйте ссылку в библиографию без проверки первичной записи.
1. Исследовательский вопрос
Роль: методолог научного поиска. Задача: уточни вопрос и предложи подходящую структуру. Исходные данные: тема [описание], дисциплина [название], объект [описание], цель обзора [текст]. Критерии: обозначить границы, единицу анализа и необходимый тип доказательств; не придумывать выводы. Формат ответа: вопрос, компоненты, допущения, неизвестные параметры и уточнения.
2. Словарь терминов
Роль: информационный специалист предметной области. Задача: подготовь двуязычный словарь для поиска. Исходные данные: вопрос [текст], языки [список], известные термины [список], база [название]. Критерии: включить синонимы, аббревиатуры, прежние названия и контролируемую лексику с пометками. Формат ответа: понятие, варианты, язык, статус термина и источник для проверки.
3. Поисковая строка
Роль: библиотекарь по научным базам. Задача: составь черновик запроса для выбранной системы. Исходные данные: словарь [список], база [название], поля [описание], ограничения [список]. Критерии: корректно группировать синонимы и понятия, не выдумывать операторы при неизвестном синтаксисе. Формат ответа: строка, расшифровка блоков, ожидаемый шум и шаг ручной проверки.
4. Критерии отбора
Роль: координатор обзора литературы. Задача: подготовь критерии включения и исключения до скрининга. Исходные данные: вопрос [текст], период [значение], дизайн [список], необходимые результаты [список]. Критерии: каждый критерий должен проверяться по библиографической записи или тексту; исключить оценочные формулировки. Формат ответа: критерий, вид решения, способ проверки, спорный случай и основание.
5. Опорные публикации
Роль: исследователь истории научной темы. Задача: составь план поиска опорных работ без генерации ссылок по памяти. Исходные данные: тема [описание], известные авторы [список], годы [период], базы [список]. Критерии: различать обзор, первичное исследование и методическую работу; требовать проверяемый идентификатор. Формат ответа: поисковый шаг, запрос, ожидаемый тип публикации, метаданные для проверки и причина отбора.
6. Цитатная цепочка
Роль: специалист по библиометрической навигации. Задача: разработай поиск назад и вперёд от опорной статьи. Исходные данные: статья [проверенные метаданные], вопрос [текст], период [значение], инструменты [список]. Критерии: отделить прямое цитирование от тематического сходства, фиксировать дату и путь обнаружения. Формат ответа: направление, источник, фильтр, критерий релевантности и запись в журнале.
7. Скрининг абстрактов
Роль: независимый рецензент литературы. Задача: оцени соответствие записей утверждённым критериям. Исходные данные: названия и абстракты [список], критерии [текст], вопрос [текст]. Критерии: не делать вывод при нехватке сведений, цитировать фрагмент для каждого решения. Формат ответа: запись, решение, подтверждение, неопределённость и причина ручной проверки.
8. Извлечение данных
Роль: аналитик научных публикаций. Задача: извлеки сопоставимые сведения из полных текстов. Исходные данные: статьи [файлы], поля [список], единицы [описание], правила обработки пропусков [текст]. Критерии: не заполнять отсутствующие сведения догадками, приводить цитату и страницу для каждого значения. Формат ответа: статья, поле, значение, единица, подтверждающий фрагмент и статус.
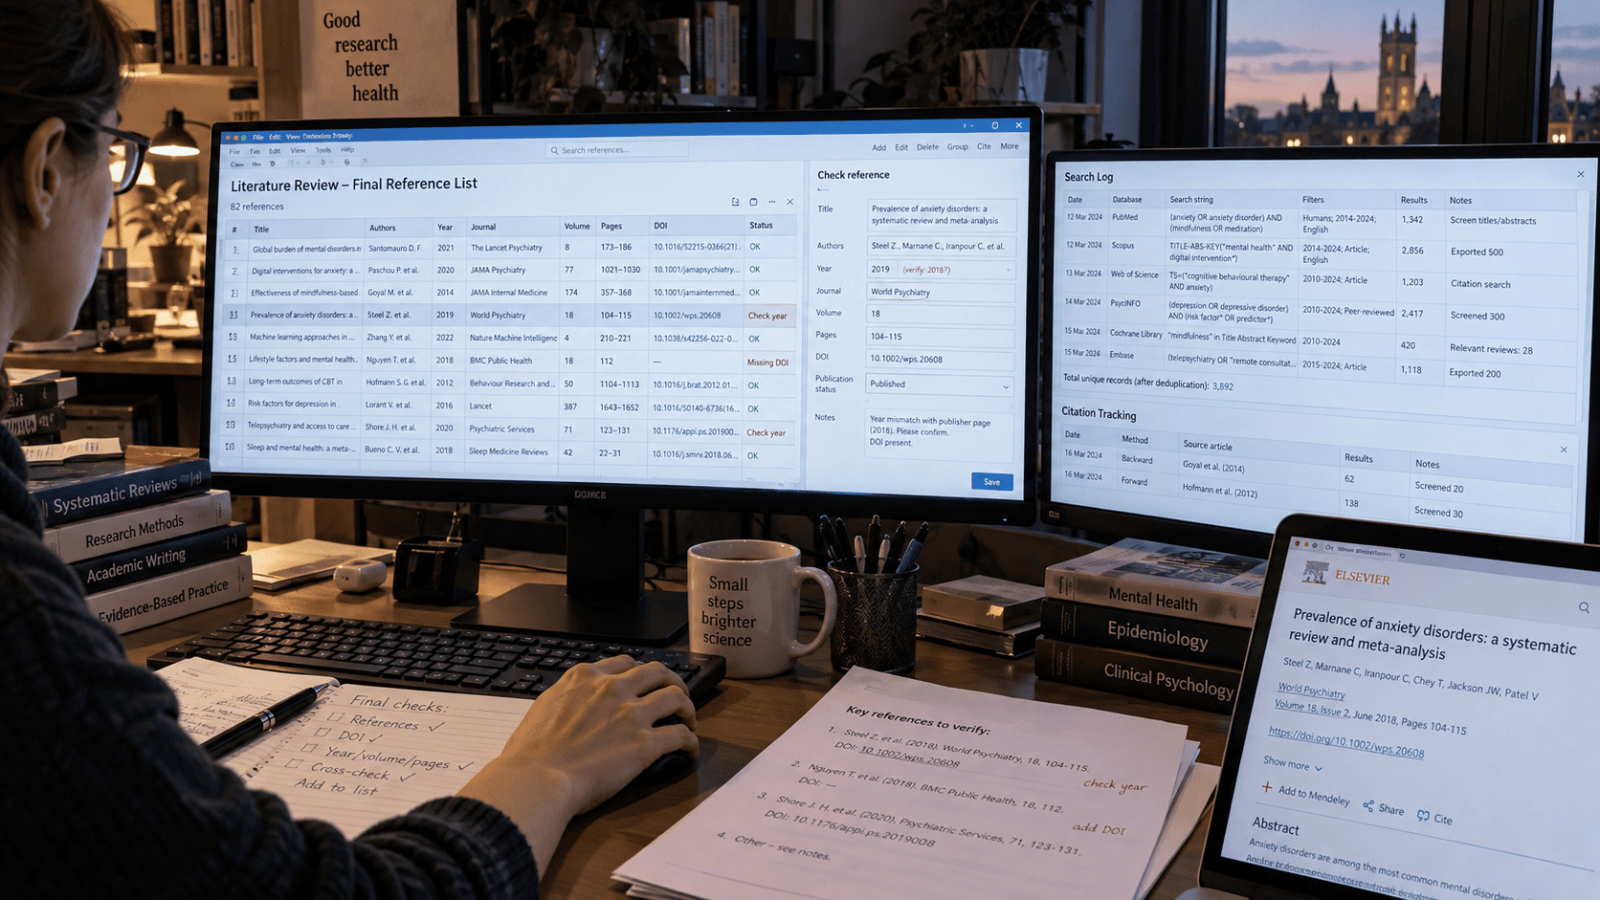
9. Проверка библиографии
Роль: редактор научных ссылок. Задача: найди неполные, противоречивые или подозрительные записи. Исходные данные: библиография [список], стиль [название], идентификаторы [данные]. Критерии: сверять название, авторов, год, журнал, том, страницы, DOI и статус публикации. Формат ответа: запись, проблема, первичный источник проверки, исправление и уровень уверенности.
10. Журнал поиска
Роль: аудитор воспроизводимости обзора. Задача: проверь полноту журнала и подготовь обновление поиска. Исходные данные: базы [список], запросы [текст], даты [список], количество результатов [данные]. Критерии: сохранить точные строки и фильтры, выявить пропущенную базу, период или ветвь цитирования. Формат ответа: этап, зафиксированные данные, пробел, действие, дата повтора и контрольный результат.
Частые ошибки AI-поиска
Первая ошибка — просить универсальную модель назвать двадцать источников без доступа к академическому индексу. Часть ссылок может оказаться вымышленной или смешанной из нескольких работ. Ищите записи в специализированной системе и проверяйте метаданные.
Вторая ошибка — ограничиться одним естественным вопросом. Он удобен для разведки, но не гарантирует полноту. Добавьте синонимы, контролируемую лексику и адаптированные строки для разных баз.
Третья ошибка — отбирать статьи по AI-резюме. Сводка способна потерять дизайн, размер выборки и ограничение. Решение принимают по оригинальному абстракту и полному тексту.
Четвёртая ошибка — считать число цитирований мерой истинности. Цитировать могут для критики, исторического контекста или повторения спорного метода. Изучайте контекст и качество доказательств.
Вопросы и ответы
⬇︎ Какая нейросеть лучше для поиска научных статей?
Для первого ответа удобен Consensus, для систематического поиска — Elicit, для широкой выдачи — Semantic Scholar. ResearchRabbit и Connected Papers дополняют поиск картами связей.
⬇︎ Может ли ChatGPT найти настоящие научные источники?
Универсальная модель полезна для запроса и анализа предоставленных материалов. Библиографию по памяти использовать рискованно. Каждую запись проверяют в академической базе и у издателя.
⬇︎ Как проверить, существует ли статья?
Сверьте точное название, авторов, год, журнал и DOI на первичной странице издателя или в надёжном репозитории. DOI должен вести к той же публикации.
⬇︎ Подходит ли AI для систематического обзора?
Да, как помощник при поиске, скрининге и извлечении. Протокол, профильные базы, независимая проверка решений и прозрачный журнал остаются обязательными.
⬇︎ Как найти новые статьи по одной хорошей работе?
Используйте список её источников, более новые цитирующие публикации и карты ResearchRabbit либо Connected Papers. Записывайте путь обнаружения каждой работы.
⬇︎ Можно ли доверять AI-сводке исследования?
Сводка помогает определить приоритет чтения. Для вывода откройте методы, результаты, ограничения и приложения исходной статьи.
⬇︎ Чем препринт отличается от опубликованной статьи?
Препринт обычно размещён до завершения журнального рецензирования. Проверяйте текущую версию, статус публикации и возможную связь с поздней журнальной работой.
Итог
Лучшие нейросети для поиска научных статей ускоряют формулировку запроса, обнаружение публикаций, навигацию по цитированиям и первичный скрининг. Надёжный обзор требует проверенных метаданных, полного текста и сохранённого протокола. Подготовить запрос и проанализировать найденные материалы можно в MashaGPT, а другие исследовательские сервисы собраны в каталоге лучших нейросетей.