От первого сообщения до восстановления сервиса: как управлять ИТ-инцидентами
Покупатель нажимает «Оплатить», но заказ остаётся неоплаченным. В поддержку поступают новые сообщения с тем же симптомом. Команде нужно понять, какие способы оплаты затронуты, что можно предложить клиентам и кто проверит восстановление. Разберём этот сбой по шагам.
Когда обращение становится инцидентом
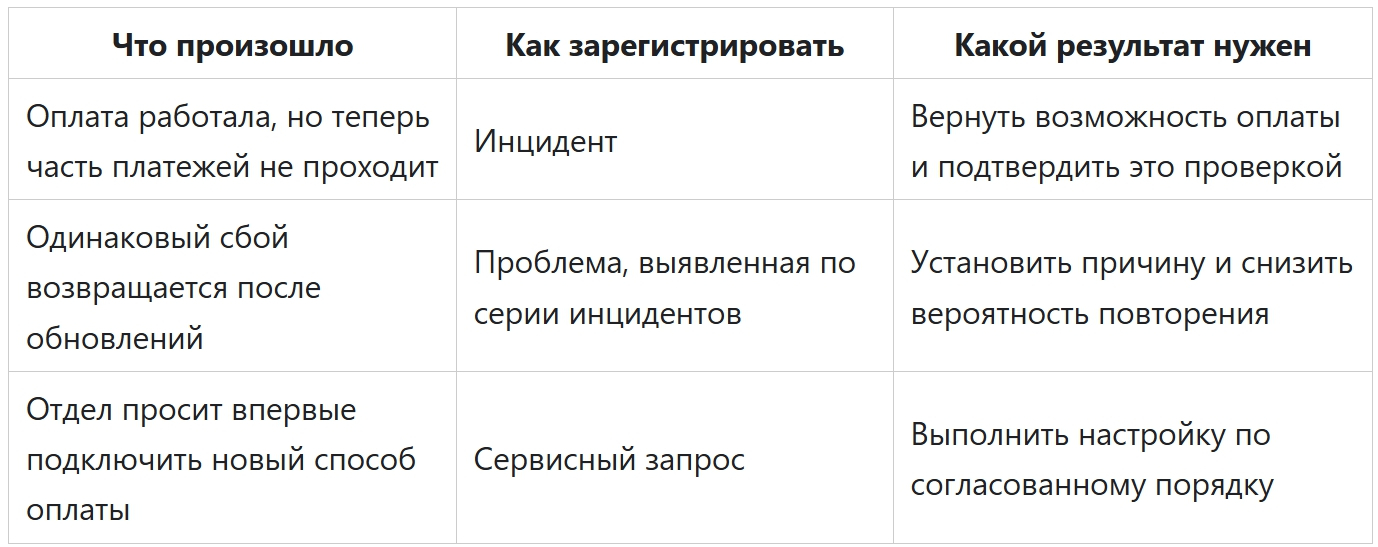
Инцидентом считают незапланированный перерыв в работе ИТ-услуги или ухудшение её качества. Интернет-магазин может открываться, а важная функция — оплата — уже не работать. Управление инцидентами входит в ITSM: оно задаёт порядок реакции, распределяет ответственность и помогает снизить потери от простоя. Пока идёт восстановление, пользователям важно знать, что затронуто и когда появятся новости.
Примеры организации поддержки есть у Julius Meinl, сети ветклиник «Белый клык» и «Центр» и команды Кайтена. Другие сценарии собраны в подборке кейсов.
Шесть этапов работы со сбоем
Сбор сообщений, диагностика и информирование идут параллельно. Общая запись в Kaiten помогает участникам видеть статус и результаты уже выполненных проверок.
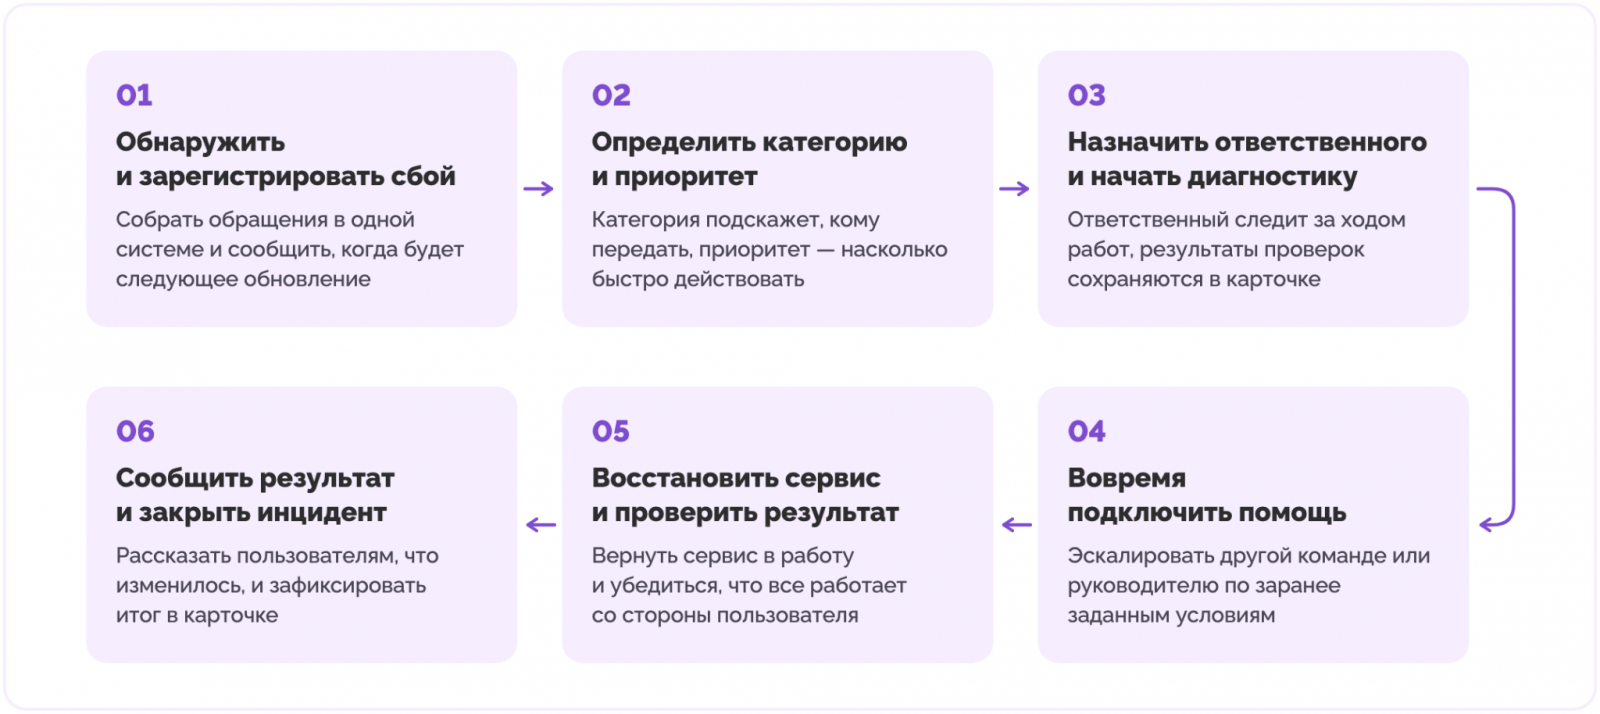
Инцидент проходит от регистрации первого сигнала до проверки, что услуга восстановлена.
1. Зафиксируйте, что перестало работать
Заведите карточку по сигналу мониторинга или первому сообщению. Запишите время, симптомы, видимый текст ошибки, охват и контакт заявителя. Для примера с оплатой достаточно понять, на каком шаге останавливается заказ и для каких пользователей. Остальные детали можно добавить по ходу проверки.
2. Определите категорию, влияние и срочность
Категория направляет заявку команде с нужной компетенцией. Приоритет зависит от последствий и времени, которое бизнес может ждать. Если недоступен один способ оплаты и клиенты могут завершить заказ другим, ситуация отличается от полной остановки продаж. Обновите приоритет, если выяснится, что затронуто больше заказов или обходной путь не помогает.
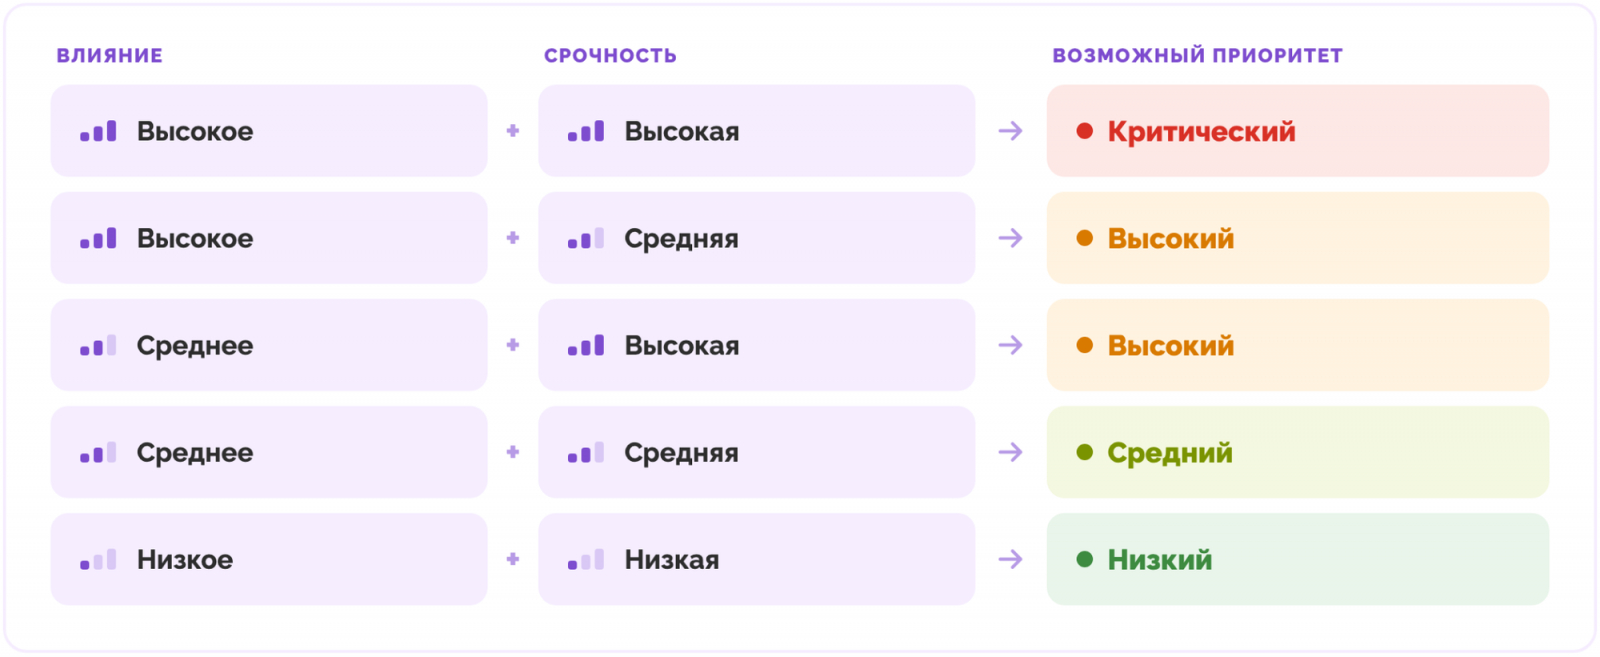
Матрица помогает выбрать приоритет по влиянию на бизнес и срочности восстановления.
В кейсе «Эксперт РА» тип и критичность определяют, кто получит заявку: первая линия или разработчики.
3. Назначьте координатора
Координатор связывает новые сообщения с общей записью, назначает проверки и следит за следующим обновлением. Инженеры в это время уточняют, когда появились ошибки и какие способы оплаты затронуты. Для массовых случаев заранее определите роли. Масштаб показывает число затронутых людей, а критичность — последствия для работы.
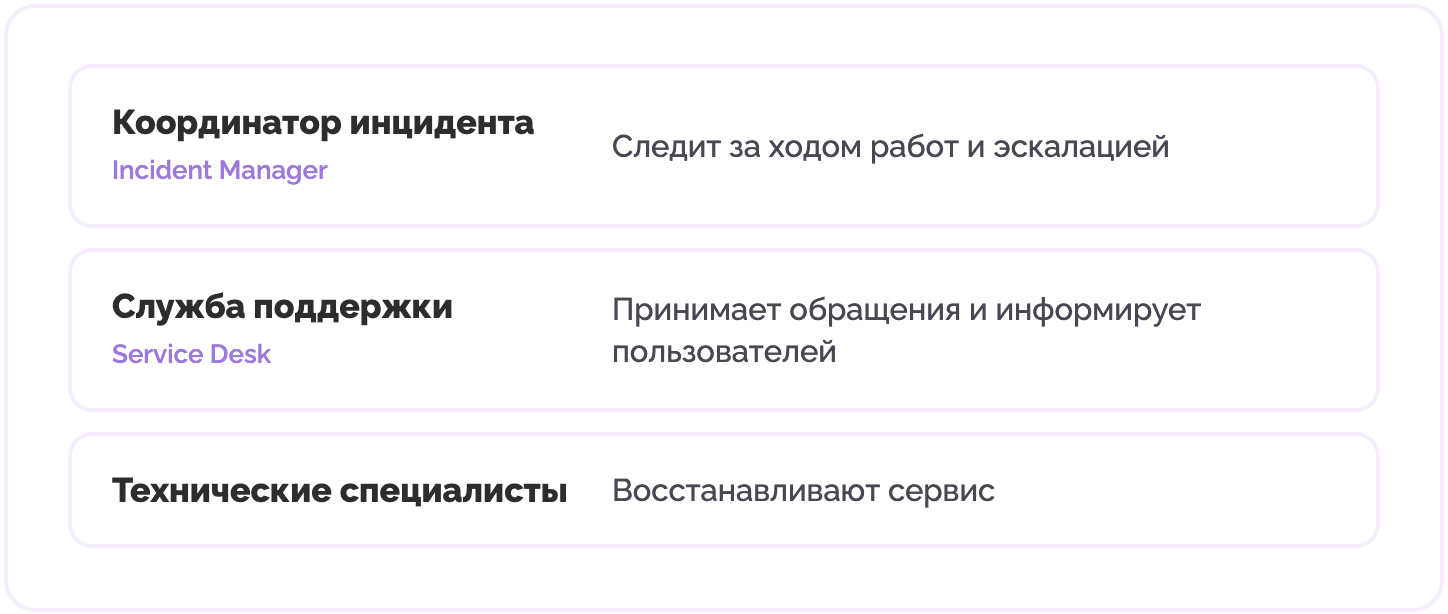
При критическом инциденте техническая работа, координация и связь с пользователями могут идти одновременно.
4. Подключите людей с нужными полномочиями
Функциональная эскалация передаёт работу специалистам другой линии или команды, например отвечающим за платежи. Иерархическая нужна, когда руководителю предстоит выделить ресурсы, повысить приоритет или согласовать действия. Заранее задайте условия передачи: диагностика вышла за отведённое время, охват вырос или восстановление рискует выйти за срок. Как это устроено на практике, показывает кейс Julius Meinl.
5. Верните функцию и повторите пользовательский сценарий
Для сбоя после обновления может подойти откат. При проблеме с инфраструктурой — переключение на резерв, при ошибке конфигурации — исправление настройки. В примере с оплатой временным решением может стать резервный способ. После изменения проведите контрольный платёж, убедитесь, что заказ получил верный статус, и проверьте мониторинг. Расследование причины можно продолжить после восстановления.
6. Сообщите итог и сохраните историю
Обновите статус в том канале, где сообщили о сбое. Укажите, доступна ли оплата и что делать покупателям с незавершёнными заказами. В карточке запишите время восстановления, действие, которое помогло, результаты проверки и оставшиеся поручения. При постмортеме соберите хронологию и меры по улучшению процесса. Пример такого подхода есть в руководстве Google SRE.
Как понять, на каком этапе теряется время
В SLA можно установить отдельно срок принятия в работу и срок восстановления. Например, для критичного сервиса — начать работу в течение 10 минут и восстановить доступ за час. Конкретные цифры зависят от того, какой простой допустим для услуги.
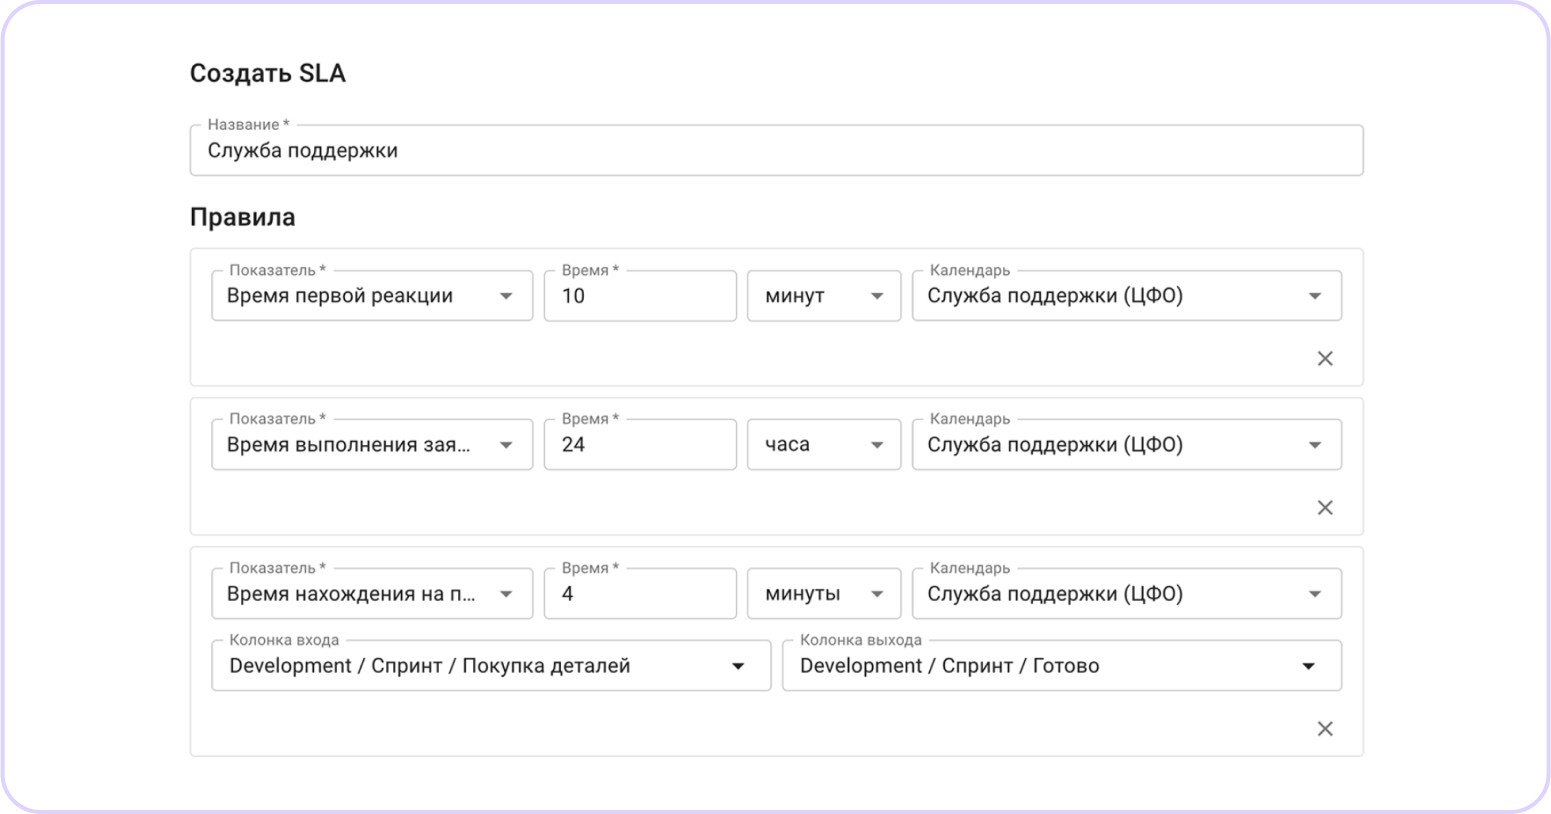
Сроки первой реакции и решения можно контролировать отдельно.
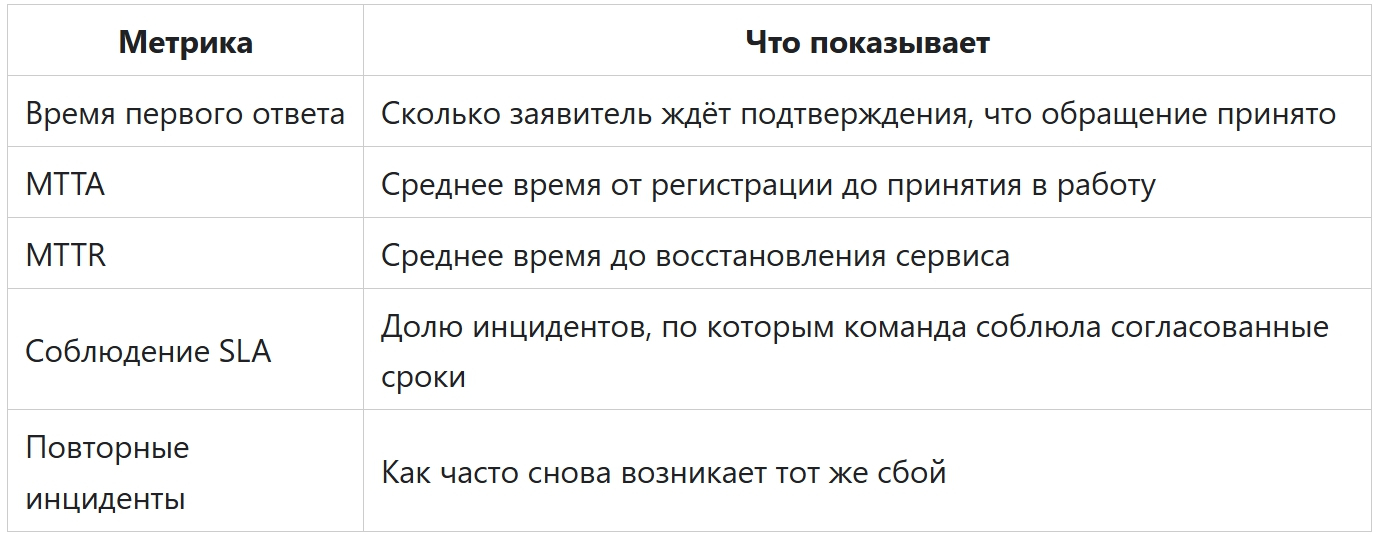
Если выросло время принятия в работу, проверьте очередь и назначение ответственных. Если дольше стало восстановление, разберите диагностику, эскалацию и действия по возврату сервиса. Вместе со средними значениями смотрите долю нарушений и самые долгие случаи.
Как организовать очередь в Kaiten
Подключите Service Desk к почте, мессенджерам и форме. Входящие обращения будут превращаться в карточки, где можно вести переписку и сохранять историю. Описание модуля.
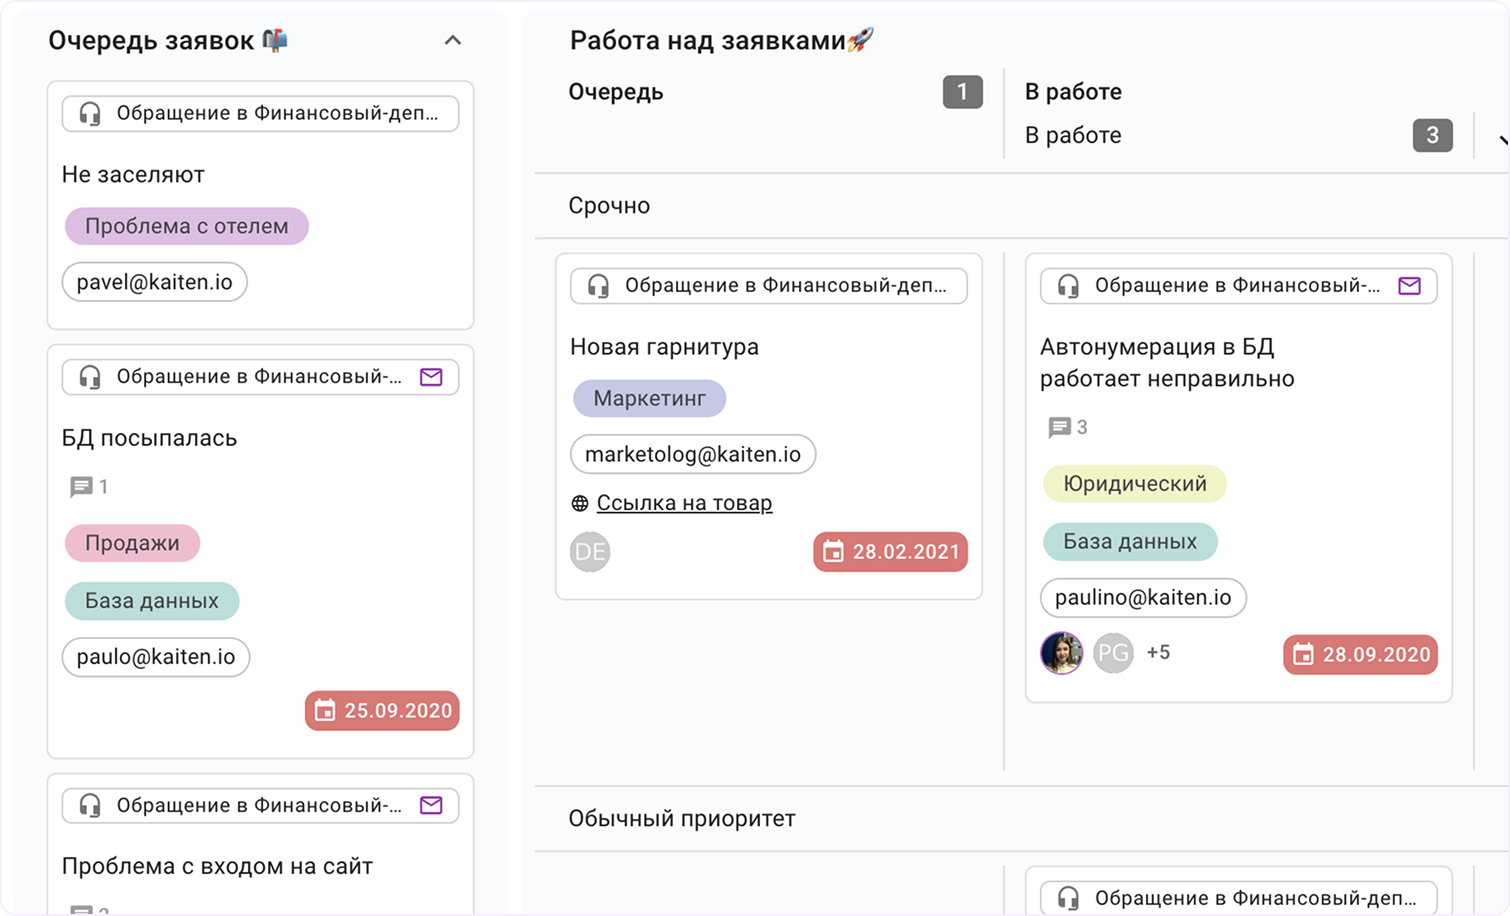
На доске поддержки видно, кто ведёт заявку и на каком этапе она находится.
Создайте колонки «Новые», «Диагностика», «Восстановление», «Проверка» и «Закрыто». Для категории и приоритета добавьте поля, для критичных случаев — отдельную дорожку. Задайте таймеры SLA с рабочим календарём. В качестве основы можно взять шаблон работы с инцидентами.
Оставляйте общий статус в одной карточке. Работу инженеров и других отделов можно вести в связанных задачах, как в кейсе ATI.SU.
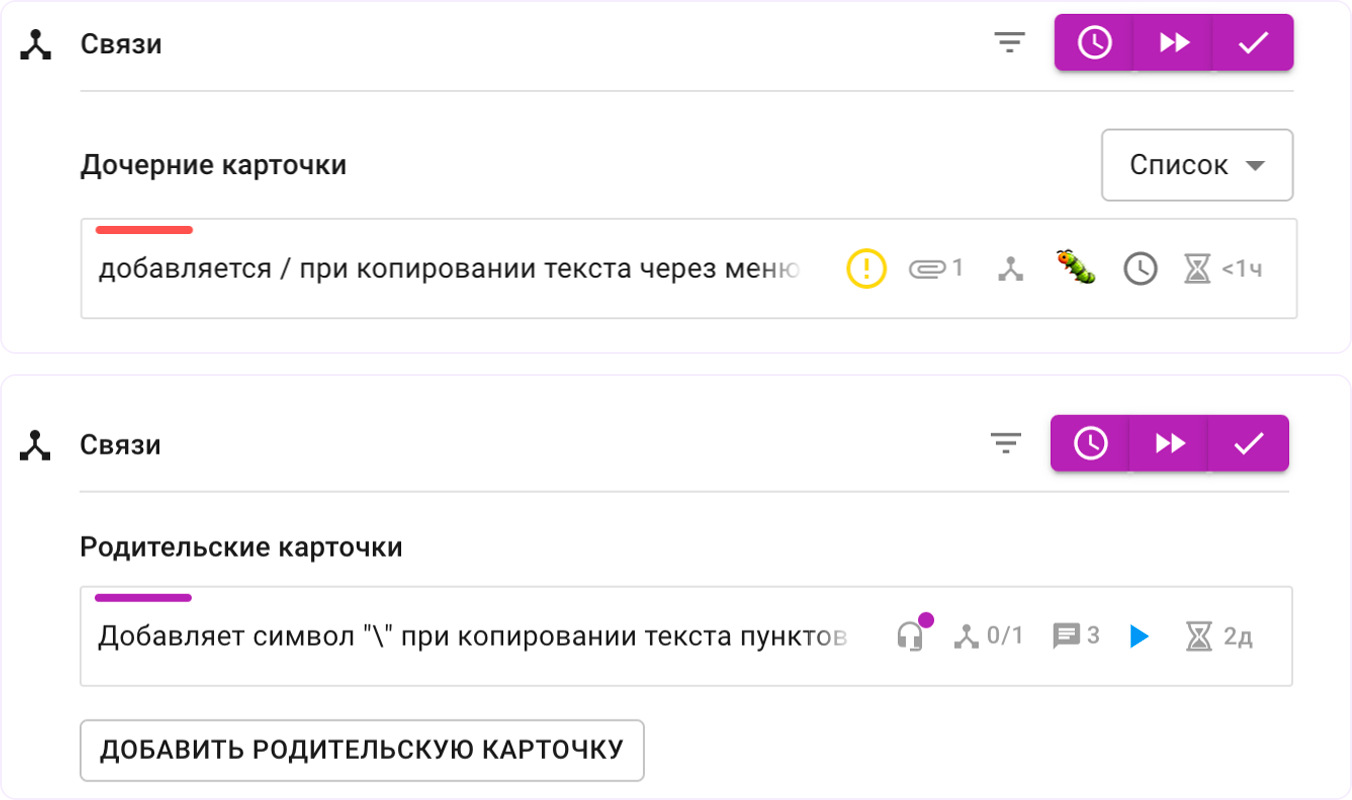
Связи между карточками позволяют видеть поручения разных отделов из записи об инциденте.
Через автоматические правила можно назначать ответственных, запускать SLA и передавать карточки при эскалации. Проверенные способы восстановления сохраняйте в базе знаний. В кейсе сети ветклиник некритичные инциденты закрывали в среднем за 12–13 дней, а 75% всех инцидентов — быстрее чем за 20 дней.
Подключить модуль · Попробовать бесплатно
Что исправить в процессе в первую очередь
- Переносите обращения из личных сообщений в общую очередь вместе с контекстом.
- Определяйте приоритет по влиянию и срочности.
- Называйте время следующего обновления, пока идёт диагностика.
- После восстановления сохраняйте решение и способ проверки. Повторяющиеся сбои передавайте на разбор причин.