Problem Management: что делать, когда ИТ-сбой повторяется
После перезапуска сервис снова отвечает. Из очереди поддержки исчезают жалобы, но через несколько дней возвращаются. Чтобы расследование не пришлось начинать заново после каждого отказа, заведите отдельную запись о проблеме. В ней команда сможет собрать связанные инциденты, проверить версии и проследить, помогло ли исправление.
Когда восстановление сервиса — только первый шаг
В ITIL управлением проблемами называют работу с причинами произошедших и потенциальных инцидентов. Пока идёт сбой, управление инцидентами помогает восстановить услугу. После восстановления можно продолжить расследование в отдельной карточке. Если уязвимое место обнаружили при тестировании или по данным мониторинга, начать работу можно ещё до первого отказа.
Мониторинг даёт сигналы об отклонениях, управление изменениями помогает провести исправление с учётом риска, а база знаний сохраняет результаты для дежурных смен. Насколько готова команда к отказу, показывает практическая проверка: по опросу Linx Cloud и Global CIO в мае 2026 года среди более 100 ИТ-руководителей из России и СНГ 20% компаний регулярно тестировали план аварийного восстановления, обычно один-два раза в год. У 38% были базовые документы без практической проверки, у 42% плана не было.
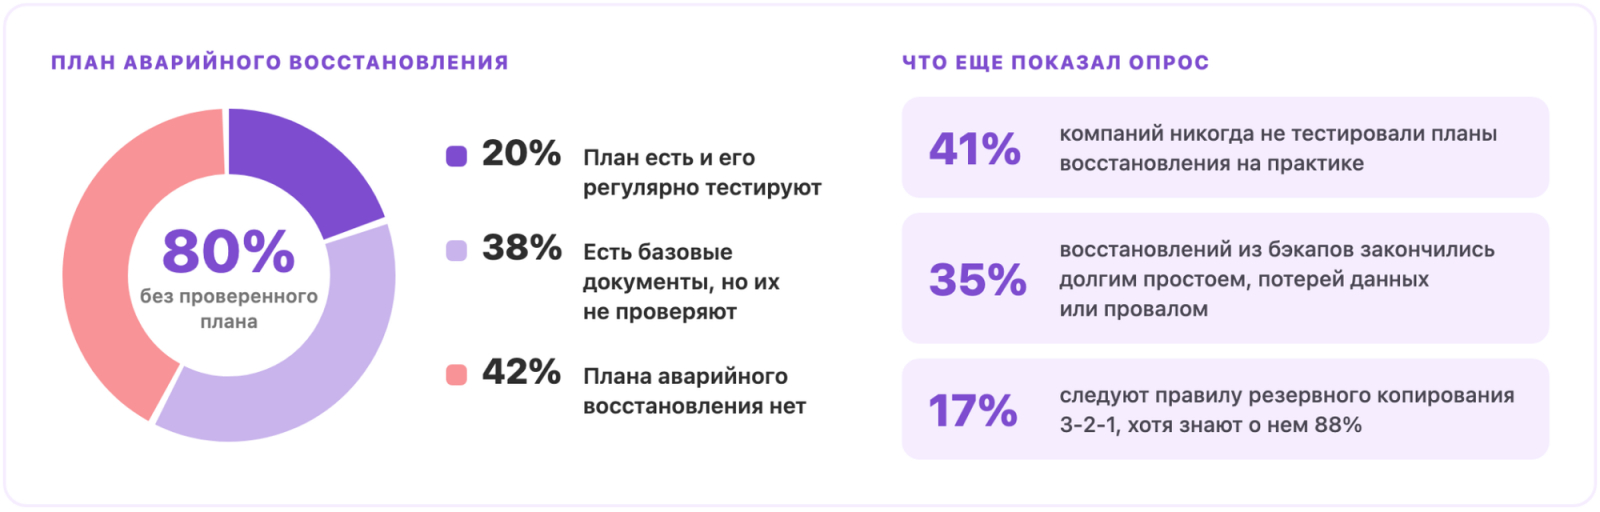
В опросе отдельно учитывали наличие плана и его проверку на практике. Источник исследования.
Представим, что сотрудники теряют доступ к CRM, когда заполняется диск. Ручная очистка помогает на несколько дней. Изучив журнал заданий, команда обнаруживает, что после обновления перестала запускаться автоматическая очистка. На этом примере видно, как связаны инцидент и проблема.
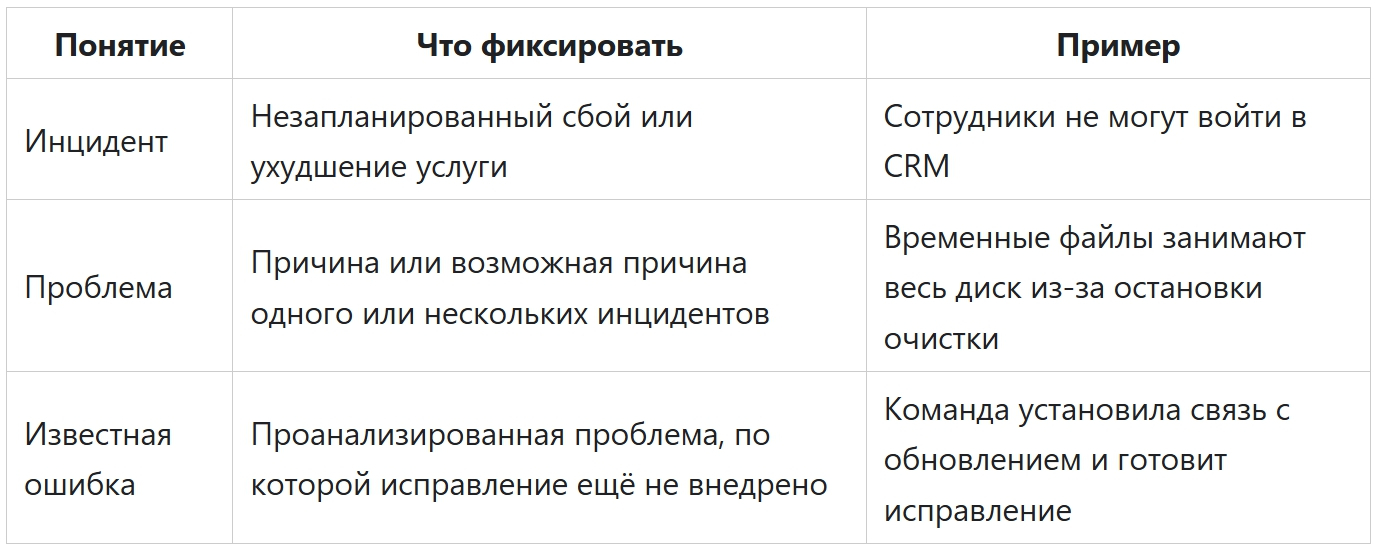
В одном отказе могут сочетаться несколько причин: рост объёма файлов, остановка очистки и отсутствие предупреждения о заполнении диска. Ручное удаление ненужных файлов может служить обходным решением, пока команда исправляет автоматическую очистку.
Реактивное расследование начинается после серьёзного сбоя или группы похожих обращений. Проактивное — когда риск обнаруживают по мониторингу, тестам, истории изменений или сообщению поставщика. Для обоих случаев подходит один порядок работы.
Пять этапов: от первой версии до проверки исправления
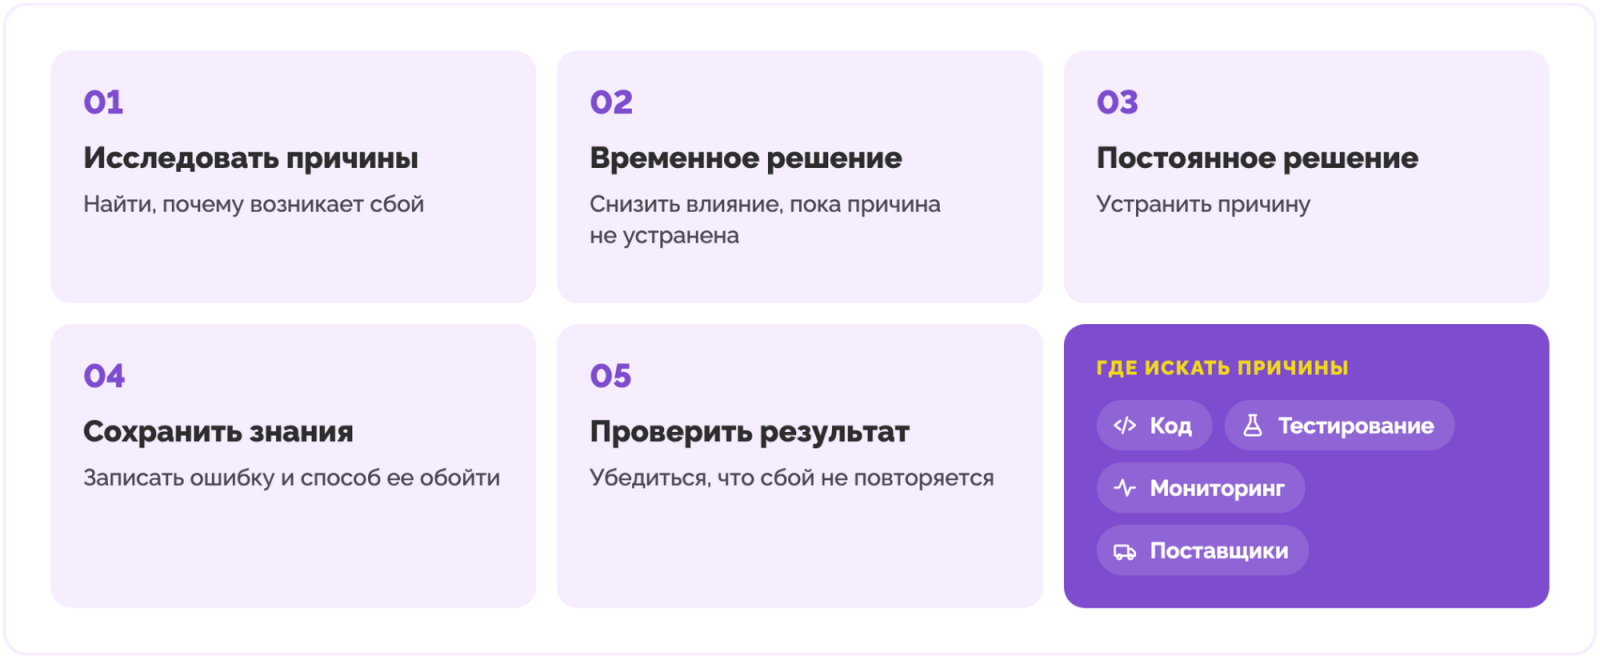
Проблема проходит отдельный цикл работы, даже если сервис уже восстановили.
1. Соберите события и установите причины
Свяжите повторные инциденты с карточкой проблемы. Запишите, когда начались сбои, кого они затронули и какие изменения им предшествовали. Метод «Пять почему» из бережливого производства помогает пройти от симптома к проверяемой гипотезе. Каждый ответ подкрепляйте данными.
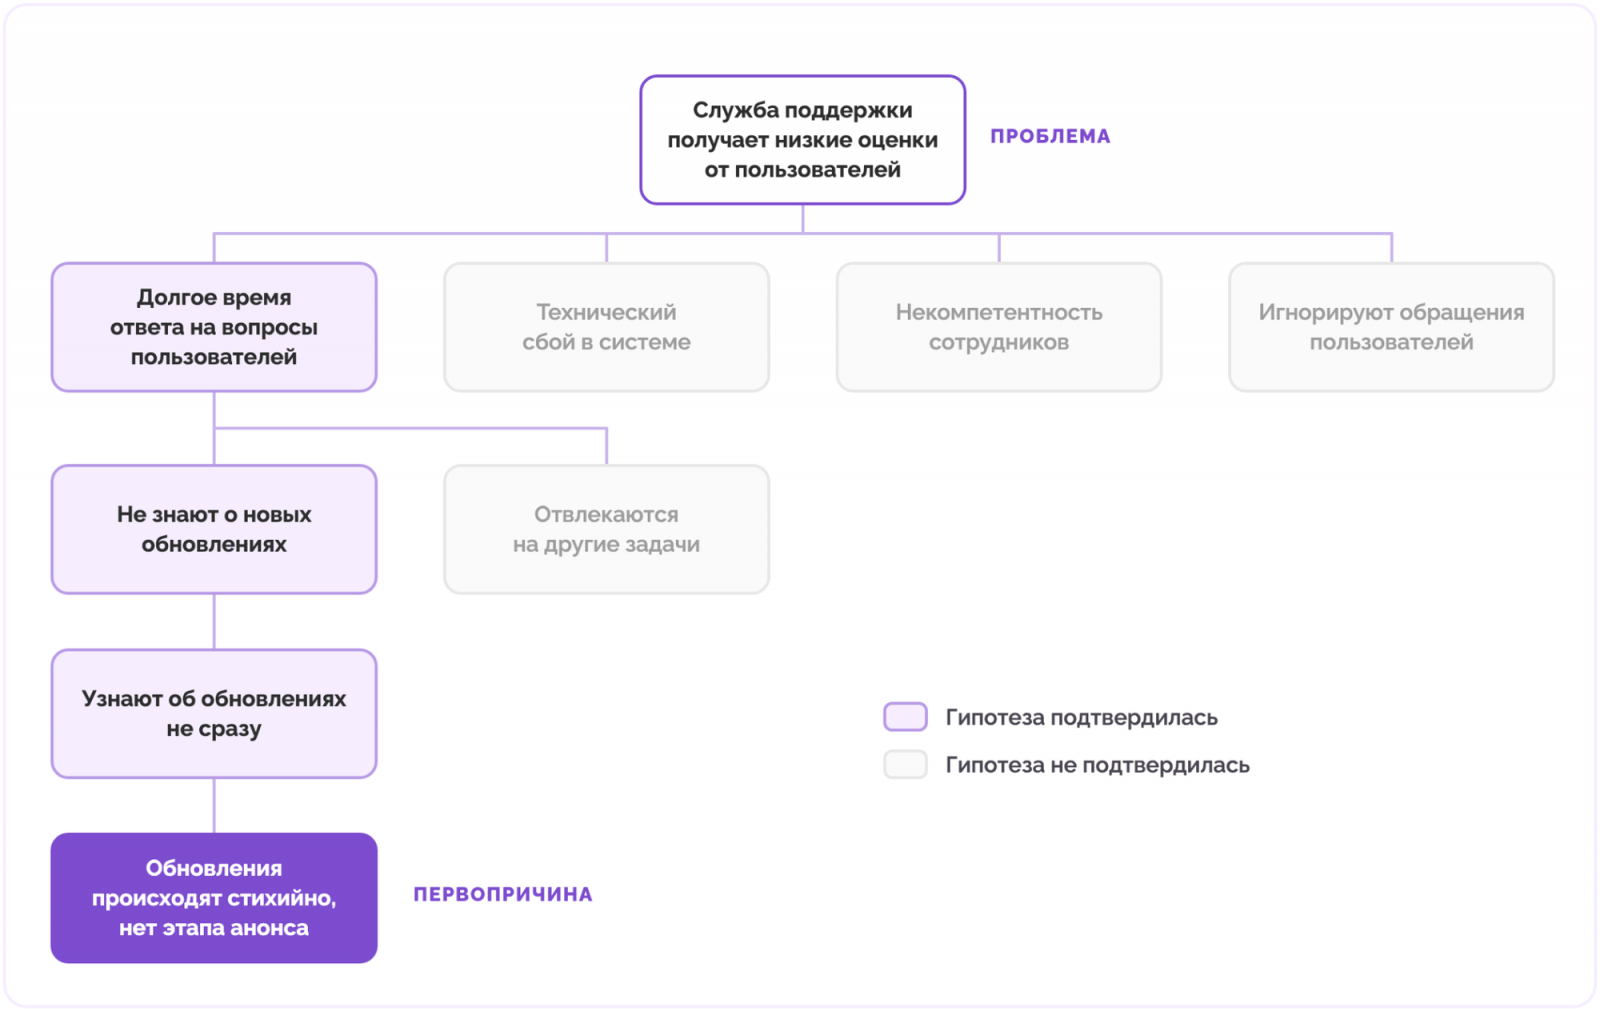
Сопоставьте временную линию с журналами, графиками нагрузки и состоянием зависимых сервисов. Если гипотез много, разложите их по категориям с помощью диаграммы Исикавы: настройки, код, оборудование, процессы, внешние зависимости.
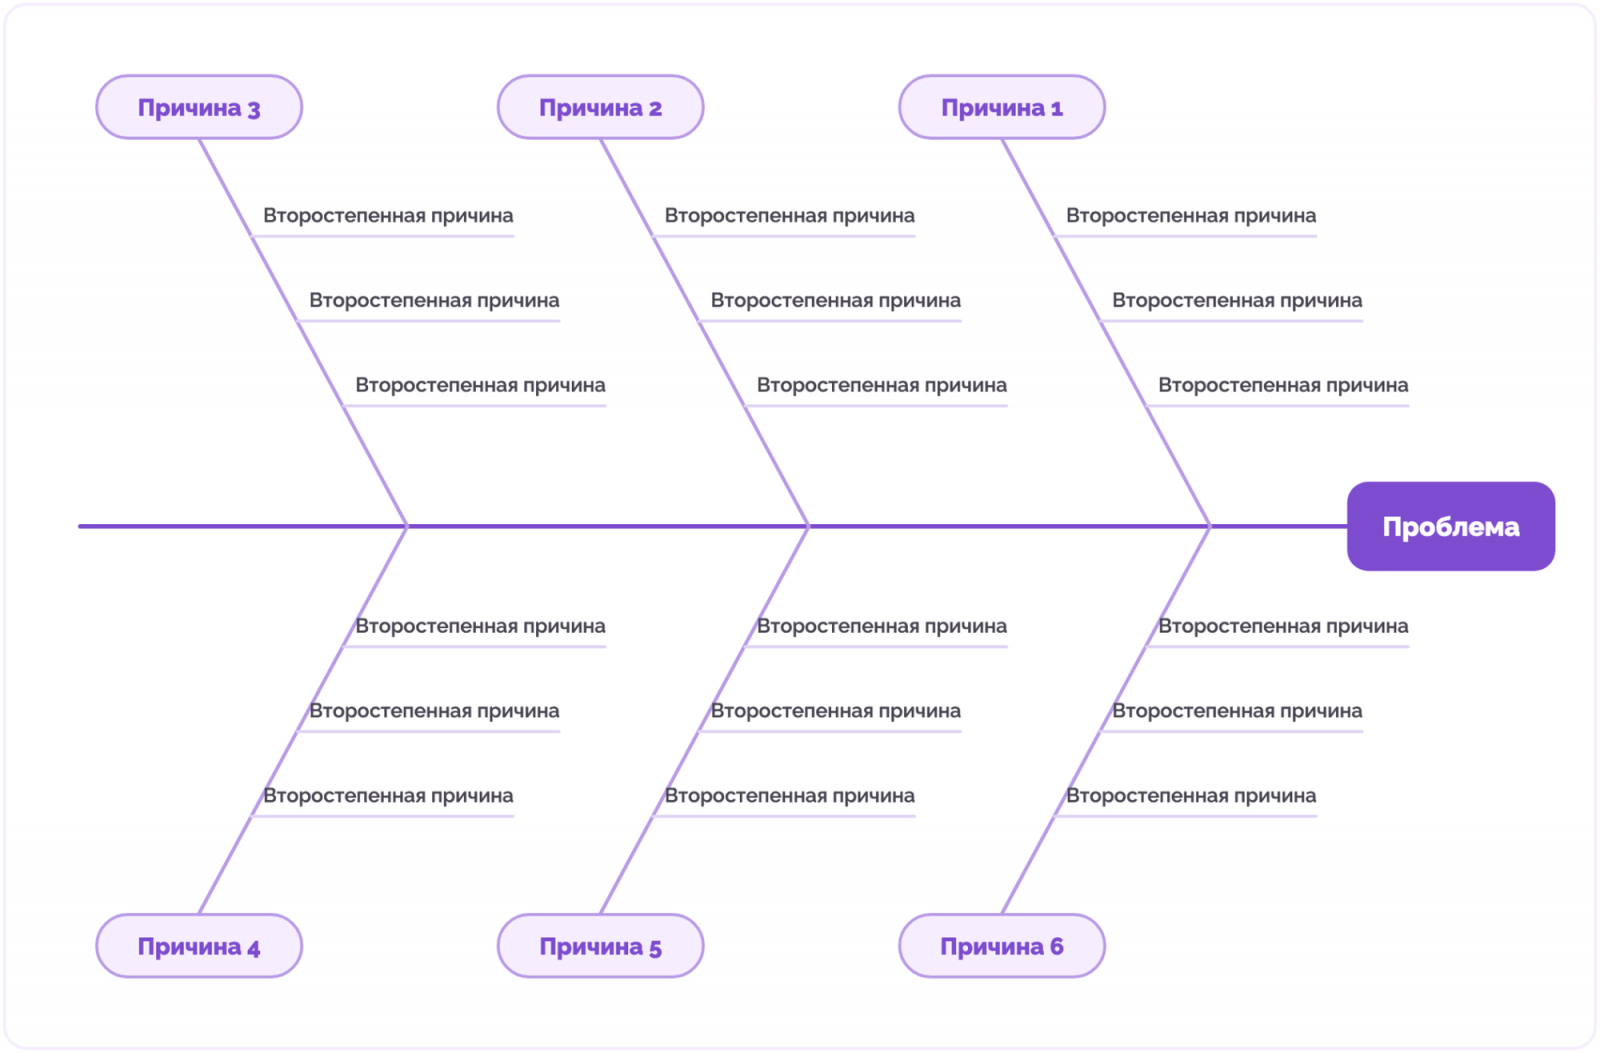
Отмечайте в карточке, какие версии подтвердились и какие исключили. Если возможно, проверьте гипотезу на тестовом стенде. О том, как команда организовала тестирование, рассказывает кейс Dodo Engineering.
2. Дайте пользователям временный способ продолжить работу
Если вход после обновления перестал работать только в мобильном приложении, поддержка может предложить веб-версию. Запишите, для кого подходит обходной сценарий и как его применить. Он может понадобиться ещё до завершения расследования.
3. Внедрите изменение, которое устраняет причину
В зависимости от результатов расследования обновите настройку, код или оборудование. До внедрения проверьте исправление, оцените риск для зависимых сервисов и подготовьте откат, если изменение может затронуть пользователей.
4. Сделайте результаты доступными другим сменам
В базе известных ошибок (KEDB) сохраните симптомы, подтверждённую причину, временный способ работы и ссылки на исправление. Для этого подойдёт обычная база знаний с поиском. В Документах Кайтена рядом с описанием можно разместить таблицу связанных карточек и видеть их текущие статусы.
5. Проверьте, возвращается ли сбой
После внедрения сравните мониторинг и обращения при сопоставимой нагрузке. Срок проверки выбирайте по частоте отказов: если сбой возникал примерно раз в неделю, месяц наблюдения даёт несколько возможностей заметить повторение. Если симптомы вернулись, откройте прежнюю карточку: проверенные версии и решения уже записаны.
Кто отвечает за расследование и решение
- Служба поддержки связывает похожие обращения, оценивает охват и сообщает клиентам о временном решении.
- Инженеры проверяют гипотезы, готовят изменение и наблюдают за результатом.
- Владелец сервиса оценивает влияние на бизнес и определяет, когда остаточный риск можно принять.
- Менеджер проблем следит, чтобы запись появилась, у работы был ответственный, а решения дошли до проверки. В небольшой команде эту роль может взять технический лидер или руководитель поддержки.
Как измерить результат
Время восстановления показывает скорость реакции на отдельный сбой. Для работы с причинами смотрите, сколько отказов вернулось и сколько времени уходит на расследование и проверку решения.
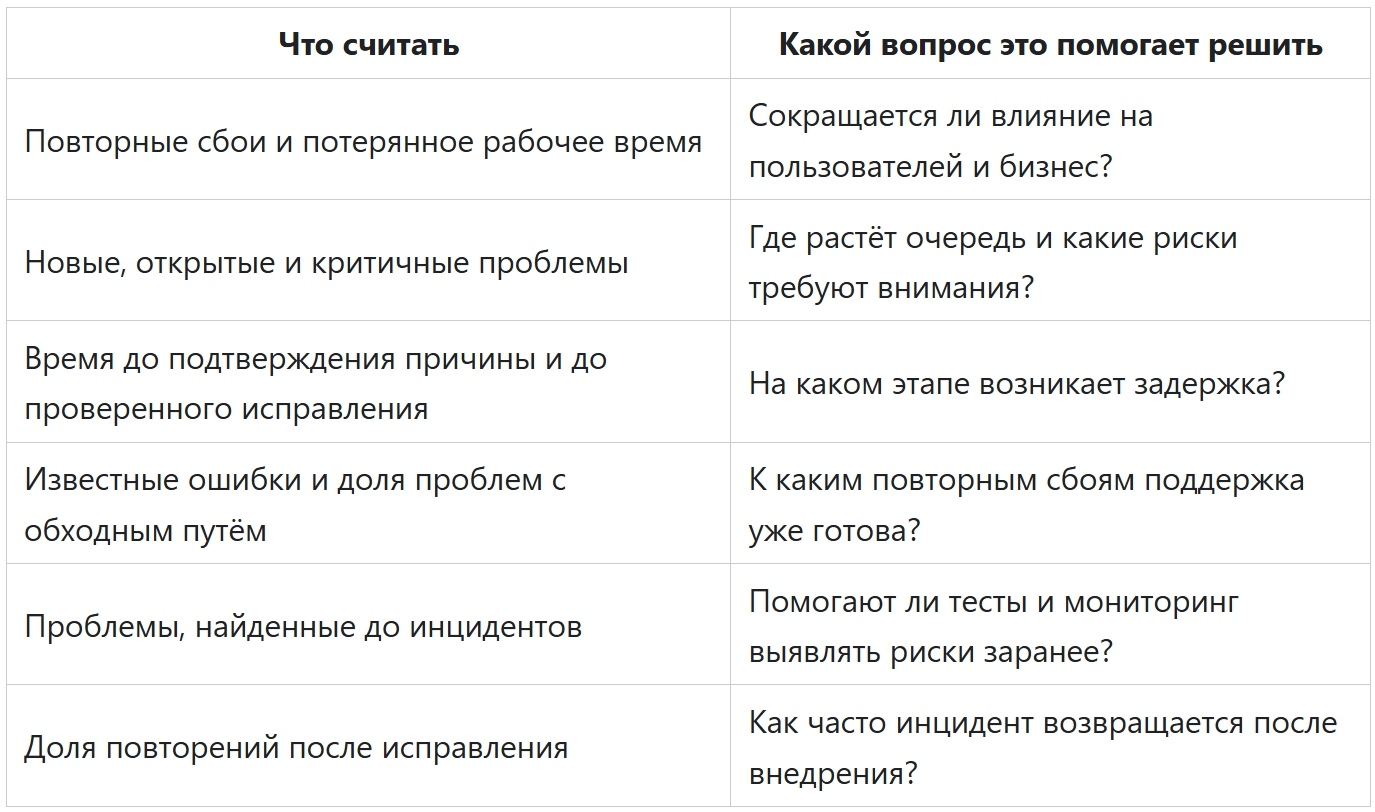
Для расчёта доли повторений установите одинаковое окно, например 30 дней после исправления. Среди проблем, для которых наблюдение уже закончилось, посчитайте те, по которым в этом окне вернулись связанные инциденты. Разделите их число на общее количество проблем в этой группе и умножьте на 100%.
Как собрать процесс на доске Kaiten
В Kaiten создайте доску «Проблемы» с этапами «Новые», «Расследование», «Исправление», «Проверка» и «Закрыто». Поддержка, разработчики и инфраструктурная команда смогут работать с общей записью.
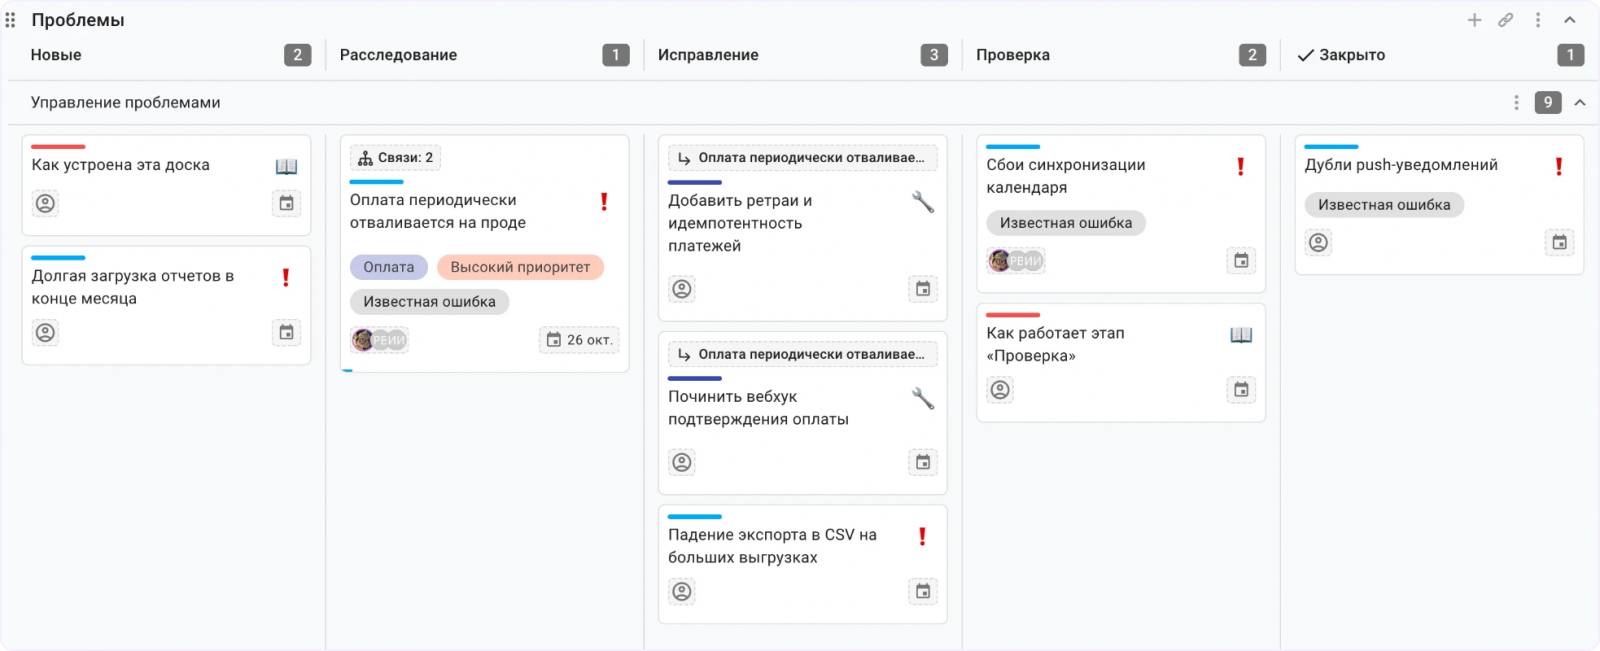
По колонкам видно, сколько проблем ожидают расследования, исправления и проверки.
В карточке зафиксируйте приоритет, срок, ответственного и ссылки на инциденты. Признак известной ошибки и временное решение можно вынести в поля, чтобы дежурный быстро нашёл их при повторном обращении.
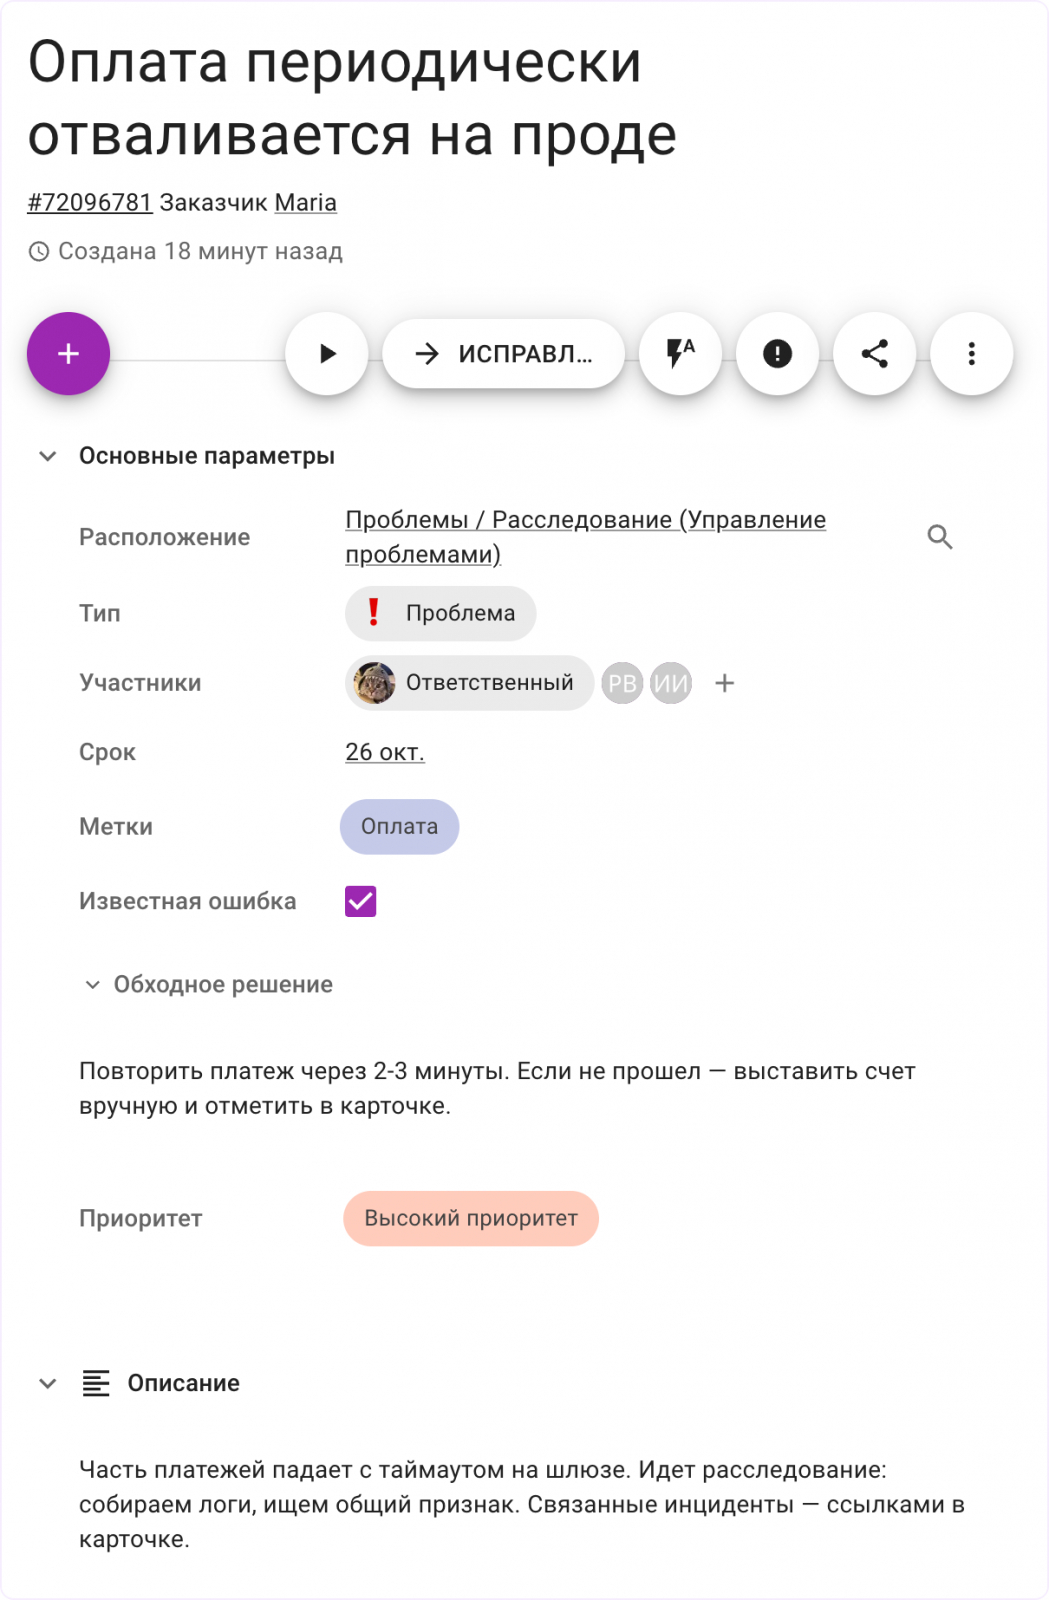
В карточке видны данные об инцидентах и текущий план работы.
Поручения инженерам создавайте как дочерние карточки. По общей задаче будет видно, какие изменения готовы и какие ещё требуют проверки.
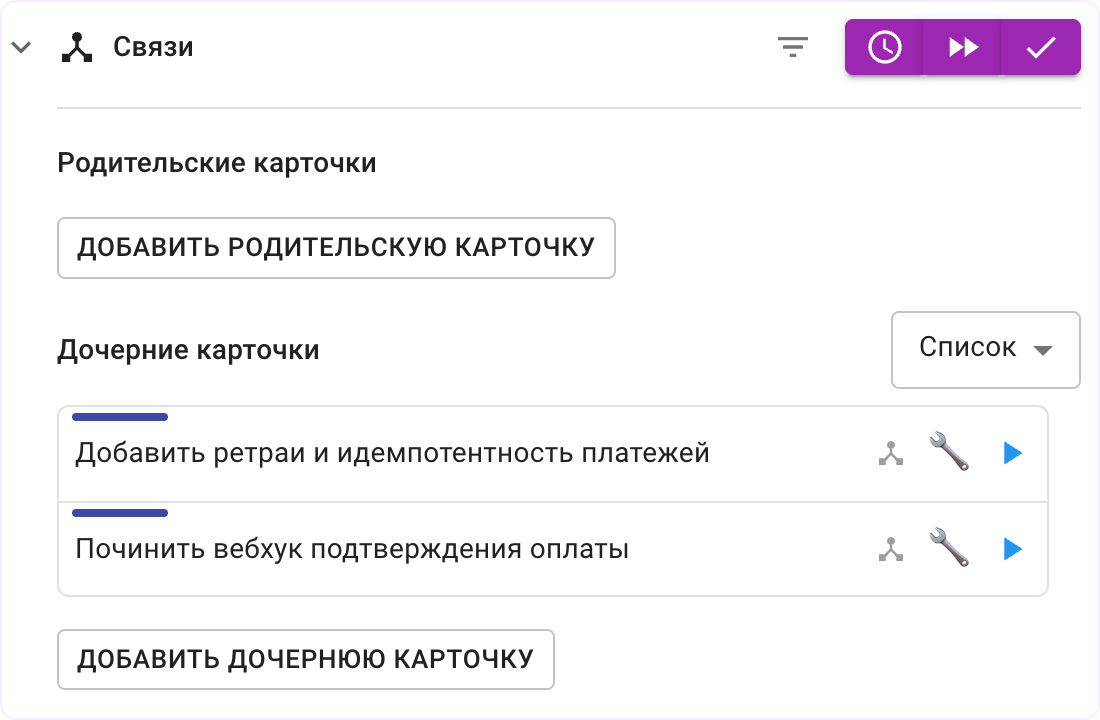
У задач на исправление могут быть разные исполнители при общей карточке проблемы.
Подключите автоматизации для повторяющихся действий, например назначения по правилу при переходе в расследование. Пример работы другой команды с платформой есть в обзоре Kaiten для маркетинга. Подтверждённые причины и инструкции сохраняйте в базе знаний.
Оставляйте проблему в «Проверке» до завершения наблюдения. Если работа регулярно останавливается на одном этапе, посмотрите накопительную диаграмму потока.
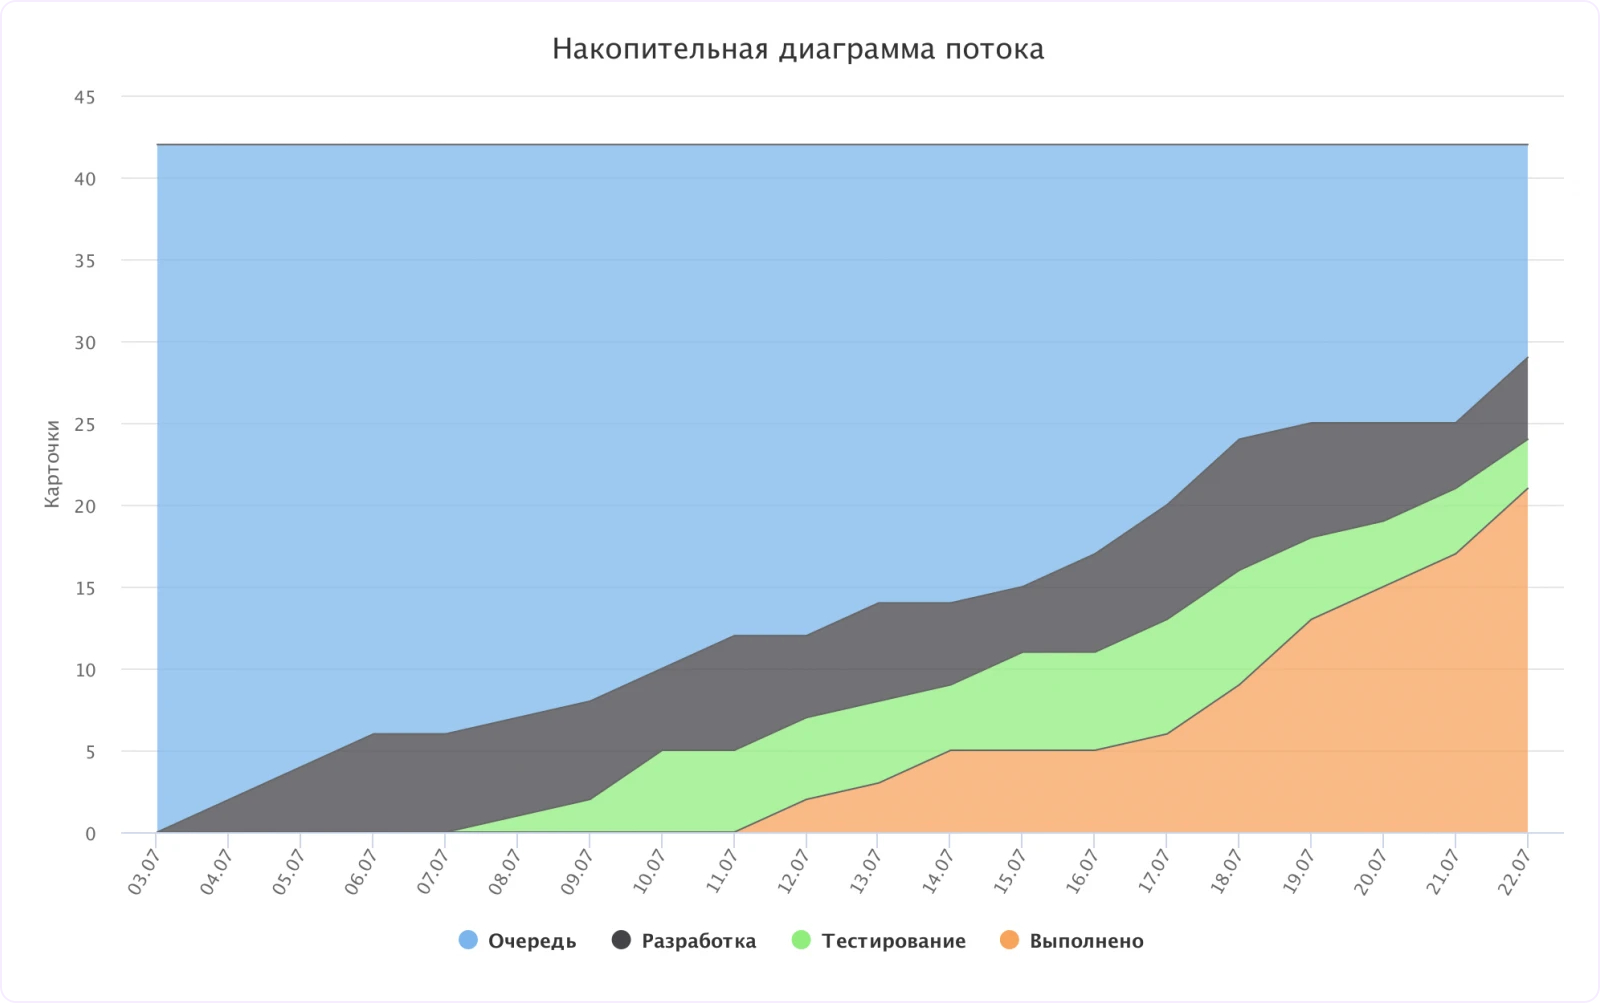
Накопительная диаграмма показывает, на каких этапах очередь растёт.
За основу можно взять шаблон разбора инцидентов с этапами, постмортемами и корректирующими мерами. Забрать шаблон · Попробовать Kaiten.
Где процесс чаще всего прерывается
- По каждому обращению заводят отдельную проблему. Сначала сопоставьте симптомы и время отказов.
- Карточку закрывают после восстановления. Выделите отдельное время на расследование и проверку.
- При разборе ищут виноватого. Проследите, какие условия позволили сбою возникнуть и остаться незамеченным.
- Инструкция остаётся в личном чате. Сохраните её в общей базе и добавьте ссылку к проблеме.
- Приоритет определяют только по частоте. Учитывайте также ущерб редких отказов.
- После разбора не создают поручения. Укажите исполнителя, срок и критерий проверки.
- Открытые проблемы перестают пересматривать. Сверяйте их с текущей нагрузкой и проверяйте обходные решения.
Для первого разбора возьмите один повторный или критичный случай. Назначьте ответственного, соберите связанные записи и доведите изменение до проверки. По итогам станет понятно, какие правила стоит закрепить для всей команды. Настройки Kaiten описаны в справке.