Поисковые подсказки: как использовать для сбора семантики и трафика
Пока вы читаете этот текст, Яндекс и Google продолжают генерировать тысячи новых вариантов в поисковой строке. Пользователи начинают вводить запрос — а поисковик тут же предлагает его продолжение.
Для SEO это ценный источник данных. В подсказках можно найти формулировки, которыми люди действительно пользуются при поиске товаров, услуг и информации. Причем значительную часть таких запросов специалисты просто не замечают.
В результате рядом с привычной семантикой остается дополнительный пласт низкочастотных фраз, по которым зачастую проще получить поисковый трафик.
Ниже разберем весь процесс по шагам: как появляются поисковые подсказки, где их собирать, как очищать полученный список и превращать найденные запросы в страницы и статьи.
Как формируются поисковые подсказки в Яндексе и Google
Стоит начать печатать несколько букв в Яндексе или Google — и поисковик практически моментально предлагает возможные продолжения.
Эти фразы появляются не случайно. Алгоритмы стараются предугадать, что именно собирается найти человек. Для этого поисковая система анализирует большой массив данных: какие запросы вводят пользователи, что набирает популярность сейчас, какие темы были востребованы недавно и что чаще ищут в конкретном регионе.
Получается своеобразный срез реального спроса. Поэтому для специалиста по SEO подсказки интересны не только как удобная функция поисковика, но и как дополнительный источник семантики.
Что влияет на формирование подсказок
Важнейший фактор — популярность фразы. Если большое количество людей регулярно вводит один и тот же запрос, вероятность увидеть его среди подсказок возрастает.
Но частотностью алгоритм не ограничивается. Поисковики учитывают и другие сигналы.
- Региональность. Один и тот же запрос может давать разные продолжения в разных городах. Например, пользователи из Москвы и Новосибирска при вводе «купить диван» необязательно увидят одинаковый список: поисковая система учитывает местоположение.
- Сезонность. Интерес аудитории меняется в течение года. Поэтому зимой рядом с запросом «куртка» могут появляться варианты, связанные с зимней одеждой, а ближе к осени — уже с более легкими моделями.
- Новости и события. Если определенная тема резко становится популярной, связанные с ней запросы способны быстро попасть в подсказки.
- История поиска. Для авторизованного пользователя результат может быть персонализирован. Поисковик учитывает предыдущие запросы, интересы и клики.
- Поведение аудитории. Алгоритмы видят, какие варианты пользователи чаще выбирают после ввода одинаковых букв или слов. Популярные продолжения могут подниматься выше.
Именно поэтому список подсказок нельзя считать раз и навсегда зафиксированным. Он меняется вместе с поведением аудитории.
Чтобы повысить качество поведенческих факторов на сайте, используйте сервис Seopapa: рост позиций видно уже в первые 2 недели.
Яндекс и Google: в чем разница
Механика у двух поисковых систем похожая, однако работают они не идентично.
Яндекс сильнее привязан к региональной выдаче и оперативно реагирует на темы, которые становятся популярными в рунете. Google больше опирается на глобальный массив данных и контекст конкретного пользователя. Например, экосистема компании позволяет учитывать взаимодействие с другими ее сервисами, включая YouTube.
Есть различия и на мобильных устройствах. Google активнее предлагает длинные и голосовые формулировки, а Яндекс адаптирует выдачу подсказок под компактный формат экрана.
Еще один нюанс касается фильтрации. В исходном материале отмечается, что Яндекс жестче работает с нежелательным содержимым в подсказках, а обращения по поводу негативных брендовых вариантов там могут обрабатываться быстрее.
Виды подсказок: когда они появляются
Увидеть подсказки можно в нескольких сценариях.
- Пользователь начинает набирать слово, а поисковая система предлагает самые востребованные продолжения.
- Человек вводит целое слово или фразу и ставит пробел — после этого появляются уточняющие варианты.
- На смартфонах поисковик способен предлагать уже практически готовые предложения или вопросы, чтобы человеку не приходилось вводить их полностью.
Для SEO интересны все три варианта. Чем глубже мы раскрываем исходный запрос, тем больше конкретных формулировок получаем.
Пример: что дает запрос «купить диван»
Можно провести простой эксперимент.
Откройте Яндекс, наберите «купить диван» и поставьте после фразы пробел. В зависимости от региона, истории пользователя и текущего спроса поисковик предложит дополнительные варианты.
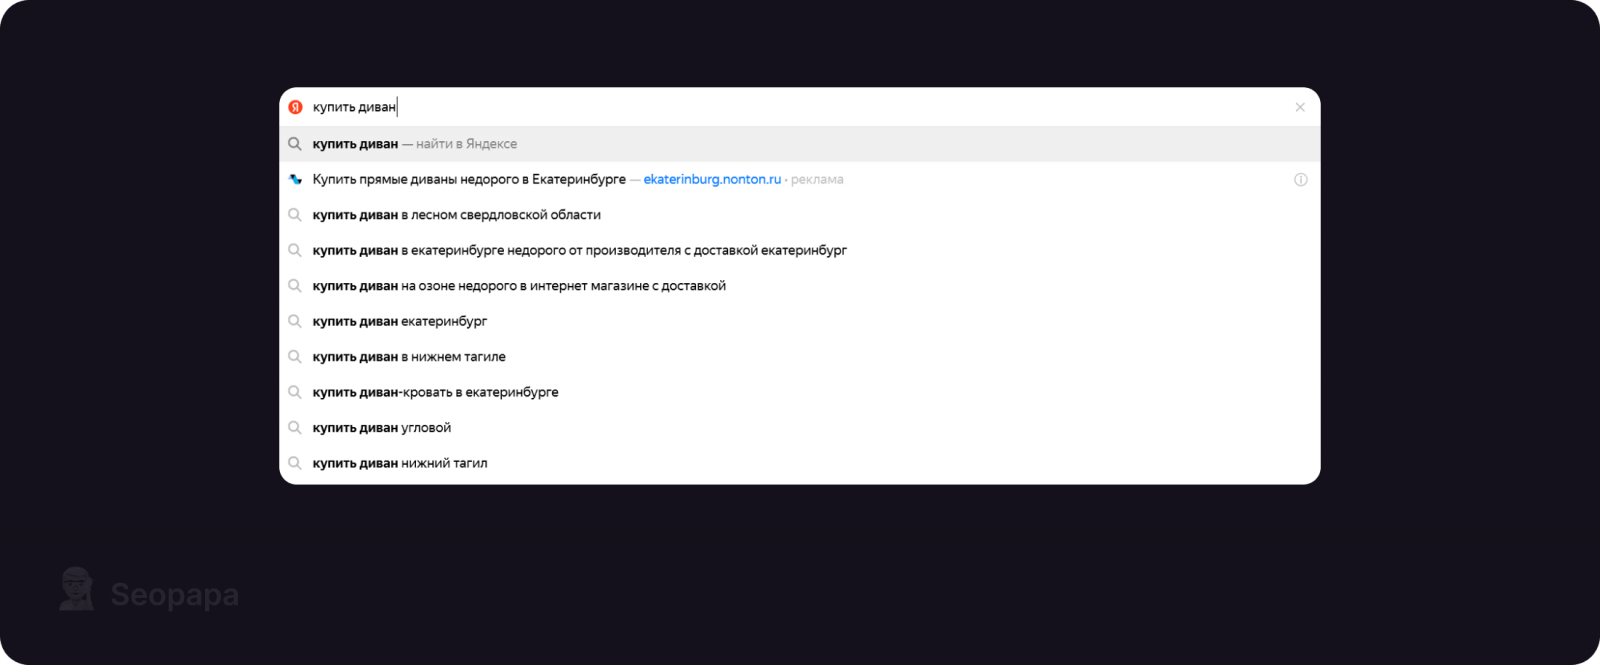
Например:
- «купить диван в Москве недорого»;
- «купить диван угловой»;
- «купить диван с доставкой»;
- «купить диван от производителя».
Конкретный набор будет отличаться, однако для SEO важен сам принцип.
Каждая такая формулировка отражает поисковый интерес аудитории. Вместо одного широкого ключа SEO-специалист получает десятки более конкретных запросов.
Дальше их можно использовать для расширения семантического ядра, создания статей и посадочных страниц или, например, при подготовке рекламных кампаний в Директе.
Есть только одна проблема: подсказки постоянно меняются. Поэтому собирать их один раз и забывать о них не стоит. Минимум раз в месяц полезно посмотреть, какие новые варианты появились и какие старые потеряли актуальность.
Как собрать поисковые подсказки: инструкция и инструменты
Есть несколько способов получить данные — от обычного ручного сбора до массового автоматического парсинга.
Выбор зависит прежде всего от объема работы. Для десяти исходных запросов нет смысла разворачивать сложную систему, а несколько тысяч фраз вручную уже никто разумно обрабатывать не станет.
Разберем варианты по порядку.
Ручной сбор: бесплатно и без инструментов
Самый простой способ вообще не требует дополнительных сервисов.
- Откройте Яндекс или Google в режиме инкогнито. Так влияние предыдущей истории поиска и персонализации будет меньше.
- Введите основной запрос. Допустим, это «ремонт квартиры».
- После него поставьте пробел и добавьте букву «а».
- Выпишите появившиеся варианты.
- Затем замените «а» на «б», потом на «в» и продолжайте перебирать алфавит.
Поисковая система начнет предлагать разные продолжения исходной фразы. Так можно довольно быстро найти запросы, до которых при обычном сборе семантики вы могли бы не добраться.
В исходном материале приводится ориентир: на обработку 5–10 базовых фраз таким способом потребуется примерно 15–30 минут. За это время реально собрать от 50 до 150 дополнительных ключей.
Метод особенно полезен небольшим проектам и начинающим вебмастерам, которые пока не готовы платить за профессиональные SEO-инструменты.
Заодно ручной сбор помогает лучше понять язык аудитории: становится видно, какими словами люди описывают проблему, товар или услугу.
Недостаток тоже очевиден.
Когда исходных запросов становится много, процесс превращается в рутину. Поисковики выводят ограниченное количество вариантов одновременно, поэтому приходится снова вводить буквы, копировать результат и переносить его в таблицу вручную.
Полуавтоматический сбор через Arsenkin Tools
Если перебирать весь алфавит руками не хочется, часть процесса можно автоматизировать.
Один из вариантов — Arsenkin Tools. Сервис самостоятельно перебирает варианты продолжения исходного запроса.
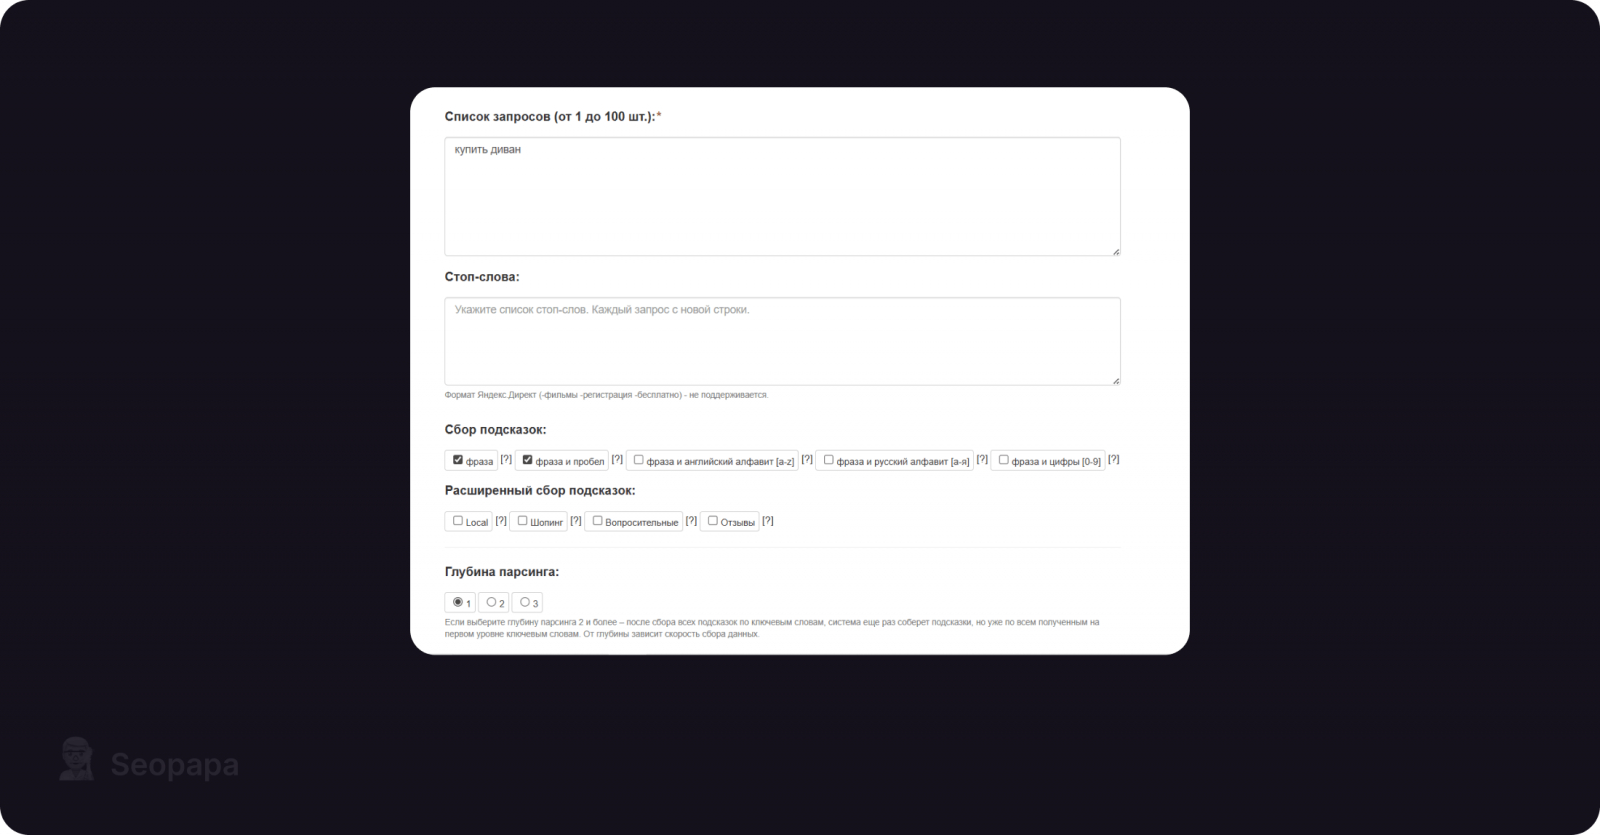
Принцип простой: вводите ключевую фразу, задаете нужный регион — например Москву, Санкт-Петербург или другой город — и запускаете сбор. Через некоторое время получаете список подсказок из Яндекса.
Готовые данные можно выгрузить в файл и дальше работать с ними как с обычной семантикой.
Такой вариант уже заметно быстрее ручного перебора. По данным исходной статьи, за день можно обработать до 100 базовых запросов без установки отдельной программы и постоянного переключения между буквами.
Для большинства небольших контентных проектов этого достаточно: можно расширить ядро, подобрать новые темы и получить дополнительные идеи для стратегии продвижения.
Автоматический парсинг: Key Collector и Rush Analytics
При работе с сотнями или тысячами исходных ключей ручная схема перестает быть практичной.
Здесь уже нужны инструменты для массового сбора.
Key Collector — десктопная программа, которая умеет автоматически парсить подсказки Яндекса и Google.
Пользователь загружает список исходных ключей, запускает процесс и получает расширенный набор фраз. Одновременно можно работать с частотностью и фильтровать ненужные запросы.
В исходной статье отдельно отмечается модель оплаты программы: лицензия приобретается разово. Для небольшой компании такой вариант иногда удобнее постоянной подписки.
Rush Analytics работает в облаке. Это значит, что задачу не нужно постоянно выполнять на собственном компьютере.
Загрузили данные, запустили процесс — дальше обработкой занимаются серверы сервиса. В материале приводится характерный пример: можно отправить задачу, уйти пить кофе, а примерно через 20 минут вернуться за результатами.
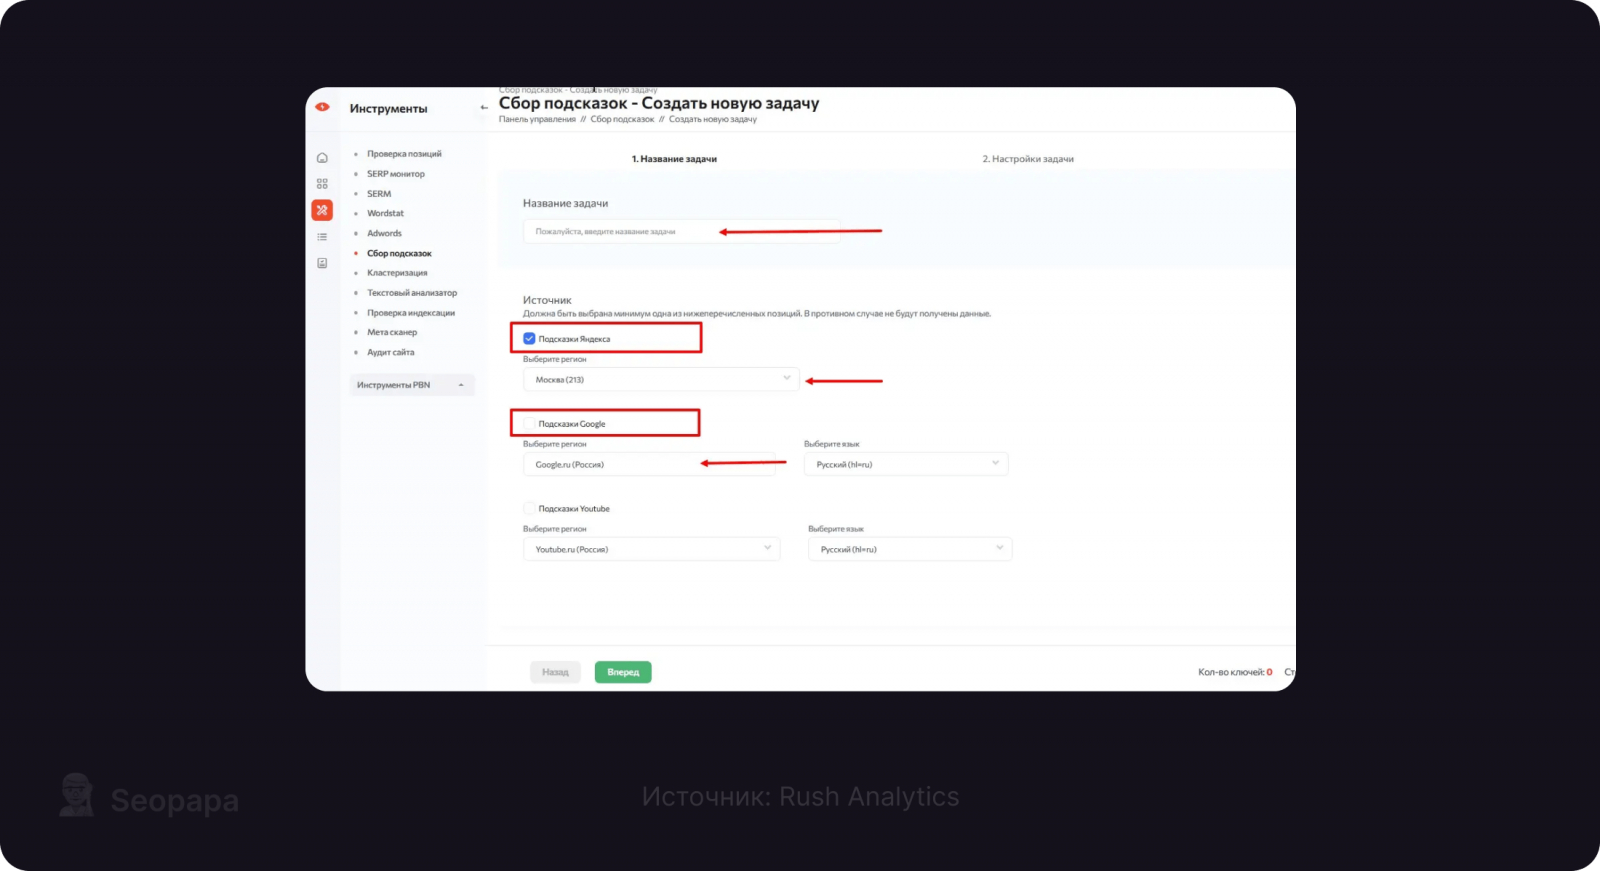
Такие решения удобны для крупных проектов, где семантика измеряется уже тысячами исходных фраз.
На что обратить внимание
Массовый сбор — это не просто вопрос скорости.
Если слишком активно отправлять запросы к поисковой системе с одного IP-адреса, алгоритмы могут расценить такую активность как подозрительную и ограничить доступ.
Поэтому инструмент стоит выбирать под реальный масштаб задачи.
Для небольшого или среднего списка хватает бесплатных решений вроде Arsenkin Tools. Если же вы собираете семантику под крупный сайт, готовите контент-план на несколько месяцев или обрабатываете тысячи ключей, автоматизация уже оправдывает затраты.
Условный ориентир из исходной статьи выглядит так: до сотни запросов можно обработать бесплатным инструментом. Если объем заметно больше, имеет смысл переходить к специализированным решениям.
Фильтрация подсказок и сборка семантического ядра
Получить большой список ключей — только половина работы.
Представим, что по теме «купить диван» парсер собрал 500 вариантов. На первый взгляд выглядит отлично: семантики хватит надолго.
Но внутри обязательно окажется мусор.
Часть запросов будет отличаться только порядком слов. Где-то встретятся опечатки. В список попадут чужие бренды, названия магазинов и фразы с совершенно другим намерением пользователя.
Например, «диван своими руками чертеж» содержит нужное слово, но человеку явно не нужен интернет-магазин мебели.
Если без разбора отправить все 500 запросов в контент-план, часть времени и бюджета будет потрачена на страницы, которые бизнесу ничего не принесут.
Как отсеять мусор
Начать стоит с дублей.
Подсказки могут содержать несколько вариантов фактически одного запроса. Например:
- «диван угловой купить Москва»
- «купить угловой диван в Москве».
Слова стоят в другом порядке, но пользовательский интент остается прежним.
Обнаружить такие совпадения можно с помощью сервисов кластеризации или даже обычной сортировки данных в Excel.
После этого переходите к нецелевым запросам.
В первую очередь сюда относятся фразы с чужими брендами, если они не имеют отношения к вашей стратегии. Пользователь, который прямо вводит название определенной компании, зачастую уже ищет именно ее.
Также стоит удалить информационные запросы, которые не представляют ценности конкретно для вашего бизнеса, и временные новостные темы.
Для мебельного магазина запрос «диван в сериале друзья» вряд ли даст полезные продажи. А фраза «диван аскона отзывы» может не иметь смысла, если Аскона — прямой конкурент и намерение пользователя связано именно с этим брендом.
Критерии оценки каждой подсказки
Даже релевантные ключи отличаются по ценности.
Оценивать их удобно минимум по четырем параметрам.
- Релевантность бизнесу. Запрос должен соответствовать тому, что компания действительно предлагает. Для сервиса доставки цветов по Москве фраза «цветы из бисера инструкция» формально тематическая, но целевых клиентов не приведет.
- Поисковый спрос. Подсказку стоит дополнительно проверить через Wordstat. Красиво сформулированный запрос с нулевой частотностью трафика не даст.
- Конкуренция. Длинные низкочастотные фразы часто проще продвигать, чем высокочастотные коммерческие ключи. За запрос «купить диван» борется огромное количество сайтов, тогда как «как выбрать диван для маленькой студии» значительно уже.
- Интент. Слова «купить», «цена», «заказать» и «доставка» чаще говорят о коммерческом намерении. Вопросительные и обучающие формулировки подходят для информационного контента. И те и другие нужны, просто ведут они на разные типы страниц.
Кластеризация: от списка к контент-плану
После очистки список становится значительно меньше.
В исходном примере из 500 подсказок может остаться примерно 100–150 действительно полезных фраз.
Теперь их нужно не просто хранить в таблице, а разбить по смыслу.
Для этого используют кластеризацию. KeyAssort, Keys.so и другие инструменты могут группировать ключи, ориентируясь в том числе на пересечения страниц в поисковой выдаче.
Если по нескольким фразам Яндекс показывает практически один и тот же набор документов, скорее всего, отдельные страницы под каждый запрос создавать не требуется.
В результате из сотни ключей можно получить, например, 15–20 смысловых кластеров. Каждый из них становится основой для отдельного материала или посадочной страницы.
И именно здесь подсказки особенно хорошо раскрывают свою ценность.
Длинные низкочастотные запросы показывают, какими словами аудитория задает вопросы. Их можно переносить в заголовки, подзаголовки и FAQ.
Фактически пользователи сами подсказывают структуру будущего материала: вопрос превращается в H2 или H3, а под ним появляется развернутый ответ.
Такая работа с семантикой гораздо точнее создания контента «по ощущениям» и помогает привлекать пользователей по реальным поисковым формулировкам.
Ошибки при работе с подсказками и способы их избежать
Сам по себе большой объем данных результата не гарантирует.
Даже правильно собранные подсказки легко превратить в бесполезный список, если неправильно работать с ними дальше.
Разберем основные ошибки.
Ошибка 1. Сбор без фильтрации
Типичная ситуация: специалист парсит все возможные подсказки, загружает их в таблицу и начинает создавать страницы практически под каждую фразу.
Так делать не стоит.
Среди собранных данных обязательно окажутся нерелевантные запросы, чужие бренды и информационные ключи, которые совершенно не подходят коммерческой странице.
Для магазина мебели фраза «кино с диванами» бесполезна, хотя формально ключевое слово «диван» в ней присутствует.
Как избежать: проверяйте соответствие каждой группы тематике сайта и реальным интересам вашей аудитории. Чем раньше удалить мусор, тем меньше ресурсов уйдет на бесперспективный контент.
Ошибка 2. Игнорирование региональности
Москва, Новосибирск и любой другой город могут давать разные подсказки по одному исходному слову.
Для локального бизнеса это особенно важно.
Если компания работает только в определенном регионе, а семантика собрана без нужной геопривязки, заметная часть ключей окажется просто бесполезной.
Как избежать: задавайте регион непосредственно во время парсинга. Если сайт продвигается сразу в нескольких городах, лучше проводить отдельный сбор для каждого из них.
Ошибка 3. Некачественная накрутка подсказок
Некоторые компании пытаются искусственно заставить поисковик показывать нужную формулировку.
Для этого исполнителям или ботам дают задание массово вводить определенный запрос. На первый взгляд логика выглядит привлекательно: бренд появляется рядом с популярным ключом, получает дополнительную видимость и потенциальные переходы.
Проблема в том, что поисковые системы умеют выявлять неестественную активность.
В исходном материале отмечается, что использование устаревших схем может закончиться удалением искусственно созданной подсказки и другими санкциями, вплоть до ухудшения позиций ресурса.
Как избежать: ориентироваться в первую очередь на естественный рост брендового спроса и не использовать примитивные схемы массовой имитации запросов.
Ошибка 4. Подсказки как единственный источник семантики
Подсказки полезны, но не заменяют полноценный анализ ключевых слов.
Они хорошо показывают живые формулировки и помогают обнаруживать длинные запросы. Но сами по себе не дают полной информации о частотности и конкуренции.
Для этого нужны дополнительные источники: Wordstat, Keys.so, Key Collector и другие SEO-инструменты.
С их помощью можно посмотреть объем спроса, сезонность и другие параметры, без которых сложно расставить приоритеты.
Как избежать: комбинировать несколько источников. Подсказки используйте для поиска новых фраз, а остальные сервисы — для проверки их потенциала.
Ошибка 5. Одноразовый сбор
Собрать семантику один раз и работать с ней несколько лет — плохая стратегия.
Спрос меняется. Появляются новые товары, информационные поводы и формулировки. Одни запросы становятся популярными, другие постепенно исчезают.
Сезонность тоже влияет на картину.
В исходном материале приводится пример, что ресурс, где ядро пересобирали раз в квартал, стабильно получал больше трафика по сравнению с сайтом, который продолжал работать с семантикой двухлетней давности.
Как избежать: обновляйте набор подсказок хотя бы раз в три месяца. В конкурентных и быстро меняющихся тематиках это можно делать еще чаще.
Так вы быстрее увидите новые точки спроса и сможете подготовить страницы до того, как ниша станет перегретой.
Выводы
Поисковые подсказки Яндекса и Google — один из самых доступных источников идей для расширения семантики.
Для работы с ними не обязательно сразу покупать дорогие инструменты. Даже обычная поисковая строка показывает десятки реальных формулировок, которыми прямо сейчас пользуется аудитория.
Особенно интересны длинные низкочастотные фразы. По ним обычно меньше конкуренция, а намерение пользователя сформулировано гораздо точнее, чем в широких запросах.
При этом подсказки постоянно меняются. На них влияют популярность темы, регион, сезон, новости и поведение пользователей. Поэтому новый сбор способен дать запросы, которых несколько месяцев назад просто не было.
Метод подходит практически любому типу проекта.
Интернет-магазин получает дополнительные товарные и коммерческие запросы. Блог — реальные вопросы аудитории и новые темы. Сайт услуг — формулировки потенциальных клиентов с учетом нужного региона.
Весь процесс можно свести к пяти шагам:
- Соберите подсказки. Для небольшого объема подойдет ручной способ, для массовой работы — парсеры и специализированные сервисы.
- Очистите список. Уберите дубли, чужие бренды, нерелевантные формулировки и другой мусор.
- Сгруппируйте запросы по интентам. Кластеризация покажет, какие ключи стоит объединить на одной странице.
- Используйте семантику в контенте. Создавайте новые материалы, дополняйте существующие страницы, переносите реальные вопросы пользователей в H2, H3 и FAQ.
- Регулярно обновляйте данные. Хотя бы раз в квартал повторяйте сбор и проверяйте, какие формулировки появились или исчезли.
В результате продвижение строится не вокруг предположений о том, что потенциально может искать аудитория, а вокруг формулировок, которые люди действительно вводят в поисковую строку.
А начать можно прямо сейчас.
Возьмите пять ключевых запросов своего сайта, по очереди введите их в Яндекс и после каждой фразы поставьте пробел. Сохраните все подходящие варианты.
На такую проверку потребуется около 15 минут, зато в таблице появятся десятки тем и ключей, которые легко было пропустить при стандартном сборе семантики.