Сервис работает, но критичный сценарий недоступен: как проектировать деградацию без остановки бизнеса
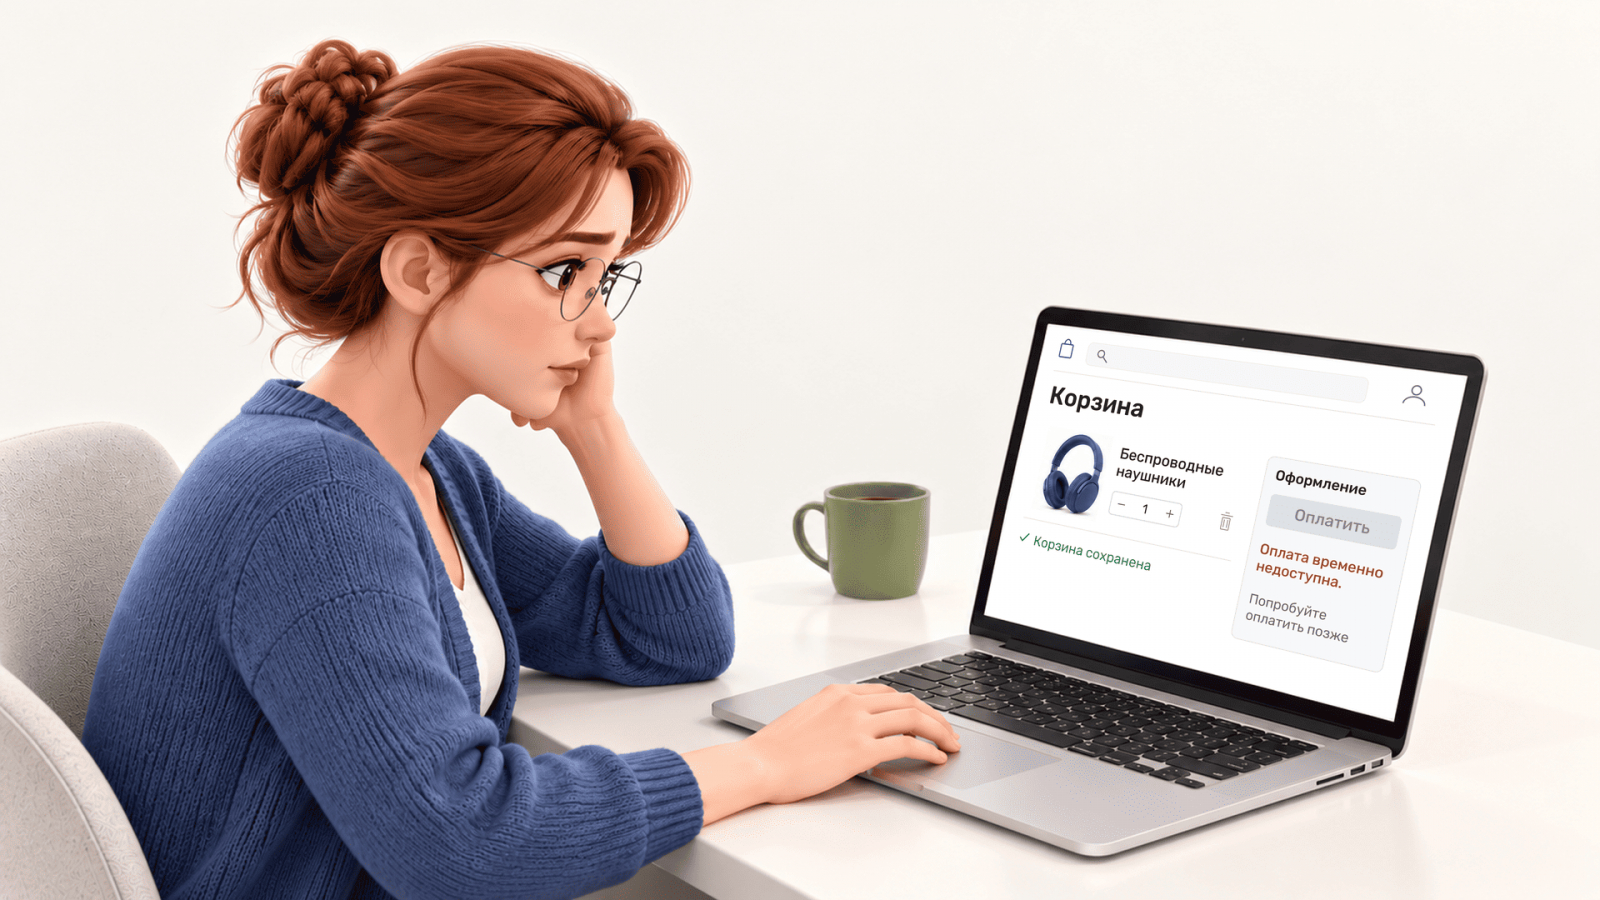
Представим типовую ситуацию: покупатель нажимает «Оплатить», а заказ остаётся в корзине. Страница открывается, каталог доступен, поддержка видит зелёные графики. Для человека по другую сторону экрана сервис в этот момент не работает: он не может завершить действие, ради которого пришёл.
Доля доступных серверов не отвечает на вопрос, выполнен ли важный для бизнеса сценарий. Его приходится задавать отдельно: что должен суметь сделать пользователь, когда платёжный провайдер, поиск, рекомендации или часть базы отвечают с ошибкой.
Привет, я Антон Фокин — CEO Qtim
Я считаю, что у продукта нет одного режима «всё в порядке» и одного режима «всё упало». Между ними нужна заранее согласованная карта: что сохраняем, что упрощаем, что переносим на потом и как честно сообщаем об этом человеку.
Когда критичный путь дороже остальных функций
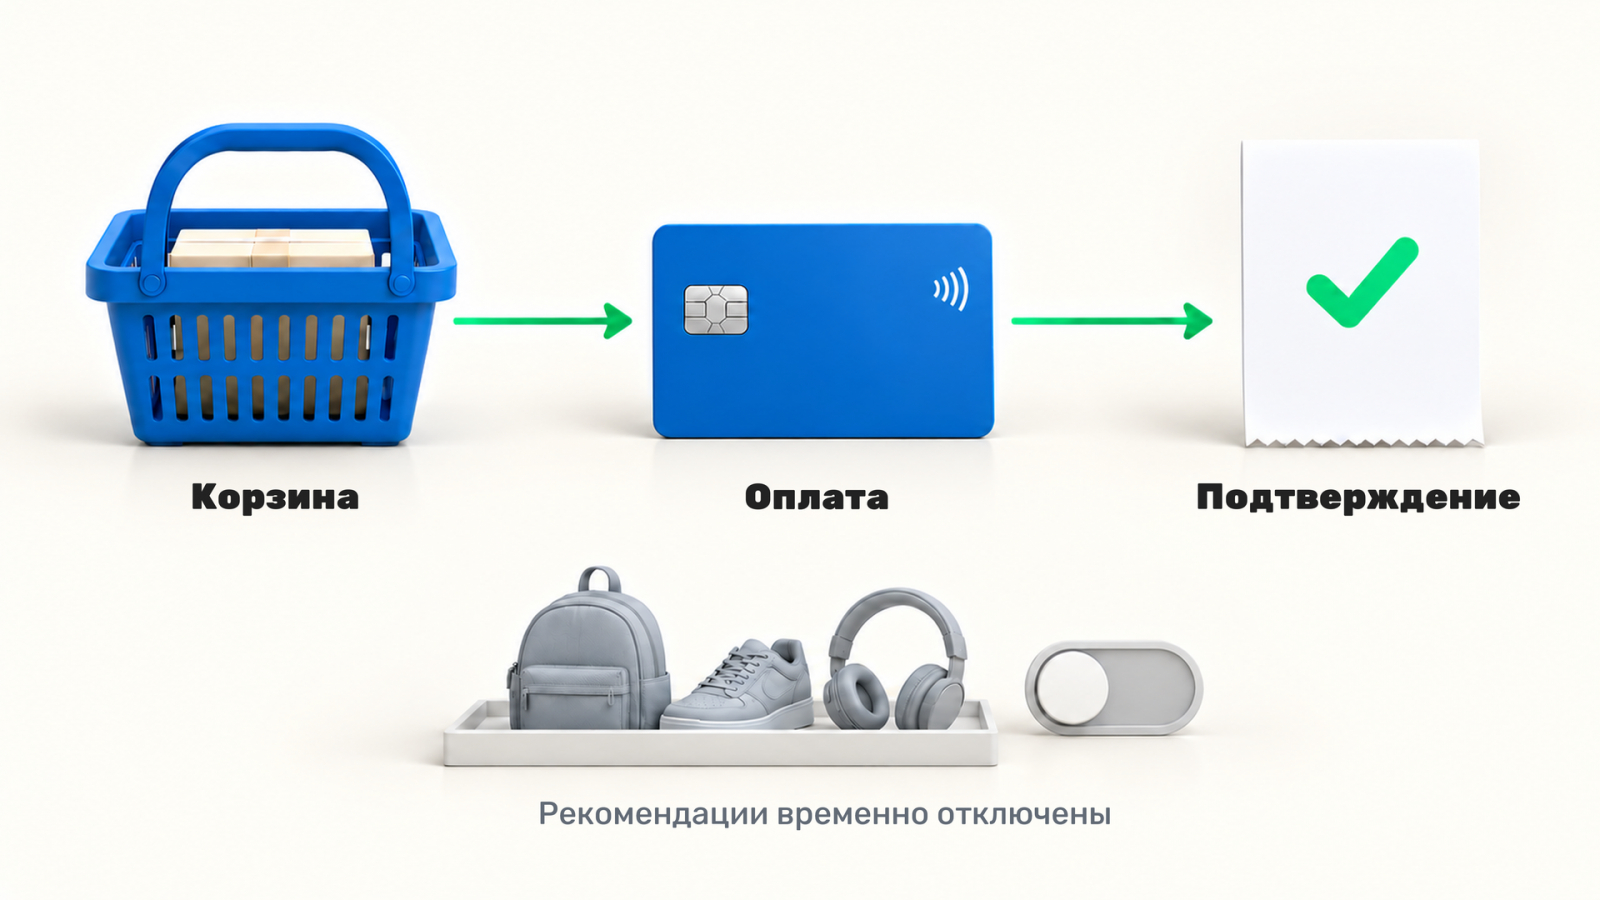
Фраза «нам нужна отказоустойчивость» слишком широка для решения. У маркетплейса важным действием может быть оформление и оплата заказа. У образовательной платформы — вход на урок и доступ к материалу. У B2B-сервиса — отправка документа или подтверждение операции.
Здесь полезно разделить две вещи. Критичный сценарий приносит деньги, выполняет обязательство или удерживает доверие. Его зависимости — это платёжный шлюз, сервис авторизации, складская система, очередь уведомлений и другие компоненты, без которых этот сценарий меняет вид.
Я начинаю такой разбор с результата пользователя. Azure в своих принципах предлагает отталкиваться от бизнес-требований и проектировать систему с учётом сбоев. Для продукта это означает: владелец сценария вместе с разработкой фиксирует минимальный полезный результат, а не только список сервисов на схеме.
Для оформления заказа таким результатом может быть «клиент получил подтверждение, что заказ принят, и понимает следующий шаг». Это не обязательно равняется мгновенному списанию денег и письму с персональной подборкой.
У сценария должно быть три заранее описанных режима
В нашей команде мы стараемся разобрать сбой до инцидента: во время него спор одновременно касается риска денег, технического долга и сообщения пользователю. Поэтому я предлагаю вынести эту работу заранее в карточку критичного сценария.
Полный режим. Операция проходит обычным путём: проверка данных, обращение к зависимостям, мгновенный результат в интерфейсе и стандартные уведомления.
Упрощённый режим. Пользователь получает основной результат, но часть удобства исчезает. Например, сервис принимает заявку и показывает её номер, а второстепенные рекомендации, персональные блоки или немедленная синхронизация с внешней системой временно недоступны.
Отложенный режим. Операция принимается или сохраняется в очередь, но пользователь видит точный статус и срок следующего действия. Такой режим подходит не любой операции: для платежа или юридически значимого действия сначала нужно определить, можно ли обещать принятие без окончательного подтверждения.
AWS рекомендует заранее определить основную функцию компонента и продумать, как сохранить её при недоступности зависимости — с альтернативными, неполными или слегка устаревшими данными. Важно, что это одновременно техническое и бизнес-решение: для одной операции важнее доступность, для другой — строгая консистентность. Подробнее этот выбор описан в AWS.
Карточка становится рабочей, когда в ней есть семь строк:
- Какой результат пользователь должен получить.
- Какая зависимость может этот результат остановить.
- Что выключается первым, чтобы освободить ресурс.
- Какое сообщение увидит пользователь.
- Кто включает режим и по какому сигналу.
- Какой наблюдаемый порог включает упрощённый режим: например, доля ошибок или время ответа конкретной зависимости.
- Какой критерий возвращает полный режим: зависимость стабильно проходит проверку в согласованном окне, а отложенные операции разобраны.
Это не спецификация на все возможные аварии. Это договор о том, как не потерять главное действие из-за второстепенной функции.
Для работающего продукта такую карту можно собрать вместе с планом безопасных изменений. Развитие продукта без перезапуска — подходящая точка, чтобы обсудить эту задачу с нами.
Повторы запросов тоже меняют продуктовый результат
Сбой зависимости часто усугубляет не первичная ошибка, а поток одинаковых попыток. Клиент, приложение и несколько внутренних сервисов продолжают отправлять запросы туда, где ответ уже не приходит. Очередь растёт, время ответа увеличивается, а восстановление становится сложнее.
Microsoft относит такой сценарий к retry storm: частые и долгие повторы способны помешать сервису восстановиться. В числе мер — ограничение запросов на gateway, то есть на пограничном уровне перед backend. Разбор механики есть у Microsoft.
Я бы зафиксировал для каждого критичного действия три ответа. Сколько раз пользователь или сервис попробует повторить операцию? Когда запрос нужно поставить в очередь вместо нового повтора? Какой статус показать, чтобы человек не нажимал кнопку снова?
Ограничение трафика не должно превращать интерфейс в молчаливую стену. Пользователь должен увидеть, что принято, что отложено и когда появится следующий достоверный статус.
Не всякую функцию нужно спасать одинаково
В одной карточке обычно оказываются функции разной ценности. Подборка товаров, история просмотров и чат поддержки могут быть важны, но оформление заказа или доступ к оплаченной услуге в момент сбоя часто важнее.
Поэтому решение о деградации полезно проверять в такой последовательности:
- Сценарий создаёт обязательство перед клиентом или деньги прямо сейчас?
- Можно ли подтвердить его без спорного или необратимого шага?
- Можно ли дать пользователю достоверный промежуточный статус?
- Какая второстепенная функция забирает ресурс и может быть временно отключена?
Ответы определяют механизм. Где-то достаточно кэша или заранее подготовленного набора данных. Где-то нужна очередь с идемпотентной обработкой: повтор одного запроса не создаёт вторую операцию. Для операции с риском двойного списания правильным результатом может стать честное сообщение о задержке, а не имитация успеха.
Главное возражение здесь звучит разумно: «всё невозможно продумать заранее». И не нужно. Я бы начал с одного пути, который одновременно дорог бизнесу и зависит от нескольких систем. После первой карточки становится видно, какие решения повторяются и где нужна отдельная архитектурная работа.
Режим сбоя нужно проверять до настоящего сбоя
Документ не доказывает, что сценарий переживёт нагрузку или отказ внешнего сервиса. Я проверяю его упражнением: наша команда искусственно делает зависимость недоступной, включает упрощённый режим и проходит путь пользователя от первого экрана до результата.
В этом упражнении проверяют не только код. Нужны понятный сигнал включения, владелец решения, текст на экране, инструкция для поддержки и критерий возврата к обычному режиму. В нашем кейсе Онлайн-школы №1 — образовательной платформе для дистанционного обучения с расписанием, домашними заданиями и учебными материалами — мы реализовали Telegram-бота для проверки работы платформы. Он ежедневно эмулировал действия ученика, а каждый релиз проходил дополнительную автоматическую проверку: так критичный путь проверяли после изменений, а не оставляли только в карточке.
Данные Uptime Institute дают ещё один повод смотреть на процесс, а не только на резерв оборудования: половина опрошенных операторов сообщила хотя бы об одном значимом инциденте за три года, а 87% переживших его респондентов считали, что лучшие процессы, управление или конфигурация могли бы предотвратить инцидент. Выборка относится к операторам дата-центров, поэтому она не описывает частоту сбоев в российских цифровых продуктах. Полный отчёт доступен у Uptime.
После такого прогона карточка обычно меняется. Одну зависимость нельзя обойти без нарушения обязательства. Другую достаточно вынести из синхронного пути. Третья не была заметна на первоначальной схеме. В этом и состоит ценность упражнения: оно превращает предположение в проверяемое правило.
Критерий для следующего архитектурного решения
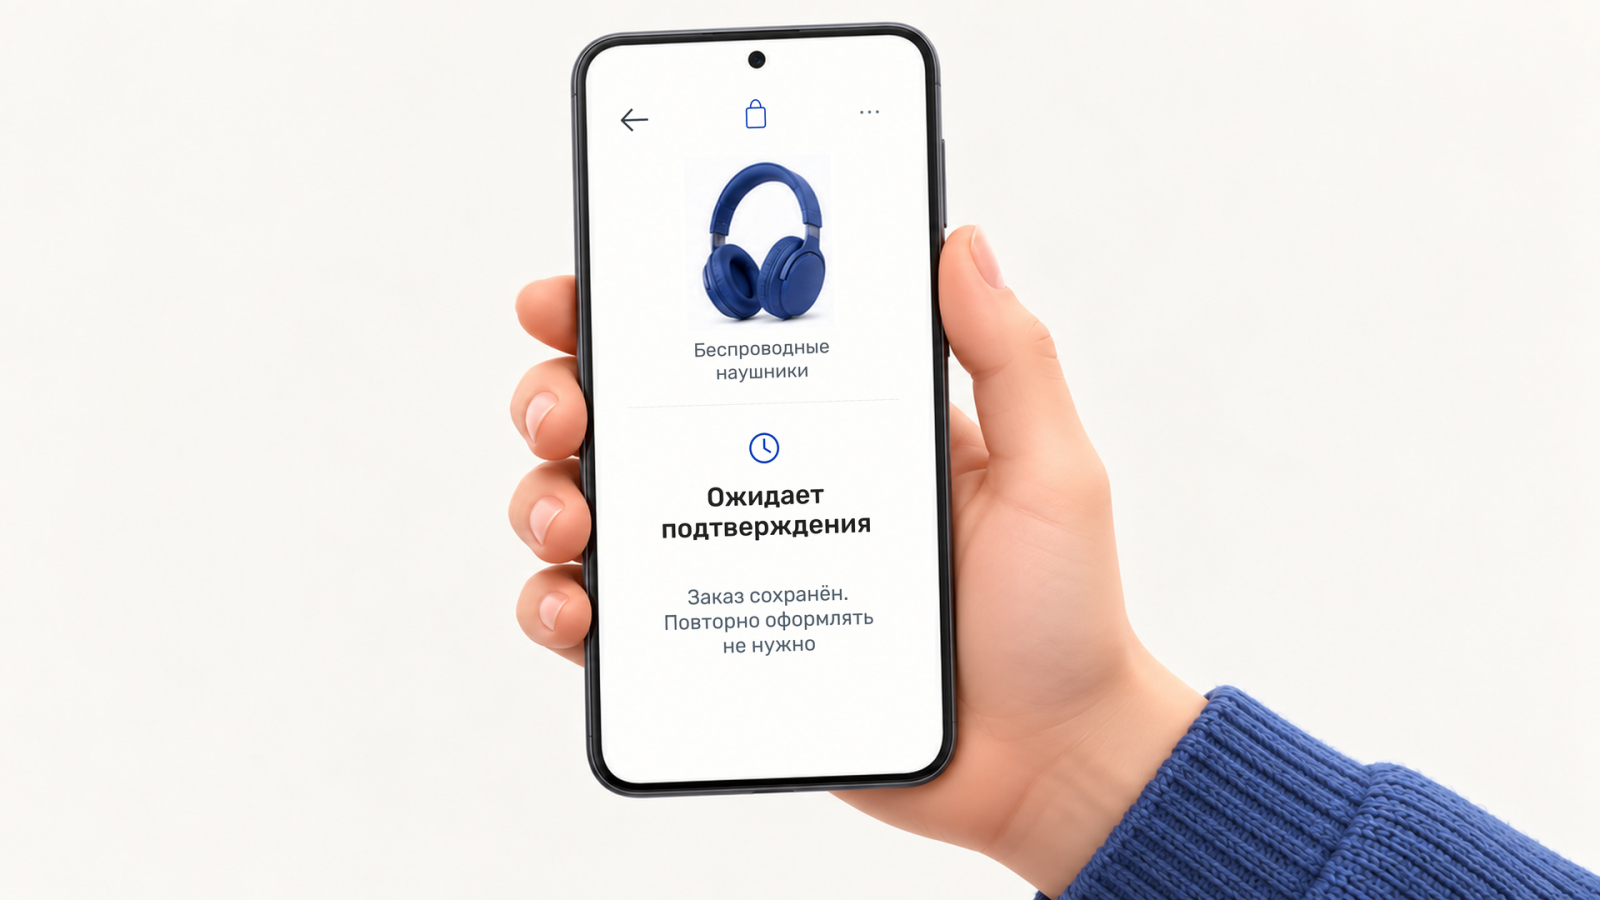
Вернитесь к ситуации с оплатой. Пользователь не обязан понимать, какой сервис ответил с ошибкой. Ему нужен достоверный результат: заказ принят, операция отложена или действие пока недоступно.
Правило можно сформулировать так: для каждого критичного сценария заранее фиксируйте минимальный полезный результат, режим при сбое и человека, который вправе его включить.
Если хотите разобрать один критичный путь до следующего инцидента, обсудите задачу с нами.