SEO-оптимизация с нейросетью и где проходит граница ее возможностей
Нейросеть ускоряет сбор семантики, кластеризацию, черновики, метаданные, разметку и технический аудит, но не выводит сайт в топ сама. Поисковики наказывают не происхождение текста, а отсутствие ценности и массовую генерацию без проверки. Отдельно показаны итоги экспериментов, правила снятия ограничений в Яндексе, риски, стоимость инструментов и вопросы к подрядчику.
Нейросеть может за минуты сгруппировать тысячи запросов, предложить десяток вариантов title, написать черновик статьи или правило переадресации для сервера. Но это не делает ее инструментом, который сам выводит сайт в топ. Поисковые системы оценивают результат: насколько страница полезна, точна, оригинальна и технически доступна. Способ ее подготовки не оценивается. Отсюда главный практический вывод. Нейросеть ускоряет работу специалиста там, где есть проверяемые входные данные и человек отвечает за итог. Там, где текст или код публикуют без проверки, она быстро производит то, что Google и Яндекс прямо описывают как признаки некачественного контента.
Дальше по порядку: что именно называют «нейросетью» в SEO, что требуют Google и Яндекс, на каких задачах генеративные модели полезны, что показывают эксперименты с ИИ-текстами, сколько стоят инструменты и как трезво оценивать коммерческие предложения «нейропродвижения».
Что называют нейросетью в SEO
Под словами «SEO с нейросетью» обычно смешивают четыре разные вещи. Если их не разделять, легко поверить в обещания, которые технически невыполнимы.
Генеративные модели
Это большие языковые модели вроде GPT, Claude, Gemini или YandexGPT. Они пишут текст, код, формулы, регулярные выражения и JSON-разметку. Ключевое свойство зафиксировано в документации Google для владельцев сайтов: генеративные модели не извлекают факты, а предсказывают вероятную последовательность слов на основе обучающих данных. Поэтому в их ответах встречаются правдоподобные, но ложные утверждения, так называемые галлюцинации. Для SEO это значит, что модель может уверенно назвать несуществующую частотность запроса, придумать характеристику товара или поле разметки.
Машинное обучение внутри SEO-сервисов
Специализированные платформы давно используют статистические и классификационные методы: векторные представления текста, сравнение семантической близости, кластеризацию, оценку покрытия темы. Здесь модель работает поверх реальных данных сервиса, то есть выдачи, краулинга или базы запросов. Поэтому ее результат проверяемее, чем ответ чат-бота «из головы».
Обычная автоматизация
Скрипты, парсеры, XPath-селекторы, планировщики задач и выгрузки по API к нейросетям не относятся. Они работают по жестким правилам и при одинаковых входных данных дают одинаковый результат. Многое из того, что продают как «нейро», на деле является именно такой автоматизацией. Это не плохо, но это другое.
Алгоритмы ранжирования поисковиков
Google и Яндекс сами применяют нейросети для понимания запросов и оценки страниц. Эти системы находятся на стороне поисковика. Владелец сайта не управляет ими напрямую и не может «подключиться» к ним. Обещание продвигать сайт «с учетом тысячи факторов ранжирования» описывает собственную методику исполнителя, а не доступ к алгоритму.
Обычное SEO и оптимизация под ответы ИИ
Отдельно обсуждают продвижение в генеративных блоках поиска: AI Overviews и AI Mode у Google, ответах ИИ-ассистентов. Это смежная, но другая тема. Для ясности достаточно одного факта: Google в документации об этих функциях пишет, что для попадания в них нет дополнительных требований и не нужна особая оптимизация. Не нужны отдельные машиночитаемые файлы, «ИИ-текстовые» файлы или специальная разметка schema.org. Страница должна быть проиндексирована и пригодна для показа в поиске со сниппетом. Ограничить использование содержимого можно теми же средствами, что и в обычном поиске: nosnippet, data-nosnippet, max-snippet, noindex. Дальше речь идет о применении нейросетей для обычного SEO.
Правила Google для контента с участием ИИ
Google работает глобально, и его правила относятся к органическому поиску во всех регионах, где сайт получает трафик из Google. Позиция компании последовательна с февраля 2023 года: использование ИИ само по себе не нарушает правила и не дает преимуществ. В разъяснениях Google сказано, что ИИ не приносит контенту никаких особых выгод: «это просто контент». Если он полезен, оригинален и соответствует критериям E-E-A-T (опыт, экспертиза, авторитетность, надежность), он может хорошо показать себя в поиске. Если нет, то нет.
Что запрещено на самом деле
Нарушением считается автоматизация, включая генеративный ИИ, если ее основная цель — манипулировать ранжированием. 5 марта 2024 года, вместе с мартовским базовым обновлением, Google ввел политику против злоупотребления масштабируемым контентом (scaled content abuse). Она заменила прежнее правило об «автоматически сгенерированном контенте» и расширила его.
Определение звучит так: злоупотребление возникает, когда множество страниц создается прежде всего для манипуляции поисковой выдачей, а не для помощи пользователям. Обычно речь о больших объемах неоригинального контента, почти не имеющего ценности, независимо от способа создания. Политика применяется одинаково к автоматизации, к ручной работе и к их сочетанию. Ферма низкооплачиваемых копирайтеров, штампующая однотипные страницы под запросы, нарушает ее так же, как скрипт с языковой моделью. Google поясняет, что расширение понадобилось потому, что по низкокачественному контенту не всегда понятно, создан ли он полностью автоматически.
Санкции описаны в том же объявлении. Сайты, нарушающие правила о спаме, могут ранжироваться ниже или вовсе не появляться в результатах. При ручных мерах владелец получает уведомление в Search Console и может запросить пересмотр. Для поиска спама Google использует несколько систем, в том числе SpamBrain.
Фактчекинг и метаданные
Отдельная страница Google о генеративном ИИ на сайте (последнее обновление 1 октября 2026 года) говорит, что такие инструменты особенно полезны для исследования темы и структурирования оригинального контента. Генерация множества страниц без добавленной ценности, напротив, может нарушать политику о масштабируемом контенте.
Там же Google называет «критически важным» вручную проверять факты и вычитывать весь сгенерированный контент перед публикацией. Проверка распространяется и на то, о чем часто забывают: элементы <title>, метаописания, структурированные данные и альтернативный текст изображений, потому что все это может появляться в результатах поиска. Для структурированных данных Google отдельно напоминает: нужно соблюдать общие и специальные правила для каждой функции поиска и валидировать разметку.
Юридически это руководство по качеству, а не отдельное техническое условие индексации. Никакой «галочки о фактчекинге» поисковик не проверяет. Но непроверенные ошибки, особенно в темах о здоровье, финансах и безопасности (YMYL), напрямую бьют по тем сигналам надежности, которые Google в таких темах взвешивает сильнее обычного.
Раскрытие использования ИИ и фальшивые авторы
Помечать ИИ-контент в органическом поиске Google не обязывает. В руководстве о полезном контенте (обновлено 5 октября 2026 года) сказано, что такие пояснения уместны там, где читатель может спросить себя «как это было создано», и их стоит добавлять, когда этого разумно ожидать. Если автоматизация использовалась существенно, Google предлагает задать себе вопросы. Очевидно ли посетителям использование ИИ? Объяснено ли, как и зачем он применялся?
Жесткая граница проходит в другом месте. Google прямо называет обманом фабрикацию профилей авторов: ИИ-фотографии, вымышленные имена, ложные регалии, создающие видимость, что текст написал эксперт-человек. Любой обман делает страницу недостоверной и для пользователей, и для автоматических систем качества и служит сигналом низкого качества. Генерировать текст можно, выдумывать «доктора наук» под ним нельзя.
Как Google понимает усилие и оригинальность
В том же руководстве перечислены характеристики основного контента, которые учатся оценивать асессоры. Это усилие, оригинальность, мастерство и точность. Пример малого усилия Google приводит сам: автоматическое создание страниц из фидов или генерация больших объемов текста ИИ без ручного надзора или курирования. Указание источников не заменяет собственного усилия. Ссылки на чужие материалы не превращают пересказ в оригинальный контент.
Google также перечисляет тревожные признаки контента, сделанного «для поисковика». Это обширная автоматизация для производства текстов на множество тем, пересказ чужого без добавленной ценности и подгонка текста под объем в расчете на «любимое количество слов», которого, по словам Google, нет. Отметка асессоров на ранжирование напрямую не влияет. Их работа помогает проверять, правильно ли действуют алгоритмы.
Merchant Center живет по другим правилам
Обязательная маркировка у Google есть, но не в органическом поиске, а в товарных фидах Merchant Center. Все изображения, созданные генеративным ИИ, должны содержать метаданные IPTC DigitalSourceType со значением TrainedAlgorithmicMedia. Такие теги нельзя удалять из файлов, сделанных в генеративных инструментах. Это касается полей основного, дополнительных и лайфстайл-изображений. Сгенерированные заголовки и описания товаров нужно передавать через отдельные атрибуты с указанием trained_algorithmic_media. Для интернет-магазина это значит: тексту на карточке товара метка не обязательна, а тот же текст в фиде для Google Shopping должен быть помечен.
Правила Яндекса и порядок снятия ограничений
Для сайтов, получающих трафик из Яндекса, в первую очередь из России, действуют правила Яндекс Вебмастера. Яндекс формулирует риск ИИ-текстов прямее Google, но логика похожа: наказывают отсутствие ценности, а не происхождение текста.
Малополезный контент
Яндекс определяет малополезный контент как информацию, которая не несет пользователю дополнительной ценности и не решает его задачу. Один из признаков звучит так: «текст выглядит как автоматически сгенерированный или не несет дополнительной ценности». В пояснении сказано, что нередко такой контент создается с помощью нейросетей, машинного перевода или шаблонных подстановок ключевых слов без дополнительного анализа и редактуры. При этом текст формально может быть оригинальным, но оставаться малополезным.
Яндекс называет четыре типичных признака:
- отклонение от темы или циклическое повторение одних и тех же рассуждений;
- предложения, добавленные ради объема без смысловой нагрузки;
- отсутствие практической пользы, например поверхностные рассуждения на основе заголовка страницы;
- подача вымышленных или непроверенных фактов как достоверных.
К той же категории относятся скопированный или переписанный с минимальными изменениями контент, сборка одной страницы из нескольких чужих, а также автоматически собранные каталоги без работающих фильтров и сортировки, с устаревшими данными. Малополезными при этом не считаются оригинальные описания товаров и услуг, официальные документы и стандарты, пресс-релизы и собственные тексты сайта, опубликованные в соцсетях.
Все четыре признака — типичные дефекты неотредактированного вывода языковой модели. Модель склонна к «воде», к повторам и к уверенным выдумкам. Поэтому для Яндекса вычитка не формальность. Именно редактура отличает допустимое использование нейросети от нарушения.
SEO-тексты и переспам
Отдельное нарушение — «Использование SEO-текстов», то есть текстов, ориентированных на робота. К ним относятся запросный спам (длинные списки запросов или бессвязные тексты с ключевыми словами), переоптимизация (избыточные повторы, раздувающие объем без пользы) и скрытый текст: белым по белому, микрошрифтом, через display: none или сдвиг за видимую область. Нарушением не считаются умеренное облако тегов для навигации, оправданные повторы в меню, каталогах и прайс-листах, повторы как языковая норма в стандартах и законах, а также сворачивание части текста для удобства, если ее можно раскрыть.
Нейросеть, которой поставили задачу «вписать все ключи», легко производит переоптимизированный текст. Поэтому список запросов стоит передавать модели как ориентир по теме, а не как обязательный перечень вхождений.
Малоценные страницы не санкция
В Вебмастере есть статус «малоценная или маловостребованная страница». Его часто путают с наказанием. Яндекс прямо пишет, что наличие таких страниц не означает нарушений и ограничений ранжирования. Алгоритм может не включить страницу в поиск, если она дублирует другую, не содержит видимого роботу контента или не отвечает на реальные запросы пользователей. Решение пересматривается регулярно, почти ежедневно. Квот на число страниц в индексе у Яндекса нет.
Исправлять такое исключение предлагается иначе, чем нарушение. Нужно проверить заголовки, убедиться, что важный контент не спрятан в картинку, iframe или JavaScript. Дубли стоит закрыть через rel="canonical", Clean-param, редирект или noindex. Если страница с содержимым не востребована, контент правят под реальный спрос, а темы ищут в статистике запросов Вордстата и Вебмастера. Массовая генерация страниц под запросы без спроса часто заканчивается не санкцией, а тем, что большая часть страниц просто не попадает в поиск.
Как узнать об ограничении и снять его
Ограничения за нарушения могут затрагивать весь сайт, и тогда при нарушении на родительском домене они действуют на все поддомены. Могут касаться и отдельных разделов, например страниц определенной тематики. Список нарушений с рекомендациями виден в Вебмастере в разделе «Оптимизация сайта → Безопасность и нарушения», а также среди ошибок в «Диагностике сайта». Если список пуст, ограничений нет.
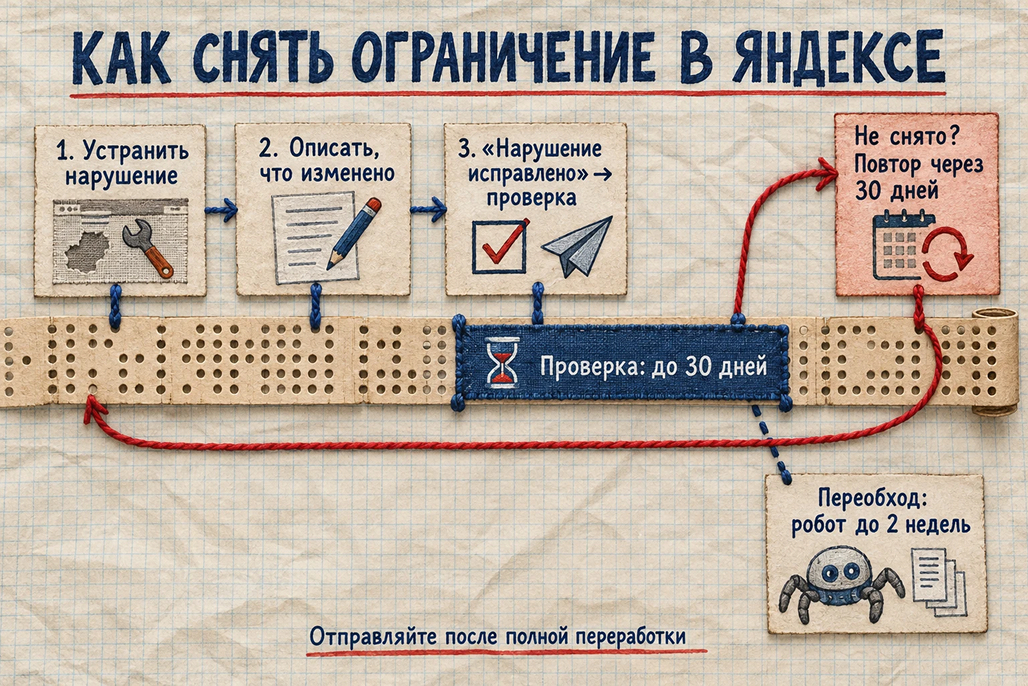
Порядок снятия описан в справке:
- устранить нарушение на сайте или в разделах;
- в блоке нарушения подробно описать, что изменено, и при необходимости приложить подтверждающие файлы;
- поставить отметку «Нарушение исправлено» и нажать «Отправить на проверку».
Срок проверки, по справке Яндекса, составляет до 30 дней. Если алгоритмы продолжают фиксировать нарушение, статус меняется на «Ограничение не снято». Повторно сообщить об исправлении можно только через 30 дней после предыдущей отправки, и до этого кнопка недоступна. Отсюда практический вывод: отправлять сайт на проверку стоит после полной переработки проблемных разделов, а не после косметической правки. Неудачная попытка обходится минимум в месяц ожидания. Ускорить обход измененных страниц можно через переобход в Вебмастере, и робот, по справке, приходит в течение двух недель.
Задачи, где нейросеть действительно помогает
Полезность генеративной модели определяется простым вопросом: на чем основан ее ответ. Если модель обрабатывает реальные данные (выгрузку запросов, HTML страниц, отчет краулера, CSV из Search Console или Метрики), результат можно проверить. Если она отвечает из обучающей выборки, это в лучшем случае гипотеза. Ниже основные SEO-задачи с тем, что для них нужно, что модель делает хорошо и где без человека нельзя.
Подбор запросов и семантика
Входные данные: выгрузки из сервисов реального спроса, например Вордстата, Google Keyword Planner, Ahrefs, Semrush, Букварикса или Key Collector.
Что получается хорошо: расширение списка формулировками и синонимами, гипотезы об информационных и коммерческих вариантах, чистка и нормализация списка, выделение мусорных фраз.
Ограничение: модель не знает реальной частотности, сезонности и кликабельности. Предложенные ею «ключи» могут иметь нулевой спрос.
Контроль: каждую гипотезу сверяют с базами спроса. Правильный порядок — сначала реальные данные, затем обработка моделью, а не наоборот.
Кластеризация и анализ выдачи
Входные данные: список запросов. Для смысловой группировки — векторные представления (эмбеддинги, например моделей OpenAI или Yandex AI Studio) или промпт к языковой модели. Для анализа конкурентов — HTML или текст страниц из топа, собранный краулером.
Что получается хорошо: разметка запросов по интенту (информационный, коммерческий, навигационный), группировка по смыслу, сравнение структуры заголовков конкурентов, поиск подтем, которые у вас не раскрыты.
Ограничение: смысловая близость не равна совпадению выдачи. Модель может отнести запрос к информационным, хотя в топе по нему стоят только каталоги магазинов. Оценивать коммерческие факторы (ассортимент, доставку, фильтры, удобство) по тексту модель не умеет.
Контроль: спорные кластеры проверяют по фактической выдаче, чтобы не поставить на одну посадочную страницу запросы с несовместимыми интентами.
Брифы, черновики и редактура
Входные данные: кластер запросов, требования к структуре, фактическая база компании (характеристики, цены, условия, кейсы), правила стиля.
Что получается хорошо: план статьи, список вопросов для блока FAQ, сокращение канцелярита, выравнивание тона, проверка читаемости, варианты подзаголовков.
Ограничение: без собственных данных модель выдает усредненный пересказ уже существующего, ту самую «воду» и поверхностные рассуждения на основе заголовка, которые Яндекс относит к признакам малополезного контента. Добавить реальный опыт, результаты тестов, фотографии процесса или собственные выводы она не может.
Контроль: фактчекинг каждого утверждения, добавление того, чего нет у конкурентов, и решение, публиковать ли текст вообще.
Title, description и alt
Входные данные: содержимое страницы, ключевые запросы, ограничения по длине. Для массовой работы — краулер с подключением модели по API.
Что получается хорошо: пачка уникальных вариантов под лимиты, описания изображений по контексту, черновики для A/B-сравнения.
Ограничение: выдуманные скидки, цены и характеристики, обрывы фраз, переспам. Google отдельно включает метаданные и alt в перечень того, что нужно вычитывать перед публикацией.
Контроль: выборочная проверка, обязательная для доходных страниц, и сверка с реальными ценами и офферами. В Яндекс Вебмастере качество и оригинальность заголовков и описаний можно проверить в разделе «Индексирование → Заголовки и описания».
Внутренняя перелинковка
Входные данные: данные краулинга, список продвигаемых страниц, тексты существующих материалов.
Что получается хорошо: поиск мест в старых статьях, где уместна ссылка на продвигаемую страницу, выявление страниц без входящих ссылок, предложения анкоров. В инструкции Screaming Frog описана настройка: краулер с подключенной моделью OpenAI проходит страницы и по заданному промпту ищет возможности для внутренних ссылок. На тестовом сайте примерно из 250 URL такой проход обошелся в 0,86 доллара. Авторы методики предупреждают, что на сайтах с тысячами и миллионами URL расходы становятся заметными.
Ограничение: неестественные или несогласованные анкоры, ссылки между страницами, которые связаны только формально.
Контроль: анкор-лист без перекоса в точные коммерческие вхождения и логика того, какие страницы на самом деле важны для бизнеса. Последнее модель знать не может.
Технический аудит и код
Входные данные: отчеты краулера, логи сервера, списки ошибок 4xx и 5xx, цепочки редиректов, robots.txt, sitemap.
Что получается хорошо: написание и разбор правил для .htaccess или Nginx, регулярных выражений, черновиков robots.txt, первичная группировка ошибок, объяснение непонятных директив.
Ограничение: чат-модель сама не обходит сайт, ей нужны готовые данные. Сгенерированная директива может оказаться ошибочной, и одна лишняя строка в robots.txt способна закрыть от индексации весь сайт.
Контроль: любые правила и скрипты сначала проверяют на тестовом окружении и в инструментах проверки robots.txt, и только потом переносят на рабочий домен.
Микроразметка
Входные данные: видимое содержимое страницы и спецификация нужного типа schema.org (Product, Article, Organization, LocalBusiness и других).
Что получается хорошо: быстрый черновик JSON-LD.
Ограничение: модель может придумать несуществующие свойства или вписать в разметку данные, которых нет на странице. Google требует, чтобы разметка соответствовала видимому тексту.
Контроль: валидация в Rich Results Test Google и в валидаторе микроразметки Яндекса, сверка каждого поля с видимым контентом.
Анализ данных сайта
Входные данные: выгрузки Search Console, Яндекс Метрики, GA4: клики, показы, CTR, позиции, конверсии.
Что получается хорошо: поиск просевших страниц, подозрения на каннибализацию запросов, сводные таблицы, формулы для таблиц.
Ограничение: арифметические ошибки, если модель считает «в уме», а не выполняет код. Ложные выводы о причинах без учета сезонности, обновлений алгоритмов и технических сбоев.
Контроль: пересчет ключевых цифр и интерпретация причин человеком, который знает, что происходило с сайтом и бизнесом.
Рабочий процесс от данных до замера результата
Задачи разные, но устойчивый процесс у них общий. Каждый шаг ниже закрывает конкретный риск, описанный в правилах поисковиков.
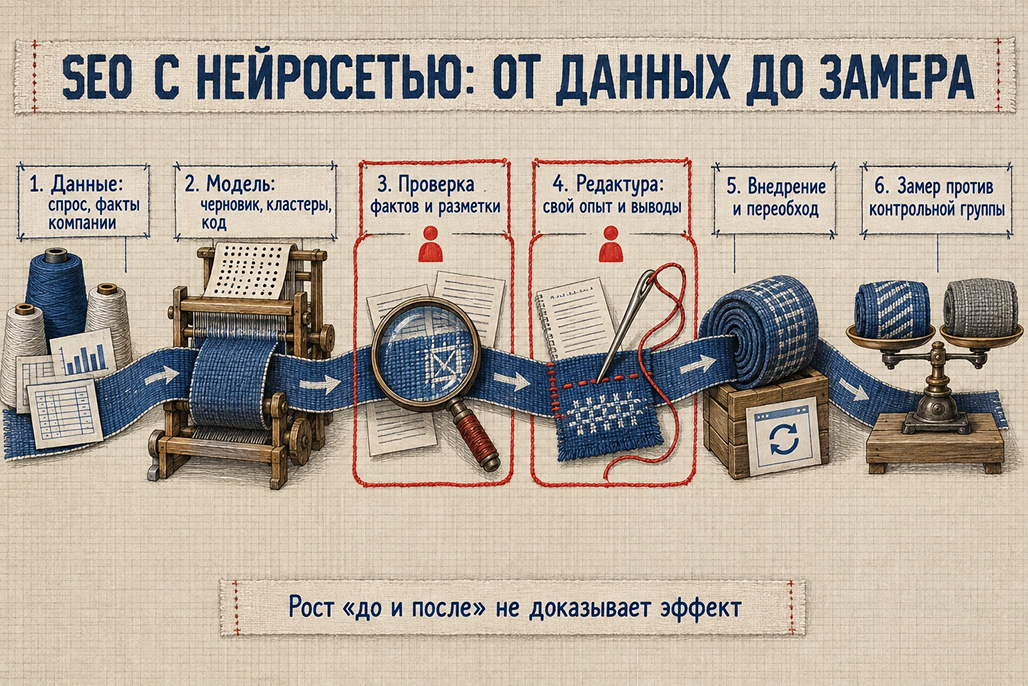
Дать модели материал, а не тему
Запрос «напиши статью про X» почти гарантирует усредненный текст. Модели нужны: утвержденная структура, реальные данные (характеристики продукта, условия, цены, результаты собственных тестов), список подтем, которые раскрывают конкуренты, правила стиля и запреты. Чем больше фактуры дает человек, тем меньше модели приходится «досочинять», а значит меньше галлюцинаций.
Проверить факты и оригинальность
Каждое фактическое утверждение сверяется с первоисточником или внутренними документами компании: цифры, даты, нормы, дозировки, технические параметры. Проверка на текстовые совпадения выявляет дословные заимствования. Но совпадения ничего не говорят о ценности текста. Яндекс прямо отмечает, что формально оригинальный текст может оставаться малополезным.
Отредактировать и добавить то, чего нет у других
Редактор убирает повторы, штампы и фразы ради объема, затем добавляет собственное: опыт, примеры, иллюстрации, выводы, мнение специалиста. Если текст подписан, подпись должна быть правдивой. Если существенная часть подготовлена автоматически и читатель может задаться вопросом, как он создан, имеет смысл коротко пояснить процесс.
Внедрить и отправить на переобход
Изменения вносят через CMS. Метаданные, разметку и техническую часть проверяют после выкладки. Затем измененные страницы отправляют на переобход в Google Search Console и Яндекс Вебмастере.
Измерить, а не поверить
Самая частая ошибка в оценке «нейро-SEO» — сравнение «до и после». Рост трафика после публикации не доказывает, что причиной стала нейросеть: в то же время могли выйти обновления алгоритмов, начаться сезон или измениться конкуренты. Надежнее сравнивать группы похожих страниц, где изменение внесено, с группой, где его нет, за один и тот же период. В идеале для каждой страницы фиксируют, какие инструменты использовались, сколько часов ушло на подготовку и редактуру, какие правки внес человек. Отдельно учитываются операционные показатели (время, затраты) и поисковые (индексация, показы, клики, позиции).
Что показывают эксперименты с ИИ-текстами
О том, «ранжируются ли нейротексты», написано много, но качественных экспериментов мало. Даже лучшие из них отвечают на узкие вопросы. Перед цифрами полезно понимать, как их читать.
Как отличить эксперимент от рекламы
Надежное исследование называет даты, число страниц и сайтов, способ распределения по группам, определение того, что считалось «ИИ-текстом», «гибридом» и «ручной работой», срок наблюдения и единицы измерения. Без контрольной группы на сопоставимых сайтах причинный вывод невозможен. В открытом доступе встречаются и эффектные «исследования» с точными процентами экономии времени и трафика, которые ссылаются на несуществующие работы и сохраняют в тексте неудаленные служебные пометки генератора. Цифры из таких материалов нельзя использовать как доказательство чего-либо. Большинство экспериментов проводят SEO-агентства и разработчики сервисов, то есть заинтересованные стороны. Это не делает их данные ложными, но требует внимания к методике.
Две тысячи неотредактированных статей на новых доменах
Разработчик SEO-платформы SE Ranking описал два отдельных теста. Отчет опубликован 19 марта 2026 года.
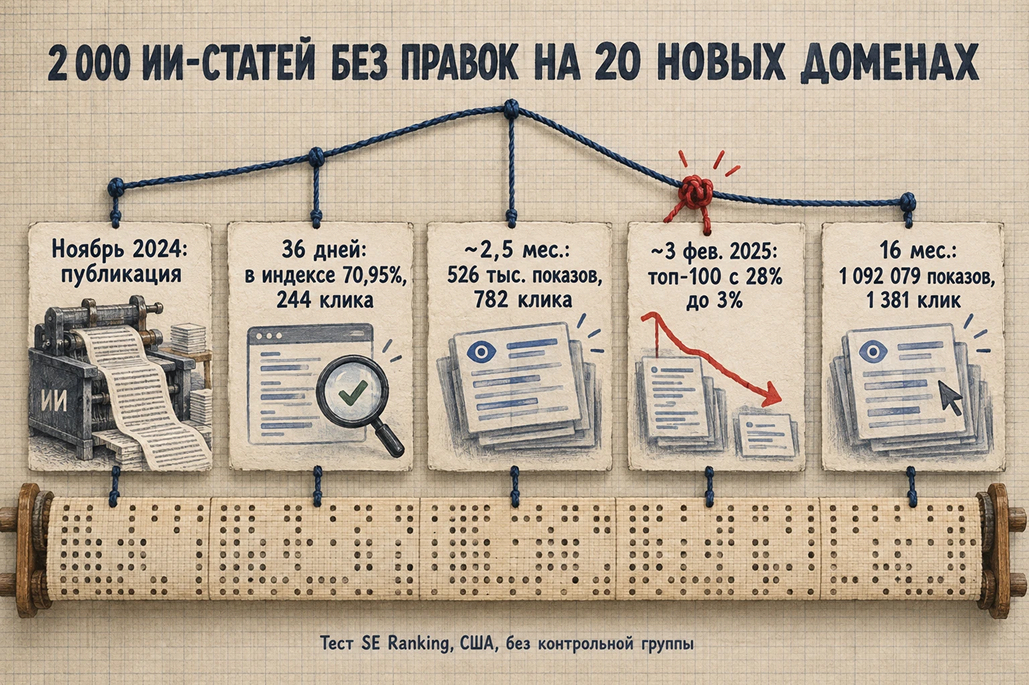
Основной тест. В ноябре 2024 года компания зарегистрировала 20 новых доменов, по одному на тематику, без истории и ссылок. На каждый 5–6 ноября 2024 года загрузили по 100 статей, сгенерированных в один клик собственным генератором без промптов, правок и изображений. Сайты были на WordPress с одинаковой бесплатной темой и плагином Yoast SEO, без внутренней перелинковки и без продвижения. Целевыми были информационные запросы «как сделать» с частотностью от 10 до 990, в среднем 106 в месяц. Отслеживание велось в США.
- Первые 36 дней — проиндексировано 1 419 из 2 000 страниц (70,95%), получено 122 102 показа и 244 клика. Восемь сайтов были видны по более чем тысяче запросов каждый.
- Около 2,5 месяцев — более 526 тысяч показов и 782 клика.
- Около 3 февраля 2025 года — резкий спад: доля страниц в топ-100 упала с 28% до 3%.
- Шесть месяцев — 706 тысяч показов и 1 062 клика, из них 70–75% набрано за первые 2,5 месяца.
- Шестнадцать месяцев — 1 092 079 показов и 1 381 клик в сумме. В индексе оставалось около 66,9% страниц, но видимость была минимальной.
В конце августа 2025 года, примерно во время августовского спам-обновления Google, у 10 из 20 сайтов был кратковременный всплеск показов. Шесть быстро его потеряли, четыре сохранили небольшое улучшение на уровне раннего периода. Ни один не вернулся к пиковым значениям.
Чего этот тест не доказывает. В нем нет параллельных сайтов с человеческими или отредактированными текстами по тем же запросам. Падение нельзя однозначно приписать «наказанию за ИИ». Оно так же совместимо с тем, как поисковик обходится с новыми доменами без ссылок, перелинковки, изображений и пользовательских сигналов. Время и деньги на подготовку не замерялись.
Второй тест. Шесть статей опубликовали с июня по сентябрь 2024 года в блоге самой компании, то есть на сильном домене. Черновики создавались генератором по детальному заданию: интент, аудитория, структура, ключевые вопросы. Затем их правила команда, специалисты по SEO проверяли факты, под каждой статьей стояла пометка об использовании ИИ. С июня 2024 по июль 2025 года статьи собрали почти 555 тысяч показов и более 2 300 кликов. Результаты неравномерны: одна статья дала 1 661 клик, другая 5 кликов и так и не поднялась выше сотой позиции. На 31 июля 2025 года три статьи из шести были в топ-10, четыре цитировались как источники в AI Overviews. Сами авторы оговаривают, что успех мог объясняться авторитетом домена.
Тесты на выдуманных запросах
Чтобы исключить влияние ссылок и истории сайтов, некоторые агентства придумывают несуществующий запрос и сравнивают тексты на одинаковых новых доменах.
Британское агентство Reboot Online, 2023 год. Десять новых доменов с одинаковой настройкой: пять с текстами людей, пять с текстами GPT-4 без правок. Три месяца ежедневного отслеживания позиций. Средняя позиция человеческих текстов составила 4,4, сгенерированных — 6,6. Оговорка самих авторов: ключевое слово искусственное, а выборка мала.
Российское агентство «АЙNET», результаты опубликованы в конце октября 2026 года. Под выдуманный запрос «липигидродация» зарегистрировали 10 доменов без истории и ссылок, сверстали одинаковые сайты на чистом HTML и CSS и запустили их одновременно на одном сервере. Пять текстов написали профессиональные бьюти-авторы по единому техзаданию. Пять сгенерировали Manus, ChatGPT, Perplexity, Gemini и DeepSeek по единому промпту. Все тексты оптимизировали одинаково, позиции фиксировали ежемесячно восемь месяцев в Яндексе и Google.
- Яндекс — в первые недели доля видимости авторских текстов составила 72,7% против 27,3%. Через четыре месяца разрыв почти исчез: доля нейросетевых текстов выросла до 45,5%, Manus и Gemini поднялись на первые два места. К восьмому месяцу у авторских текстов было 71,4% видимости и средняя позиция 4 против 28,6% и 8,2.
- Google — на старте обе группы были почти равны: 50,9% у сгенерированных и 49,1% у авторских. Через четыре месяца нейросети вышли вперед с 63,6%. К восьмому месяцу у авторских текстов было 67,3% видимости и средняя позиция 3,6 против 32,7% и 7,4.
- Разброс между моделями — текст Manus к концу теста был первым в Яндексе и третьим в Google. Текст Gemini сразу занял первое место в Google, держался там четыре месяца, а затем опустился на десятое.
Ценность таких тестов в чистоте условий, слабость в переносимости. У выдуманного запроса нет реальных пользователей, конкурентов и поведенческих сигналов, а выборка составляет по пять текстов в группе. Гибридный вариант, где нейросеть пишет, а человек редактирует, ни в одном из этих тестов не проверялся. Промежуточные результаты к тому же показывают, что выводы по первым неделям или месяцам могут оказаться противоположны итоговым.
Сплит-тесты на работающих сайтах
Самый строгий из доступных подходов — сплит-тест на живом сайте. Изменение вносят на часть однотипных страниц, а результат сравнивают с контрольной группой и прогнозом. Так исключается влияние сезона, обновлений алгоритма и изменений по всему сайту. Такие тесты публикует платформа SearchPilot.
Тест с пометкой об ИИ, опубликован 6 ноября 2025 года. Интернет-магазин добавил на карточки товаров, ниже первого экрана, блок «Product highlights» из 3–5 предложений. Модель писала его на основе существующего описания товара, а в конце стояла пометка «This content was generated by AI». Тест признан выигрышным: органический трафик вырос относительно контроля, пометка не помешала. Размер выборки, срок и величина эффекта в опубликованном кейсе не указаны. Важно и то, с чем сравнивали: карточки с дополнительным блоком против карточек без него, а не ИИ-текст против человеческого.
Тест на страницах листинга. На страницы-каталоги, где раньше почти не было текста, добавили сгенерированные описания, отрисованные и на сервере, и на клиенте, чтобы текст был в HTML при любом способе обхода. Оценочный прирост органических сессий составил 18%. Авторы объясняют эффект тем, что поисковику стало за что «зацепиться» на прежде пустых страницах. Это снова сравнение «текст против отсутствия текста».
Корреляции на больших выборках
Ahrefs в июле 2025 года проанализировал около 600 тысяч страниц из топ-20 по 100 тысячам случайных запросов и не нашел заметной связи между оценкой доли ИИ-текста и позицией. Коэффициент корреляции был близок к нулю. Это наблюдение, а не эксперимент: страницы уже были в выдаче, а доля ИИ определялась детекторами, которые сами ошибаются.
Что из этого следует
Сопоставление всех тестов дает осторожную, но последовательную картину.
- Массовая публикация неотредактированных текстов на новых сайтах может дать быстрый старт по индексации и показам, но в описанном эксперименте он не перешел в устойчивый трафик.
- В чистых тестах на выдуманных запросах человеческие тексты в итоге стояли выше, хотя отдельные сгенерированные тексты держались в лидерах.
- Полезный дополнительный контент, в том числе подготовленный моделью, на работающих сайтах может улучшать трафик, а пометка об ИИ этому не мешала.
- Авторство само по себе не выглядит решающим фактором. Решают ценность, точность и контекст сайта.
Строгого сравнения трех подходов (только нейросеть, нейросеть плюс редактура, только человек) на сопоставимых сайтах с прозрачным учетом затрат и повторением результата нет. Поэтому универсального правила вроде «гибрид всегда отстает от человека на столько-то процентов» быть не может.
Сколько времени и денег экономит нейросеть
Данных об экономии больше, чем о результатах в выдаче, но почти все они основаны на самоотчетах. Сервис Keyword.com опросил SEO-команды. Из 92 человек, ответивших на вопрос о сэкономленном времени, 89% сказали, что ИИ экономит команде не меньше четырех часов в неделю, а треть — больше десяти. Среди команд, где ИИ встроен в основную работу, 81% экономят не менее семи часов в неделю. Среди тех, кто только тестирует ИИ, сопротивляется ему или не использует его, таких 11%. Вывод авторов опроса сводится к тому, что выигрыш зависит от того, как выстроен процесс, а не от выбора инструмента. Ускоряются исследование, черновики и отчеты, а стратегию и проверку по-прежнему делают люди.
Это мнения респондентов, а не замер. Опрос не показывает, сколько времени уходит на проверку и исправление сгенерированного. Не показывает он и то, как экономия сказалась на позициях и выручке. Встречающиеся в рекламе расчеты вида «статья за два часа вместо десяти» без методики стоит воспринимать как ориентир, а не как доказанную окупаемость.
Прямые затраты на модели рассчитываются проще. Подписка на чат-интерфейс стоит фиксированную сумму в месяц, а работа по API оплачивается за объем текста (токены) отдельно от подписки. Пример с перелинковкой выше показывает порядок величин: несколько десятков центов за проход по сайту из сотен страниц, но кратно больше на крупных сайтах. Реальная статья расходов в процессе с нейросетью — часы квалифицированного редактора и специалиста. Без них, как показывают правила обоих поисковиков, сэкономленное на написании легко теряется на последствиях.
Риски, которые стоит учесть заранее
Ошибки и выдумки
Галлюцинации — не случайный сбой, а следствие устройства модели, и Google пишет об этом прямо. Самые опасные места: цифры, цены, юридические нормы, медицинские и финансовые утверждения, технические характеристики. Яндекс относит подачу вымышленных или непроверенных фактов как достоверных к признакам малополезного контента. В темах YMYL Google требует особенно высокой точности и соответствия устоявшемуся мнению экспертов.
Однотипность
Модель обучена на уже существующих текстах и по умолчанию воспроизводит среднее. Когда многие сайты делают одно и то же по одним запросам, получаются почти неразличимые страницы. Google в материалах о поиске с ИИ отдельно призывает делать уникальный, «нетоварный» контент, которого нет у других. Защита одна: собственные данные, опыт и выводы.
Масштаб как фактор риска
Нейросеть позволяет делать в сотни раз больше страниц, и именно объем без ценности описывает политика Google о масштабируемом контенте. Яндекс в таких случаях может наложить ограничение на раздел или весь сайт либо просто не включить большую часть страниц в поиск как маловостребованные. Чем больше страниц планируется создать автоматически, тем важнее заранее ответить, зачем каждая из них нужна человеку.
Конфиденциальность загружаемых данных
Условия обработки зависят от сервиса и тарифа. У OpenAI данные тарифов ChatGPT Business, Enterprise, Edu и API по умолчанию не используются для обучения моделей. В личных тарифах Free, Plus и Pro контент может использоваться для обучения, если не отключить «Improve the model for everyone» в настройках управления данными. Даже при отключении отзыв на ответ, то есть «палец вверх» или «вниз», может привести к использованию всего связанного диалога. Anthropic для коммерческих продуктов, включая API и Claude for Work, обещает не обучать модели на чатах, если клиент сам не согласился, например через участие в партнерской программе или отправку отзыва.
Отсутствие обучения на данных не означает, что данные нигде не хранятся и недоступны поставщику. Поэтому клиентские базы, персональные данные, закрытую финансовую отчетность и непубличную стратегию разумно не загружать в личные чат-аккаунты, а для рабочих данных выбирать корпоративные тарифы или API с понятными договорными условиями. Для российских компаний к этому добавляются требования законодательства о персональных данных и вопрос, в какой юрисдикции обрабатываются данные.
Оригинальность и права
Модель может воспроизвести фрагменты чужих текстов. Проверка на совпадения помогает поймать дословные заимствования, но не дает юридической гарантии и ничего не говорит о ценности текста. Универсального ответа об авторских правах на сгенерированный текст, одинакового для всех стран, нет. При значимых рисках, например в рекламе или юридически чувствительных материалах, вопрос стоит решать с учетом законодательства конкретной страны. Для товарных фидов Google действуют обязательные требования к маркировке, описанные выше.
Инструменты и их стоимость
Ниже небольшой набор инструментов, у которых SEO-применение подтверждено документацией. Цены публикует сам разработчик, и они часто меняются, поэтому перед покупкой их стоит сверить на странице тарифов.
Универсальные модели
- ChatGPT Plus (OpenAI) — подписка на веб-приложение за 20 долларов в месяц. Использование API оплачивается отдельно. Подходит для черновиков, редактуры, разбора выгрузок, скриптов и формул. Для рабочих данных есть тарифы Business и Enterprise, где данные по умолчанию исключены из обучения.
- Claude Pro (Anthropic) — 20 долларов в месяц при помесячной оплате в США или 17 долларов в месяц при годовой (200 долларов вперед). Налоги в указанную цену не входят. Тариф доступен только в поддерживаемых странах, в части регионов цена выставляется в местной валюте. API оплачивается за миллион токенов отдельно, цена зависит от модели.
- Yandex AI Studio — платформа Яндекса с моделями YandexGPT, эмбеддингами и API для генерации текста. Подписка Go стоит 2 490 рублей в месяц с НДС на пользователя, есть старшие варианты за 5 490 и 11 490 рублей. Работа с моделями по API оплачивается за тысячу токенов, причем цена зависит от модели и режима (синхронный, асинхронный, пакетный). Валюта зависит от договорной компании. Для клиентов российского юрлица Яндекс.Облака расчеты идут в рублях, и резиденты России могут платить только картами российских банков. Новым пользователям платформа предлагает стартовый грант 4 000 рублей.
Специализированные SEO-сервисы
- Screaming Frog SEO Spider — десктопный краулер для Windows, macOS и Ubuntu. Бесплатная версия обходит до 500 URL за проход, но без сохранения проектов, рендеринга JavaScript, пользовательского извлечения данных и API-интеграций. Платная лицензия стоит 199 фунтов в год на пользователя, в евро — 245 в год. При покупке от пяти лицензий действует скидка. В платной версии можно подключить OpenAI, Gemini, Anthropic или локальные модели через Ollama и LM Studio, настроить до 100 промптов к данным обхода: генерацию alt, анализ текста, извлечение данных. Можно указать собственный совместимый адрес API, в том числе приватной модели. Для промптов по тексту страницы нужно включить сохранение HTML. Токены оплачиваются отдельно поставщику модели по своему ключу. Gemini через AI Studio бесплатен в отдельных регионах, например в США и Великобритании, с разными лимитами запросов для бесплатных и платных аккаунтов.
- Surfer SEO — анализ выдачи, контент-план, редактор с рекомендациями по терминам, во старших тарифах внутренняя перелинковка и отчеты о каннибализации. При годовой оплате тарифы стоят 49 долларов в месяц (Discovery, 120 документов, одно место), 99 (Standard), 182 (Pro) и 299 (Peace of Mind). Скидка за год по сравнению с помесячной оплатой — до 17%. Интерфейс англоязычный, сервис ориентирован на Google.
- Semrush AI Writing Assistant — дополнение к экосистеме Semrush для генерации и проверки текстов с SEO-рекомендациями, 25 долларов в месяц.
Для русскоязычного продвижения в Яндексе по-прежнему нужны данные о спросе из Вордстата и Вебмастера. Нейросеть их не заменяет, а обрабатывает. Доступность и способы оплаты зарубежных сервисов зависят от страны пользователя, поэтому их стоит проверять до того, как строить на них процесс.
Компания Нейро-сайт и рынок нейропродвижения
Помимо инструментов на рынке есть агентства, которые продают продвижение с помощью нейросетей как готовую услугу. Один из российских примеров — сервис neirosite.com. Все сведения ниже взяты с его собственных страниц и из открытых реквизитов. Независимых подтверждений результатов в открытом доступе нет, поэтому это описание предложения, а не рекомендация и не доказательство эффективности.
Кто стоит за сайтом
На сайте используется название «Нейро-сайт». Собственную технологию компания называет нейросетью «Спелчат Бизнес» (Spellchat Business, Spell Chat Business). Оператор сайта и исполнитель по договору оферты — ООО «СОФТИНВЕСТ», Москва. По открытым данным, юрлицо зарегистрировано 14 декабря 2022 года, основной вид деятельности — рекламные агентства. На сайте сказано, что команда работает «с 2018 года». Эта дата предшествует регистрации нынешнего юрлица, так что, вероятно, речь о более раннем опыте команды, хотя на сайте это не уточняется.
Какие услуги заявлены
- «Нейро продвижение по SEO» — продвижение сайтов с использованием собственной нейросети, прежде всего в выдаче Яндекса. По описанию компании, семантическое ядро сначала собирается стандартными инструментами (Вордстат, Key Collector, Букварикс) и лишь затем загружается в нейросеть. Предмет оферты сформулирован как «услуги по использованию нейросети Spell Chat Business для повышения рейтинга сайта Заказчика».
- Нейроконтент — по словам компании, ИИ помогает готовить тексты, карточки услуг, статьи, FAQ и коммерческие блоки «под задачи SEO».
- «Нейро-сайты» и «Нейроменеджер» (SpellManager) — разработка сайтов со встроенным чат-консультантом «на базе GPT», который отвечает посетителям круглосуточно, уточняет потребности, собирает контакты и передает заявки в CRM.
- Яндекс Директ — ведение рекламы через API Яндекса с помощью собственного алгоритма «СпеллСтат», а также интеграции с Яндекс Услугами и Авито.
- Нейроаватары — промо-видео с цифровыми персонажами.
- Смежные проекты — на главной странице также представлены медицинский Telegram-бот SpellMed и ветеринарный консультант Mind.VET.
Цены на SEO
Компания публикует фиксированную тарифную сетку SEO-продвижения, ежемесячно и без НДС:
- «Старт» — 72 000 рублей. Для сайтов, у которых уже есть запросы в топ-40, до 100 приоритетных запросов. Внутренняя оптимизация не входит, доступы к сайту не требуются.
- «Стандарт» — 96 000 рублей, до 200 запросов.
- «Продвинутый» — 120 000 рублей, до 300 запросов.
- «Эксперт» — 150 000 рублей, до 500 запросов.
Тарифы и условия стоит сверять на сайте компании перед заключением договора.
Заявления, требующие проверки
На страницах сервиса есть рекламные утверждения, которые в открытом доступе не подтверждены независимыми данными с методикой, выборкой и сроками:
- «Продвижение сайта по SEO с помощью нейросети за несколько дней»;
- «Получаете заявки с 98% трафика, который идет на ваш сайт»;
- «Рост продаж до 50% благодаря повышению видимости в поиске»;
- на странице о нейро-сайтах — снижение нагрузки на отдел продаж на 60%, рост конверсии на 200–300% и снижение стоимости привлечения клиента в два раза;
- счетчики «700+» продвинутых сайтов, «500+» завершенных проектов и «120+» сотрудников;
- для SpellMed — средняя точность первичного анализа симптомов 87%.
Портфолио с проверяемыми кейсами, где были бы указаны сайт, период, исходные и итоговые показатели и способ замера, на сайте не представлено. На сторонней площадке отзывов есть несколько положительных отзывов с оценкой 5 из 5 и упоминаниями роста трафика. Проверить их достоверность и методику нельзя.
Сопоставление с правилами поисковиков помогает оценить такие обещания. Яндекс указывает срок проверки сайта после исправления нарушений до 30 дней. Эксперименты показывают, что даже резкий рост видимости новых страниц может смениться спадом через несколько месяцев. Обещание результата «за считанные дни» поэтому стоит уточнять у исполнителя: какие именно показатели, по каким запросам и как измерены. Заявленный порядок работы, где сначала собираются реальные данные о спросе и только потом подключается нейросеть, совпадает с общим принципом, описанным выше. Но качество и законность результата будут определяться тем, проверяет ли человек создаваемый контент и не приводит ли масштабирование к страницам без ценности.
Как выбрать подход и не навредить сайту
Решение «использовать нейросеть или нет» в SEO уже мало что значит. Значим другой вопрос: на каком участке, с какими данными и под чьим контролем. Несколько практических ориентиров, вытекающих из правил и экспериментов.
Если вы делаете SEO сами
- Начинайте с задач, где результат легко проверить: группировка запросов из реальных выгрузок, черновики метаданных, формулы и регулярные выражения, разбор отчетов краулера.
- Тексты используйте как черновик и материал для правки. Обязательно добавляйте собственные факты и опыт и проверяйте каждое утверждение.
- Не публикуйте сразу сотни страниц. Начните с небольшой группы, сравните ее с похожими страницами без изменений и смотрите на динамику за несколько месяцев, а не недель.
- Регулярно открывайте «Безопасность и нарушения» в Яндекс Вебмастере и отчеты о ручных мерах в Search Console. Отличайте нарушения от статуса малоценных страниц.
- Не загружайте персональные и коммерчески чувствительные данные в личные чат-аккаунты.
Если вы выбираете подрядчика
- Спросите, какие задачи выполняет нейросеть, а какие люди, и кто проверяет факты перед публикацией.
- Попросите кейсы с адресом сайта, периодом, исходными и итоговыми показателями из Search Console или Вебмастера и объяснением, как отделено влияние работ от сезона и обновлений поиска.
- Уточните, сколько страниц планируется создать и зачем каждая нужна пользователю. Массовая генерация — главный риск по правилам и Google, и Яндекса.
- Выясните, будут ли тексты подписаны и кем. Вымышленные эксперты Google прямо считает обманом.
- Для интернет-магазина с товарными фидами Google проверьте, соблюдается ли маркировка сгенерированных изображений и описаний в Merchant Center.
- Обещания конкретных позиций или процента заявок «за несколько дней» воспринимайте как маркетинговое утверждение до тех пор, пока не увидите проверяемые данные.
Нейросеть в SEO — мощный ускоритель рутинной и аналитической работы. Ни Google, ни Яндекс ее не запрещают, и ни один из них не дает за нее бонуса. Выигрывает тот, кто использует скорость модели, чтобы освободить время на то, чего она сделать не может: проверить, добавить собственное знание и решить, достойна ли страница появиться в поиске.