Продвижение сайтов с помощью ИИ и что реально работает в SEO
Нейросети ускоряют сбор семантики, черновики, технический аудит и перелинковку, но частотность, факты и итоговую группировку нужно брать из реальных данных. Также описаны правила Google и Яндекса для ИИ-контента, влияние нейроответов на трафик, итоги экспериментов с сырыми текстами, оценка заявлений подрядчиков и пошаговая схема работы.
Продвижение сайтов с помощью ИИ уже стало массовой практикой. В опросе Semrush среди 224 специалистов по SEO и контент-маркетингу 64% назвали основной схемой работы процесс, который ведёт человек, а ИИ ему помогает. Ещё 23% создают контент вообще без ИИ. Главным плюсом нейросетей 70% респондентов считают скорость, и только 19% говорят, что ИИ повышает качество.
Это расхождение между скоростью и качеством и определяет практический результат. Измерения последних лет показывают одно и то же. Нейросеть хорошо ускоряет обработку данных, черновики, разметку и рутинный аудит. Но сама по себе она не делает страницу полезнее для читателя и не даёт поисковой системе причин ставить её выше. Ниже по этапам описано, где ИИ в SEO экономит время, где ошибается, что о нём говорят официальные правила Google и Яндекса и как отличить измеренный результат от рекламного обещания.
ИИ в SEO — это три разные технологии
Под словами «ИИ для продвижения сайта» обычно скрываются технологии, которые работают по-разному и ошибаются по-разному.
- Генеративные языковые модели (LLM) — GPT, Claude, Gemini, YandexGPT, GigaChat, DeepSeek и подобные. Они пишут и переписывают текст, классифицируют запросы по смыслу, предлагают структуру страницы, генерируют метатеги и код разметки. Их слабое место в том, что модель не извлекает факты, а предсказывает правдоподобную последовательность слов. Отсюда ошибки, которые называют галлюцинациями.
- Векторные представления, или эмбеддинги. Модель превращает текст страницы или абзаца в набор чисел, отражающий смысл. Близость таких векторов (обычно её считают через косинусное сходство) показывает, насколько страницы похожи по теме, даже если в них разные слова. На этом построены поиск смысловых дублей, подбор внутренних ссылок и сопоставление страниц при переезде сайта.
- Классические алгоритмы и автоматизация: кластеризация запросов по совпадению адресов в выдаче, парсинг, краулинг, сбор позиций, сведение таблиц. Здесь нет генерации текста. Результат воспроизводим и опирается на реальные данные поисковых систем.
Различие важно на практике. Когда сервис «группирует запросы нейросетью», стоит уточнить, по какому принципу он это делает: по смыслу слов или по тому, какие страницы поисковик показывает по каждому запросу. Когда инструмент «пишет мета-описания», стоит знать, что модель может приписать странице обещание, которого на ней нет. Почти все удачные схемы применения ИИ в SEO устроены одинаково: цифры берутся из реальных систем (Вордстат, Яндекс Вебмастер, Google Search Console, Метрика, краулер), а модель их обрабатывает, группирует и оформляет.
Нейросети для подбора ключевых слов и поискового интента
Где модель полезна
На этапе семантики языковая модель хорошо выполняет три задачи. Она предлагает формулировки, которыми клиенты ищут товар или услугу: разговорные варианты, синонимы, вопросы, запросы с названием города. Она размечает готовый список запросов по типу намерения: информационный («как выбрать», «сколько стоит»), коммерческий («заказать», «цена», «под ключ»), локальный. И она делит сотни запросов на смысловые группы и предлагает для каждой формат страницы и заголовок.
Типичная рабочая схема выглядит так. Запросы выгружаются из Вордстата, Key Collector, Keys.so или Search Console вместе с частотностью. Файл загружается в модель с задачей сгруппировать фразы по интенту и будущим страницам и отсортировать кластеры по суммарной частотности. Модель не придумывает спрос, а структурирует уже измеренный.
Почему частотность нельзя брать у модели
Самая частая ошибка — спросить у чат-бота, сколько раз в месяц ищут фразу. У модели без подключённых данных нет доступа к статистике поисковиков, и цифры она выдумывает. В тесте, проведённом в мае 2025 года, Gemini просили отнести запросы к одной из пяти «корзин» по объёму, а ответы сверяли с показами в Search Console. Точную корзину модель назвала примерно в 35% случаев. Размер выборки и версия модели в описании теста не раскрыты, поэтому это ориентир, а не точная оценка. В другом тесте 2024 года GPT-4o назвала высокочастотными запросы «домен для сайта» и «облачный хостинг», хотя по Вордстату соседние «купить домен» и «арендовать сервер» популярнее.
Практичное правило простое: у модели можно просить уровни спроса (высокий, средний, низкий) и идеи формулировок, а числа брать только из Вордстата или другого инструмента. При этом фиксируются регион, тип соответствия и дата замера. Частотность в разных регионах и поисковых системах отличается, поэтому без этих условий цифра ничего не значит.
Смысловая группировка против группировки по выдаче
Вторая ловушка менее заметна. Языковая модель объединяет запросы, которые похожи по смыслу. Поисковая система объединяет запросы, по которым показывает одни и те же страницы. В одном из тестов «лучший веб-хостинг» и «дешёвый хостинг» попали у модели в один кластер, хотя выдача по ним разная. Если продвигать такие запросы одной страницей, она будет хуже соответствовать ожиданиям по одному из них.
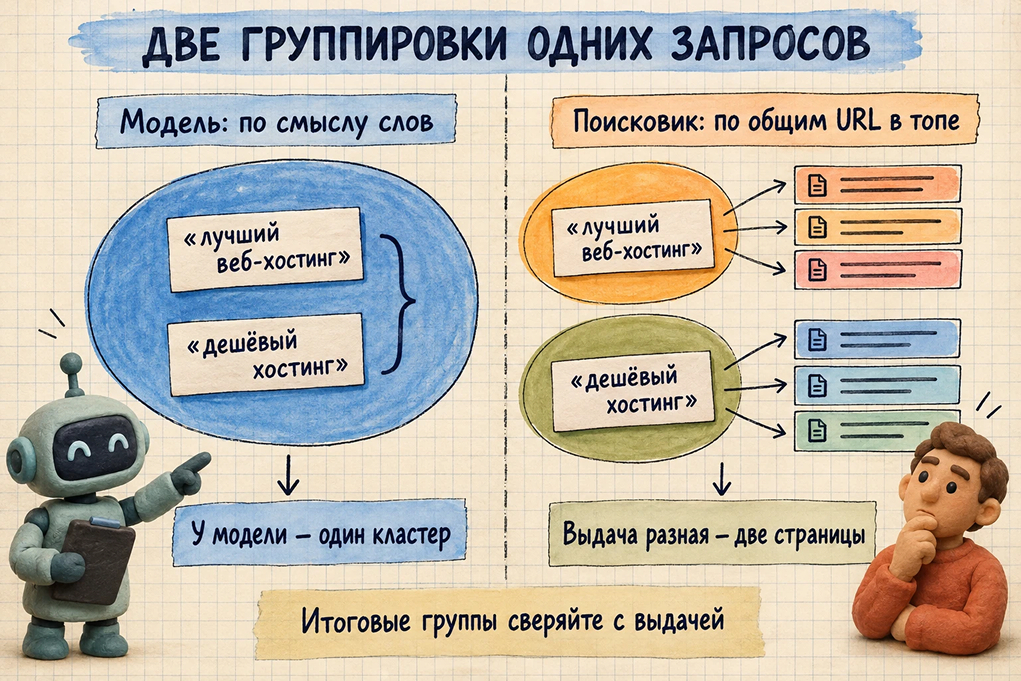
Поэтому профессиональные инструменты для Рунета чаще кластеризуют по выдаче. Например, кластеризатор Just-Magic работает строго по методу hard: запросы объединяются по совпадению адресов в топе Яндекса. Для каждой фразы сервис оценивает степень коммерческости по шкале от 0 до 1, геозависимость и тематику. Модуль расширения ядра принимает до 100 000 фраз на входе и выгружает до 200 000. Это классическая алгоритмическая обработка данных выдачи, а не генерация. Разумная комбинация такая: модель предлагает идеи и черновую разметку интента, а окончательные группы сверяются с выдачей хотя бы по нескольким запросам из каждого кластера.
Похожий порядок работы описывает и neirosite.com, российский сервис нейро-продвижения бренда Spellchat Business. На странице SEO-услуг компания указывает, что семантическое ядро собирается через Яндекс.Вордстат, Key Collector и Букварикс и только потом загружается в собственную нейросеть «Спелчат Бизнес». Это заявление самой компании о методике, но оно совпадает с общим принципом: сначала реальные данные о спросе, затем обработка.
Контент с нейросетями от черновика до публикации
Что можно поручить модели
В создании контента ИИ полезен на этапах, где результат легко проверить: план статьи по техническому заданию, первый черновик, варианты заголовков и Title, FAQ по списку реальных вопросов клиентов, описания категорий и товаров по готовым характеристикам, переписывание сложного абзаца простым языком. Российские сервисы закрывают эти задачи прямо в интерфейсе. Например, ИИ-генератор «Пиксель Тулс» создаёт Title, Description и H1, статьи, тексты для категорий и карточек товаров и поддерживает массовую генерацию по шаблонам на разных моделях, включая ChatGPT, YandexGPT, GigaChat и DeepSeek. В описании своего инструмента разработчик сам предупреждает, что сгенерированный контент чаще всего требует фактчекинга и редактуры.
Что остаётся за человеком
Модель не знает того, что делает страницу ценной именно для вашего сайта: реальных цен и условий, опыта работы с клиентами, ошибок, которые вы видели на практике, собственных фотографий, расчётов и результатов. Именно эти элементы отличают полезную страницу от пересказа уже опубликованного. По наблюдениям практиков, хорошо работают такие сочетания:
- Модель делает структуру и первый проход по тексту, человек проверяет каждый факт, каждую цифру и дату по первичному документу.
- Эксперт добавляет то, чего нет в интернете: собственные данные, случаи из практики, скриншоты, разбор конкретной ошибки.
- Редактор работает со смыслом, а не только с грамматикой: убирает «воду» и общие фразы, проверяет, что текст действительно отвечает на запрос.
- Проверка проходит до публикации, а не после того, как страницу проиндексировали.
В блоге самой Semrush, по словам руководителя контент-стратегии компании, над каждой статьёй работают минимум три человека (стратег, автор и редактор), а редактура полностью остаётся за людьми.
Детекторы ИИ-текста
Многие сервисы, включая «Пиксель Тулс», предлагают проверку текста на генерацию. Такой инструмент выдаёт вероятность, а не доказательство. Во время эксперимента Reboot Online сначала ни один из детекторов не распознал тексты, написанные свежей на тот момент GPT-4, а через несколько месяцев те же тексты определялись гораздо увереннее. Высокая оценка детектора — повод перечитать текст внимательнее, но не вердикт. Низкая оценка не гарантирует, что текст полезен.
Техническая оптимизация сайта с помощью ИИ
Краулер с подключённой моделью
Наиболее зрелые сценарии ИИ в техническом SEO встроены в краулеры. Screaming Frog SEO Spider позволяет подключить API OpenAI, Gemini и Anthropic, а также локальные модели через Ollama или LM Studio. Можно настроить до 100 собственных промптов, которые выполняются для каждой страницы во время обхода. Типичные задачи: генерация alt-текстов для изображений, анализ языка, тональности и интента страницы, извлечение данных, получение эмбеддингов контента. Промпты можно запускать только для определённых сегментов адресов, чтобы не тратить кредиты API на лишние страницы.
С версии 22.0 тот же краулер использует эмбеддинги для нескольких задач:
- Смысловые дубли. Фильтр Semantically Similar показывает для каждой страницы ближайший по смыслу адрес, оценку сходства и число похожих страниц. Он находит пересечения, которые обычная проверка дублей по совпадению текста пропускает: две статьи на одну тему, конкурирующие за одни запросы.
- Страницы не по теме. Фильтр Low Relevance усредняет эмбеддинги всех страниц, находит «центр» тематики сайта и показывает материалы, которые от него далеко отклоняются.
- Карта кластеров. Двумерная диаграмма показывает, как страницы группируются по смыслу и какие из них остаются в стороне.
- Смысловой поиск. Запрос превращается в вектор, и краулер находит самые близкие по смыслу страницы сайта, а не просто совпадения слов.
- Карта редиректов. При переезде или смене структуры эмбеддинги помогают подобрать для старого адреса наиболее близкую новую страницу, даже если текст переписан.
Для работы нужны платная лицензия, ключ API выбранного провайдера и включённое сохранение HTML и отрендеренного HTML: текст страницы должен попасть в базу краулера до расчёта векторов.
Метаданные и разметка требуют такой же проверки
Сгенерировать сотни Title и Description по шаблону легко. Но Google в своей справке по генеративному контенту прямо распространяет требование ручной проверки на метаданные: элемент title, мета-описание, структурированные данные и альтернативный текст изображений. Всё это может появиться в результатах поиска. Для структурированных данных Google дополнительно требует соблюдать общие правила и правила конкретных поисковых функций и проверять разметку валидатором. В Яндекс Вебмастере для этого есть валидатор микроразметки, а для проверки того, как робот увидел страницу, — инструмент «Проверка страницы».
Разметку при этом не стоит переоценивать. Яндекс прямо указывает, что робот проиндексирует информацию и без разметки и на показ страниц в поиске это не повлияет. Разметка помогает сформировать сниппет, но Яндекс не гарантирует, что размеченные данные появятся в выдаче. Для некоторых типов, например каталогов товаров, обработка формата JSON-LD не гарантируется.
Перелинковка на основе эмбеддингов
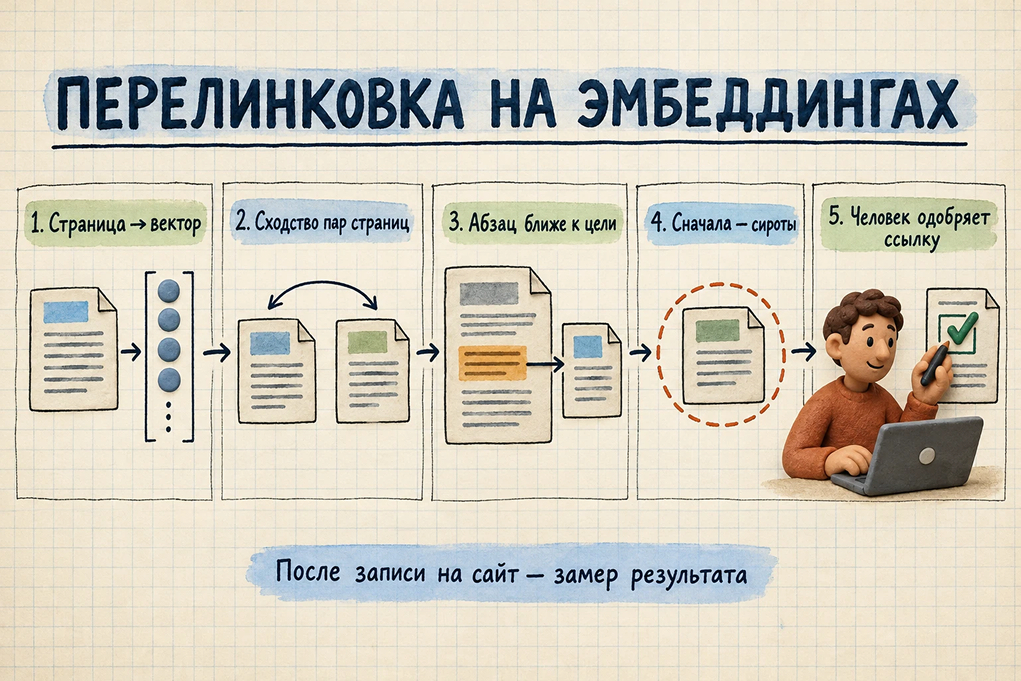
Внутренняя перелинковка — одна из самых трудоёмких задач на большом сайте, и здесь машинные методы дают ощутимую экономию. Схема с эмбеддингами выглядит так:
- Каждая страница (заголовок и первые несколько сотен слов) превращается в вектор.
- Для каждой пары страниц считается косинусное сходство. Пары, которые похожи по теме, но ещё не связаны ссылкой, становятся кандидатами.
- Внутри исходной страницы векторизуется каждый абзац, и выбирается тот, что ближе всего к целевой странице: так ссылка встаёт в подходящее место текста, а не в случайное.
- Приоритет получают страницы с наименьшим числом входящих ссылок, в первую очередь «сироты», на которые не ведёт ни одна внутренняя ссылка.
Эмбеддинги показывают, о чём страницы. Search Console добавляет то, чего векторы не знают: по каким запросам Google уже показывает страницу и насколько она близка к топу. На примере блога из 79 статей такой скрипт превратил 242 запроса «на подступах» к первой странице в 110 предложений по ссылкам за несколько секунд, без всяких эмбеддингов.
Модель также может предложить анкор. Но решение о том, ставить ли ссылку, должен принимать человек. Перелинковка должна помогать читателю дойти от статьи к нужной услуге, а не перегружать текст. Перед записью изменений на сайт нужен шаг ручного одобрения, а после — замер результата.
Аналитика, каннибализация и конверсия
Разбор выгрузок вместо ручного сведения таблиц
В аналитике модель полезна тогда, когда ей передают реальные данные. Если загрузить выгрузку с запросами, позициями, частотностью и адресами из сервиса мониторинга, модель найдёт типичные проблемы: целевая страница не ранжируется, а вместо неё поисковик показывает другую, или одна страница забирает запросы, предназначенные нескольким. Конфликты разумно сортировать по частотности: каннибализация по высокочастотным и трафиковым запросам вреднее всего. Так же модель находит страницы, теряющие трафик, запросы с большим числом показов и низкой кликабельностью, резкие изменения после обновления сайта.
Граница здесь та же, что и в семантике: качество вывода не может быть выше качества переданных таблиц. А решение о том, что стало причиной просадки (обновление алгоритма, технический сбой или сезонность), остаётся за специалистом.
Консультанты на сайте и конверсия трафика
Чат-боты и голосовые ассистенты на основе языковых моделей не приводят посетителей из поиска. Их задача — обработать тех, кто уже пришёл: ответить на вопрос ночью или в выходные, помочь выбрать услугу, собрать контакт. Это направление прямо связано с продвижением: заявка из органического трафика засчитывается только если посетитель её оставил.
Компания neirosite.com делает эту часть одним из главных направлений. Она предлагает «нейро-сайты» со встроенным ИИ-консультантом, ИИ-менеджера SpellManager, который сам начинает диалог с посетителем, голосовой ИИ, а также видеосвязь и нейроаватаров для презентации продукта. По описанию компании, клиент после обучения ИИ может сам редактировать его базу знаний. На главной странице сервис обещает, что заказчик «получает заявки с 98% трафика», а на странице нейро-сайта — что ИИ «собирает контакты в 3 раза чаще». Эти формулировки — заявления самой компании. На сайте не раскрыто, как считались такие показатели, с какой базой их сравнивали и на каких проектах. Поэтому их стоит воспринимать как маркетинговое обещание, а не измеренный результат.
Для любого ИИ-консультанта действует одно ограничение: модель может упростить тарифы, условия акции или юридические оговорки так, что ответ разойдётся с реальным предложением. Перед запуском стоит прогнать бота по вопросам о ценах, гарантиях и сроках и сверить ответы с документами компании.
Платный поиск и генерация объявлений
В контекстной рекламе генерация уже встроена в сами рекламные кабинеты. В Яндекс Директе YandexGPT строит текст объявления по содержимому посадочной страницы и сведениям о бизнесе. Интерфейс генерации устроен вокруг выбора и правки вариантов. В нейрообъявлениях, где отдельный текст править нельзя, контроль идёт через фразы-исключения, удаление неподходящих вариантов и аккуратный контент самой посадочной страницы. Модерация проверяет объявления на соответствие требованиям, но не отвечает за точность обещаний.
Отдельная услуга neirosite.com — ведение рекламных кампаний в Яндекс Директе через официальный API с помощью собственного алгоритма «СпеллСтат». Компания также заявляет о настройке интеграций с Яндекс Услугами и Авито, чтобы объявления быстрее обновлялись и тестировались.
Ссылки и outreach с помощью ИИ
Для внешней оптимизации появились ИИ-агенты: они ищут сайты-доноры, находят контакты, анализируют публикации на сайте и пишут персонализированные письма вебмастерам. Цены начального уровня у таких сервисов обычно составляют десятки долларов в месяц. Платформы для агентств стоят дороже: Pitchbox, например, начинается с 300 долларов в месяц или 210 долларов в месяц при годовой оплате, и в этот тариф входит 2000 писем в месяц. Это англоязычный рынок, и такие цены часто меняются.
Автоматизировать можно поиск и первичное письмо. Остальное — выбор донора, проверку его качества, условия размещения и текст ссылки — должен контролировать человек. Здесь ИИ ускоряет процесс, но не снимает риск, потому что правила обеих поисковых систем жёстко относятся к ссылкам, купленным ради позиций.
- Google относит к ссылочному спаму покупку и продажу ссылок для ранжирования, в том числе обмен товаров и услуг на ссылки, чрезмерный обмен ссылками, использование автоматических программ для создания ссылок, а также гостевые статьи и пресс-релизы с оптимизированными анкорами. Коммерческие ссылки допустимы, если они помечены атрибутом rel="sponsored" или rel="nofollow".
- Яндекс считает нарушением размещение SEO-ссылок, в частности купленных через ссылочные биржи и агрегаторы, и указывает последствие — понижение в результатах поиска. Для ссылок, оставленных пользователями, рекомендован атрибут rel="ugc", для рекламных и партнёрских — rel="sponsored", закрыть ссылку от учёта можно атрибутом rel="nofollow". Против SEO-ссылок работает алгоритм «Минусинск»: в первой волне он понизил 488 сайтов в среднем на 20 позиций, а последующие итерации, по сообщению Яндекса, проходят без предупреждений.
Агент, который рассылает тысячи писем с предложением «разместить ссылку за вознаграждение», лишь быстрее воспроизводит практику, которую обе системы называют спамом. Полезное применение — поиск площадок, где ссылка уместна для читателя: обзоры, справочники отрасли, профильные медиа, упоминания бренда без ссылки.
Правила Google для ИИ-контента
Наказывают не за способ создания
Позиция Google сформулирована последовательно. Компания пишет, что генеративный ИИ особенно полезен для изучения темы и для структурирования оригинального контента. Нарушением считается не сам факт использования ИИ, а использование автоматизации, в том числе ИИ, с основной целью манипулировать ранжированием. Google подчёркивает, что ИИ не даёт контенту никаких особых преимуществ: если материал полезен, оригинален и отвечает критериям опыта, экспертности, авторитетности и надёжности (E-E-A-T), он может хорошо показать себя в поиске, если нет — не покажет.
Злоупотребление масштабированием контента
Ключевое правило — политика против злоупотребления масштабированием контента (scaled content abuse), введённая в марте 2024 года. Она заменила прежнюю политику против автоматически сгенерированного контента. Нарушением считается создание множества страниц главным образом ради манипуляции позициями, а не помощи людям, независимо от того, сделаны они автоматически, людьми или в комбинации. Среди примеров в спам-политиках Google:
- генерация множества страниц инструментами генеративного ИИ без добавленной ценности для пользователя;
- парсинг лент, результатов поиска или чужого контента с автоматическими преобразованиями — синонимизацией, переводом и подобными приёмами;
- склейка контента с разных страниц без добавленной ценности;
- создание нескольких сайтов, чтобы скрыть масштабный характер контента;
- страницы, которые бессмысленны для читателя, но содержат ключевые слова.
Нарушения выявляются автоматическими системами и, при необходимости, людьми, что может привести к ручным мерам. Сайт может опуститься в результатах или вовсе исчезнуть из них. О ручной мере владелец узнаёт в Search Console и может после исправления подать запрос на повторную проверку.
Точность, прозрачность и электронная коммерция
Google отдельно напоминает, что генеративные модели не извлекают факты, поэтому крайне важно вручную проверять весь ИИ-контент до публикации. Компания советует добавлять пояснения о том, как создавался контент, там, где читатель разумно может задаться вопросом «как это сделано», и указывать автора там, где этого ожидают.
Для интернет-магазинов, работающих с Google Merchant Center, правила строже. Изображения, созданные ИИ, должны содержать метаданные IPTC DigitalSourceType со значением TrainedAlgorithmicMedia. Сгенерированные ИИ атрибуты товара, например название и описание, нужно передавать отдельно и помечать как созданные ИИ. Это требование Merchant Center, а не общее правило для редакционных текстов в обычном поиске.
Как Яндекс оценивает тексты, созданные нейросетью
В справке Яндекс Вебмастера проблема описана через понятие малополезного контента, то есть информации, которая не несёт пользователю дополнительной ценности и не решает его задачу. Один из признаков такого сайта сформулирован так: текст выглядит как автоматически сгенерированный или не несёт дополнительной ценности. Яндекс поясняет, что такой контент нередко создаётся с помощью нейросетей, машинного перевода или шаблонных методик подстановки ключевых слов без дополнительного анализа и редактуры. Формально такой текст может быть оригинальным, но оставаться бесполезным для читателя.
Типичные признаки по версии Яндекса:
- отклонение от темы или циклическое повторение одних и тех же рассуждений;
- предложения, добавленные ради объёма без смысловой нагрузки;
- отсутствие практической пользы, например поверхностные рассуждения на основе заголовка страницы;
- вымышленные или непроверенные факты, поданные как достоверные.
Этот перечень почти дословно описывает типичные недостатки сырого текста из языковой модели. Поэтому вывод для практики прямой: нейросеть упоминается как частый инструмент создания малополезного текста, но условием нарушения названы отсутствие анализа, редактуры и пользы. Текст, который прошёл экспертную проверку, содержит достоверные факты и решает задачу читателя, под эти признаки не подпадает. В разделе «Признаки некачественного сайта» Яндекс упоминает «автоматически сгенерированный (бессмысленный) текст» и неоригинальный вторичный контент, а среди возможных ограничений называет исключение страниц из поиска и понижение в результатах.
Масштаб имеет значение. Яндекс поясняет, что сайт может быть признан малополезным, если на нём по-настоящему много заимствованного контента, агрессивной рекламы или спама, а пара неоригинальных публикаций на большом ресурсе к такой санкции не приведёт. Оповещение появляется в Вебмастере в разделе «Безопасность и нарушения». После исправлений владелец нажимает кнопку «Я всё исправил», и сайт проверяется повторно. Если владелец считает, что контент ошибочно признан малополезным, можно обратиться в поддержку.
AI Overviews, AI Mode и Поиск с Нейро
Условия попадания в ИИ-ответы Google
На вопрос о специальной оптимизации под ИИ-ответы Google отвечает прямо: дополнительных требований для появления в AI Overviews или AI Mode нет. Чтобы страница могла стать ссылкой-подтверждением, она должна быть проиндексирована и иметь право показываться в Google Search со сниппетом. Google отдельно пишет, что для этих функций не нужно создавать новые машиночитаемые файлы, специальные текстовые файлы для ИИ или разметку, а также добавлять особую разметку Schema.org. Даже выполнение всех требований не гарантирует, что страница будет просканирована, проиндексирована и показана.
Google рекомендует проверить базовые вещи: сканирование разрешено в robots.txt и не блокируется CDN или хостингом, важный контент доступен в текстовом виде и находится по внутренним ссылкам, структурированные данные соответствуют видимому тексту, данные в Merchant Center и профиле компании актуальны. Ограничить показ своих материалов в поиске, в том числе в ИИ-функциях, можно стандартными средствами: nosnippet, data-nosnippet, max-snippet или noindex. Для ограничения обучения и использования контента в других системах Google предусмотрен отдельный токен Google-Extended.
Как Яндекс собирает нейроответ
Справка Яндекса описывает механику так. Алгоритмы подбирают подходящие материалы, затем нейросеть семейства YandexGPT 3 в реальном времени анализирует материалы из поисковой выдачи, после чего информация собирается в один ответ со ссылками на источники. Ссылки показываются во всех ответах Нейро, кроме режима решения математических задач. В официальном описании нет требований к особым файлам, тегам или отдельной разметке для попадания в источники. Из механики следует практический вывод: кандидаты берутся из обычной выдачи, поэтому путь в нейроответ лежит через обычное ранжирование. Точный порог позиций Яндекс официально не называет, а цифры о топ-30 или топ-10, которые встречаются в отраслевых публикациях, — оценки практиков.
Файл llms.txt и приёмы GEO
Вокруг оптимизации под генеративные системы (GEO) появилось много советов: llms.txt, специальная разметка, особое «упаковывание» фактов. Для Google официальный ответ уже приведён: ни файлы, ни особая разметка не нужны. Сам Яндекс публикует файлы llms.txt для собственной документации, но в справке Вебмастера и описании Нейро такой файл не упоминается как условие отбора источников на сторонних сайтах.
Академические работы рисуют неоднородную картину. В лабораторном бенчмарке GEO добавление цитат, ссылок на источники и статистики повышало видимость источника в сгенерированном ответе на 30–40% по одной из метрик, а на реальной системе Perplexity — до 37%. Авторы этой работы сами отмечают, что не измеряли влияние приёмов на позиции в поиске. Другое исследование, C-SEO Bench, проверило методы «разговорной» оптимизации и пришло к выводу, что большинство из них неэффективны, а нередко снижают позицию документа. Статистически значимый выигрыш дали только улучшение содержания и подсказки от LLM, а традиционные SEO-методы, улучшающие позицию в поиске, сильнее влияли на цитирование. Ещё одна работа обращает внимание на случайность: при повторных запусках одного запроса набор источников заметно меняется, поэтому оптимизация под позицию в генеративном ответе может быть ненадёжной.
Как ИИ-ответы в поиске меняют трафик сайтов
Продвижение сайтов с помощью ИИ теперь приходится вести в поиске, который сам отвечает на часть вопросов. Цифры о влиянии этого на трафик сильно расходятся, и почти всегда причина в выборке, периоде и способе подсчёта.
Google и клиенты одного агентства
Агентство Brainlabs проанализировало данные Google Analytics 54 своих клиентов: 24 из США, 24 из Великобритании и 6 из других рынков, 19 отраслей, среди них 16 ритейлеров. Период — с января 2025 по апрель 2026 года. Точкой перелома агентство считает сентябрь 2025 года, когда AI Overviews стали появляться как минимум на 30% страниц выдачи Google в США. После этого органический трафик снизился у 46 клиентов из 54, а в целом по выборке органические сессии сократились на 10,5%. Переходы из ChatGPT, Gemini и других ИИ-систем выросли на 163%. Целевые действия посетителей («ключевые события», куда входят покупка, подписка или даже прокрутка до конца страницы) из переходов ChatGPT, Copilot, Gemini и Perplexity происходили в 1,5 раза чаще, чем из обычного органического поиска.
Сильнее всего просели фитнес, финтех, страхование и товары повседневного спроса, меньше всего — ритейл, красота и развлечения. Это наблюдение по клиентам одного агентства, а не эксперимент: на трафик за тот же период влияли сезонность, обновления алгоритмов и разная доля ИИ-блоков в нишах. Часть переходов из ИИ-систем записывается как прямой трафик, если пользователь открывает сайт в новом окне. Более высокая доля целевых действий, вероятно, объясняется тем, что из ИИ-ответов приходят люди, которые уже продвинулись в выборе, но это интерпретация, а не измеренная причина.
Масштаб ИИ-переходов пока невелик: в одном из отраслевых сравнений они составили 2,85% от SEO-трафика в США и 2,44% во Франции, то есть примерно один визит из 200. Причинную оценку дал браузерный эксперимент, в котором участникам в течение 10 дней включали или отключали AI Overviews и AI Mode в Google. При доступе к ИИ-функциям переходы на сайты издателей заметно снижались, а доверие пользователей и их оценка поиска не улучшались.
Рунет и Поиск с Нейро
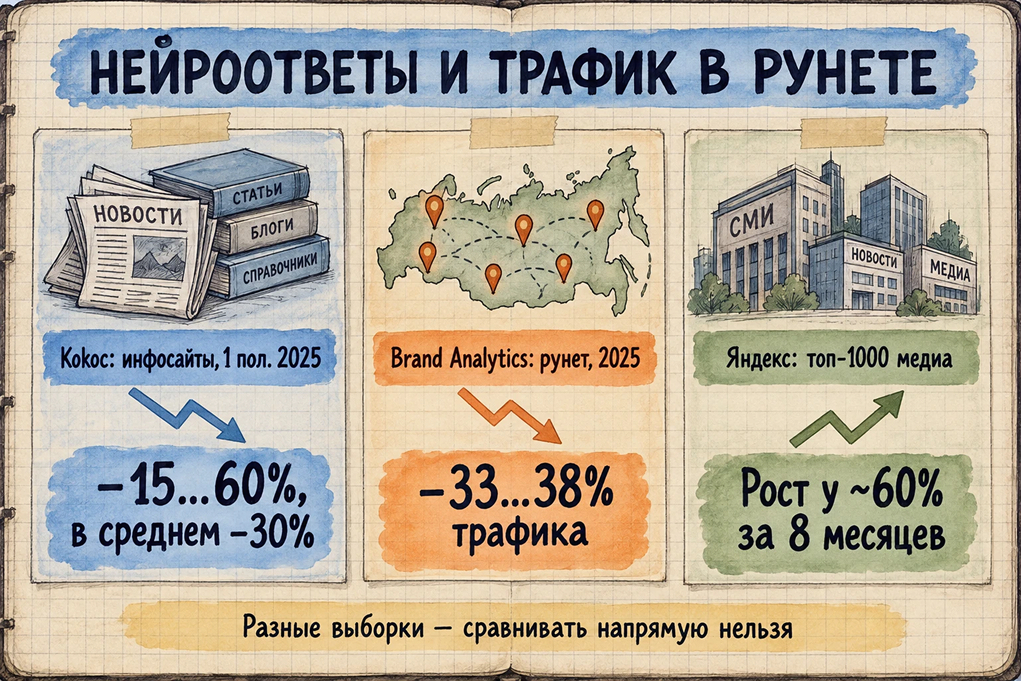
Для российского рынка чаще всего называют три цифры, и сравнивать их напрямую нельзя.
- Около 30% в среднем. Kokoc Performance изучило посещаемость информационных сайтов (СМИ, образовательные, юридические ресурсы) из поиска в первом полугодии 2025 года. После внедрения нейроответов в Яндексе и Google органический трафик снизился на 15–60% в зависимости от ниши, в среднем на 30%, а кликабельность в отдельных категориях упала более чем вдвое. Подробная методика и состав сайтов публично не раскрыты. По счётчику LiveInternet категория «Новости и СМИ» с января по июль 2025 года потеряла около 12% просмотров и 13% посетителей из Яндекса и около 14% и 15% соответственно из Google.
- 33–38% за 2025 год. Оценка Brand Analytics, опубликованная весной 2026 года, касается российских интернет-ресурсов и объединяет влияние нейроответов Яндекса и Google. В той же оценке говорится, что в 60% случаев пользователь получал ответ, не переходя на сайт-источник.
- Рост у 60% крупнейших медиа. Пресс-служба Поиска Яндекса в 2025 году сообщила, что примерно у 60% из топ-1000 медиасайтов трафик из Яндекса за восемь месяцев вырос.
Эти цифры не противоречат друг другу так сильно, как кажется: они описывают разные когорты. Крупнейшие медиа чаще оказываются в верхней части выдачи, из которой формируется нейроответ, и могут получать переходы по ссылкам на источники. Средние и небольшие информационные сайты, отвечающие на простые фактические вопросы, теряют больше. Падение неравномерно: трафик перераспределяется, а не исчезает у всех одновременно.
Отдельно стоит предупредить о популярной цифре «кликабельность первой позиции падает почти на 60% при появлении нейроответа». В русскоязычных публикациях её приписывают Яндексу, но исходное измерение относится к Google AI Overviews. Похожая цифра −56% CTR взята из случая британского издания MailOnline, тоже в Google. Для Яндекса такая оценка с открытой методикой не опубликована.
Что из этого следует для контента
Уязвимее всего контент, который можно целиком пересказать в нескольких строках: определения, короткие справки, ответы «что такое». Устойчивее страницы, которые нельзя заменить выжимкой: подробные таблицы соответствий и расчёты, сравнение с нюансами, собственные данные, коммерческие страницы с ценами и условиями. Отсюда и логика оценки эффективности: сравнивать каналы стоит по заявкам и продажам, а не по визитам, и учитывать все касания на пути к покупке, а не только последний клик. Человек может прочитать нейроответ, а через две недели набрать название бренда, и в отчёте это будет брендовый запрос, а не статья.
Что показывают исследования ИИ-контента
Большинство громких цифр про «ИИ против человека» относятся к сырому сгенерированному тексту. Они не проверяют, улучшает ли результат продвижение сайтов с помощью ИИ, в котором модель помогает специалисту. Это две разные задачи, и их стоит разделять.
Срез выдачи Semrush
В ноябре 2025 года Semrush собрала 20 000 запросов, взяла по ним топ-10 Google (200 000 адресов) и оставила только страницы блогов, адреса которых содержат /blog/. Получилось 42 000 страниц. Тексты прогнали через детектор GPTZero, который разделил их на написанные человеком, сгенерированные ИИ и смешанные. На первой позиции вероятность встретить «человеческий» текст составила 80,5%, а «ИИ-текст» — 10% (в кратком изложении результатов — 9%), остальное пришлось на смешанные. Между первой и четвёртой позицией доля ИИ-текста почти удваивается, а начиная с пятой позиции разрыв невелик.
Ограничения существенные. Это снимок выдачи, а не эксперимент: исследование показывает связь между меткой детектора и позицией, но не доказывает, что ИИ-текст стоит ниже из-за происхождения. Детектор выдаёт вероятность, а не точный ответ. Выборка включает только англоязычные страницы блогов в Google. Возможное объяснение — в топе много давно опубликованных страниц с накопленным авторитетом, написанных до массового распространения генеративных моделей, — остаётся гипотезой. Исследование проведено компанией, которая сама продаёт инструменты для создания контента с ИИ.
Контролируемый эксперимент Reboot Online
Британское агентство Reboot Online в 2023 году зарегистрировало 10 новых доменов без истории и ссылок: на пяти разместило текст GPT-4, на пяти — текст копирайтеров агентства, написанный по тому же брифу, но без доступа к машинному варианту. Количество и расположение ключевого слова, объём и смысл текстов уравняли. Сайты запустили в один час на одинаковом хостинге. Продвигали их по выдуманному слову «flemparooni», которого до эксперимента не было в индексе Google. Позиции снимали ежедневно в течение трёх месяцев, а само слово никто не искал.
Средняя позиция «человеческих» сайтов составила 4,4, «машинных» — 6,6. Часто встречающаяся формулировка о «25 парах доменов» ошибочна: 25 — это число попарных статистических сравнений (пять сайтов на пять). В 23 из 25 сравнений различие было статистически значимым. В 21 случае лучше оказался «человеческий» сайт, в двух один и тот же «машинный» сайт обошёл двух «человеческих», ещё в двух значимой разницы не нашли. Выборка мала, ключевое слово искусственное, без реального спроса и конкуренции, а редактура ИИ-текста не проверялась. Сами авторы предполагают, что отредактированный и доработанный ИИ-текст может давать лучший результат.
Две тысячи статей без редактуры
Самый масштабный публичный опыт поставила SEO-платформа SE Ranking. В ноябре 2024 года она купила 20 новых доменов в разных нишах и опубликовала на каждом по 100 статей формата «как сделать» под низкоконкурентные запросы. Тексты создавались в один клик во встроенном генераторе, без дополнительных промптов, правки, ссылок и перелинковки. Сайты добавили в Search Console и больше не трогали.
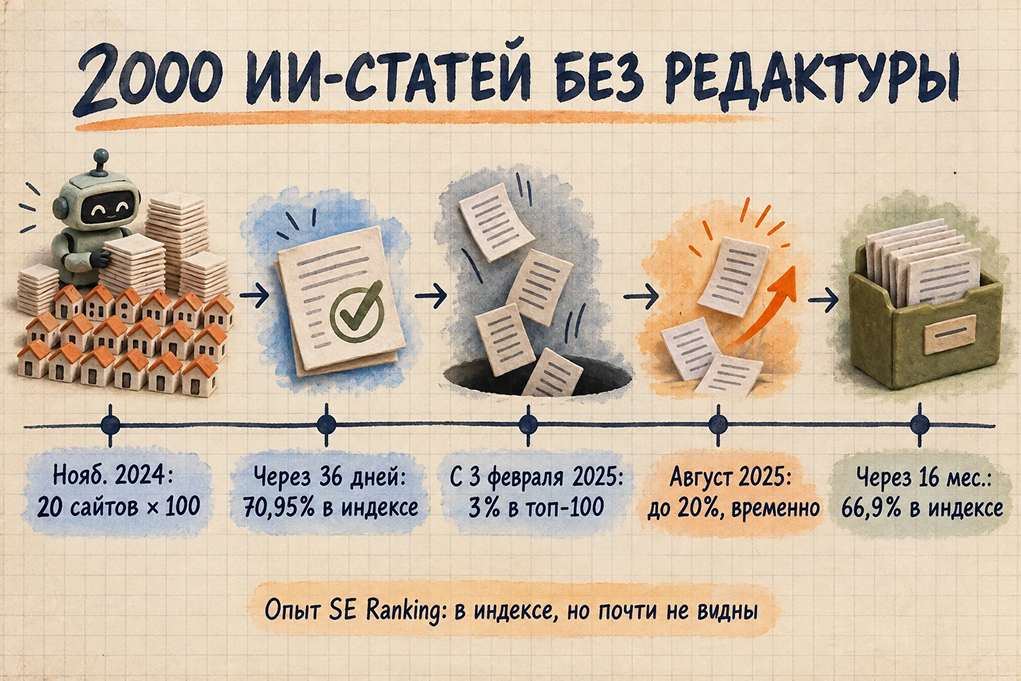
- Через 36 дней в индексе были 70,95% статей (1419 из 2000), они получили 122 102 показа и 244 клика, 28% адресов были в топ-100, а 80% сайтов ранжировались хотя бы по 100 запросам.
- На втором-третьем месяце накопленные показы превысили 526 000, клики достигли 782.
- Около трёх месяцев после запуска, с 3 февраля 2025 года, в топ-100 оставались лишь 3% страниц. Страницы оставались в индексе, но пользователи их почти не видели.
- После спам-обновления Google в августе 2025 года доля страниц в топ-100 временно поднялась до 20%.
- Через 16 месяцев в индексе оставались 66,9% страниц, накопленный итог составил 1 092 079 показов и 1381 клик. Значимого восстановления не было ни у одного сайта, сильнее других пострадали ниши, связанные с финансами и здоровьем.
Распространённая версия о «71% в индексе за 30 дней» неточна: это 36 дней. Отдельно та же компания опубликовала шесть статей, подготовленных с ИИ, но отредактированных, проверенных на факты и снабжённых пояснением об использовании ИИ, в собственном давно работающем блоге. Они собрали около 555 000 показов и более 2300 кликов, несколько попали в топ-10 и в цитаты AI Overviews. Различались и редактура, и авторитет домена, поэтому разделить вклад этих факторов невозможно. Это опыт производителя SEO-софта, а не независимое исследование. В продолжении опыта в марте 2026 года добавление новых ИИ-статей на восемь сайтов увеличило показы старых страниц, но это ранний результат без гарантии устойчивости.
Парное сравнение на действующих сайтах
Консалтинговая компания Digital Applied сравнила 200 статей (100 сгенерированных и 100 написанных людьми) на 14 действующих сайтах: пять блогов B2B SaaS, три блога агентств, три новостных сайта и три блога интернет-магазинов. Каждой ИИ-статье подобрали пару на том же домене, опубликованную в пределах недели, с похожим объёмом (1800–3500 слов), сопоставимой темой и одинаковой схемой внутренних ссылок. Статьи вышли с 1 октября по 15 декабря 2025 года и отслеживались до 15 апреля 2026 года.
ИИ-статьи индексировались быстрее (медиана 14 часов против 26) и на первой неделе стояли в среднем на 4 позиции выше. К третьему месяцу траектории поменялись местами, а к шестому медианное преимущество «человеческих» статей составило 5 позиций. Расширенные сниппеты достались им в 19% случаев против 12%, цитаты в AI Overviews — в 11% против 4%. Сравнивались сырые ИИ-черновики с полностью человеческими текстами, процесс с редактурой ИИ-черновика здесь тоже не проверялся.
Общий вывод из экспериментов
Все четыре работы проверяют один сценарий: текст из модели публикуется без участия редактора. Его результат устойчив: быстрая индексация и ранний всплеск, затем отставание. Причину авторы экспериментов видят в том, что такой текст не даёт ничего нового по сравнению с уже опубликованным и не подкреплён авторитетом, но это их интерпретация. Независимого надёжного эксперимента, в котором полноценный SEO-процесс с ИИ сравнивался бы с таким же тщательным процессом без ИИ, пока нет. Утверждать, что ИИ сам по себе поднимает сайт в поиске, нельзя. Как и утверждать, что он сам по себе его топит.
Где ИИ дает измеримую выгоду
Доказанное преимущество ИИ в SEO лежит в области производительности, а не позиций. В академическом исследовании, опубликованном в материалах CEUR Workshop Proceedings, сравнивались процессы веб-администрирования на сайтах академического, юридического, государственного и коммерческого секторов. Внедрение генеративного ИИ (Gemini Pro) при обязательном экспертном контроле сократило полный цикл подготовки и публикации материала со 120–180 минут до 12 минут и повысило производительность администратора в 4–5 раз. По данным Google Analytics 4 и Search Console авторы не обнаружили санкций или фильтров в случае, когда ИИ-контент проходил финальную проверку и редактуру человеком. Выборка организаций небольшая, поэтому это скорее подтверждение принципа, чем универсальная норма.
Отсюда разумная экономическая модель: время, сэкономленное на черновиках, сборе данных и рутинных проверках, тратится на то, что модель сделать не может, — экспертное мнение, собственные данные и проверку фактов. Если сэкономленное время уходит на увеличение числа однотипных страниц, процесс приближается к тому, что Google называет злоупотреблением масштабированием, а Яндекс — малополезным контентом.
Чтобы понять, работает ли ИИ на конкретном сайте, нужен свой маленький эксперимент:
- выбрать одну метрику (клики из поиска, заявки, кликабельность сниппета) и зафиксировать исходное значение;
- разделить похожие страницы на тестовую и контрольную группы и менять только тестовую;
- не вносить параллельно других изменений и ждать достаточно долго, обычно от нескольких недель до трёх месяцев, потому что краткосрочные колебания позиций часто оказываются шумом;
- оценивать результат по трафику и заявкам, а не только по позициям.
Инструменты для продвижения сайтов с помощью ИИ
Ниже перечислены инструменты с подтверждёнными функциями. Цены меняются, поэтому перед покупкой их стоит проверить на сайте производителя. Наличие функции не означает, что она улучшит позиции.
- Screaming Frog SEO Spider — десктопный краулер, который проверяет сайт более чем на 300 SEO-проблем. Бесплатная версия ограничена 500 адресами за обход и не даёт доступа к API-интеграциям, рендерингу JavaScript и расширенным настройкам. Годовая лицензия на одного пользователя стоит 199 фунтов, 279 долларов или 245 евро, при покупке от пяти лицензий есть скидки. Токены OpenAI, Gemini или Anthropic оплачиваются отдельно у провайдера. Локальные модели через Ollama не требуют платы за API, но нуждаются в собственных вычислительных ресурсах.
- «Пиксель Тулс» — российская платформа, которая работает с 2016 года и объединяет съём позиций, сбор семантики, техаудит, генерацию контента и аналитику упоминаний бренда в ответах нейросетей. Сервис сбора семантики работает в шесть шагов на основе анализа конкурентов: подбор конкурентов, выбор самых близких по пересечению запросов, отбор самых трафиковых адресов, парсинг их запросов, очистка от мусора и неявных дублей, снятие метрик. Оплата идёт в лимитах: тариф «Гуру» — 3790 ₽ за 30 дней и 70 000 лимитов (пробный период за 99 ₽), «Бизнес» — 24 990 ₽ и 500 000 лимитов, «Энтерпрайз» — от 35 000 ₽ и от 1 000 000 лимитов. При оплате на 90 дней скидка 10%, на 365 дней — 30%.
- Just-Magic — сервис кластеризации по выдаче Яндекса, расширения семантики и текстового анализа. Инструмент «Акварель» пословно проверяет тематичность текста запросу, а «Акварель-генератор» составляет список релевантных слов для нового текста. Это алгоритмическая обработка данных выдачи, а не генерация.
- Плагины для CMS. Для WordPress существуют модули перелинковки, которые строят смысловой индекс сайта на эмбеддингах и предлагают контекстные ссылки пакетами с возможностью просмотра.
- Универсальные языковые модели (ChatGPT, Claude, Gemini, YandexGPT, GigaChat, DeepSeek) — для работы с выгрузками, черновиков, структуры, разметки и кода. Их полезность прямо зависит от того, какие данные им переданы.
Нейро-продвижение под ключ на примере neirosite.com
Помимо инструментов, на рынке есть агентства, которые продают продвижение сайтов с помощью ИИ как готовую услугу. Хороший пример для разбора — neirosite.com: компания подробно описывает процесс и публикует тарифы, поэтому её предложение можно сопоставить с правилами поисковых систем и данными исследований. Всё, что сказано ниже о компании, — её собственные заявления на сайте. Независимых подтверждений результатов среди открытых данных нет.
Что заявляет компания
- Кто это. В подвале сайта указано ООО «Софтинвест», бренд — Spellchat Business. Компания пишет, что работает в IT с 2018 года.
- Услуги. SEO-продвижение с помощью собственной нейросети «Спелчат Бизнес», разработка «нейро-сайтов» со встроенным ИИ-консультантом, ведение Яндекс Директа через API с алгоритмом «СпеллСтат», ИИ-менеджер и голосовой ИИ SpellManager, видеосвязь, нейроаватары, репутационный менеджмент.
- Процесс SEO описан в девять этапов: аудит сайта (технические ошибки, контент, конкуренты), сбор семантики через Вордстат и Key Collector, поиск в Буквариксе и анализ ссылочной массы конкурентов, «обучение нейросети» на собранных данных, занесение запросов в сервис мониторинга позиций, согласование стратегии с клиентом, запуск нейросети, ежедневное наблюдение за позициями и итоговый отчёт. Для старта аналитики компания запрашивает доступ к статистике Яндекс Метрики и аккаунта Директа.
- Содержание работ в описании компании: сбор и кластеризация семантики, генерация текстов, FAQ, описаний услуг и коммерческих блоков, исправление технических ошибок, улучшение перелинковки, оптимизация метатегов и заголовков, работа с поведенческими факторами, A/B-подход к страницам, которые дают заявки.
- Тарифы SEO-продвижения, ежемесячно и без НДС: «Старт» — 72 000 ₽ (для сайта, у которого уже есть запросы в топ-40, доступы к сайту не нужны, внутренняя оптимизация не входит, 100 приоритетных запросов); «Стандарт» — 96 000 ₽ (200 запросов); «Продвинутый» — 120 000 ₽ (300 запросов); «Эксперт» — 150 000 ₽ (500 запросов). Для трёх старших тарифов доступ к сайту требуется, внутренняя оптимизация входит.
- Условия оплаты — «сначала результат, потом оплата», по договору. Для контроля позиций компания советует сервис Яндекс-Топ.РФ и показывает результаты в TopVisor.
Заявления, которые стоит проверять
Часть формулировок на сайте сформулирована как обещания скорости и гарантий. Их полезно разобрать, прежде чем подписывать договор с любым подобным подрядчиком.
- Сроки. На странице SEO указаны «3–5 дней — средний срок продвижения в ТОП», ниже — «первые результаты выхода запросов в ТОП буквально за 5–7 дней», а в сравнении с классическим SEO — «от 2 до 5 дней» против «от 6 месяцев». Неизвестно, к каким запросам, нишам и уровню конкуренции относятся эти сроки. Пример динамики на сайте (рост с 65 до 211 запросов в топ-100 между 22 и 25 апреля, из них с 33 до 98 в топ-10) приведён без названия сайта, года, частотности запросов и данных о трафике и заявках. Рост числа позиций по малочастотным запросам и рост посещаемости — разные вещи.
- Гарантия от фильтров. Компания пишет, что соответствует ранжирующим факторам Яндекса, «что исключает возможность попасть под фильтр». Ни одна сторонняя организация не управляет алгоритмами поисковой системы. Google прямо указывает, что даже соответствие всем требованиям не гарантирует индексацию и показ, а Яндекс регулярно обновляет алгоритмы. Такое заявление стоит воспринимать как убеждённость исполнителя, а не как гарантию.
- Продвижение без доступа к сайту. На тарифе «Старт» компания обещает рост за счёт внешней оптимизации без доступа к сайту и без внутренних работ. Какие именно внешние методы используются, на сайте не раскрыто. Заказчику разумно получить письменное описание этих методов и сверить их с правилами Яндекса о ссылках и о качестве сайта.
- Цифры масштаба. На разных страницах приводятся «700+ продвинутых сайтов», «500+ завершённых проектов», «2000+ кейсов», «более 1500 успешных запусков», «120+ сотрудников». Поименного списка клиентов и разборов кейсов с метриками в открытом доступе нет. Количество учитываемых факторов ранжирования названо по-разному: «1000» на главной и «100 000» на странице SEO.
- Конверсия и рост. «Заявки с 98% трафика», «рост продаж до 50%», «увеличиваем поток клиентов и прибыль в 10 раз» — без определения метрики, базы для сравнения и периода. Измерить такие показатели может только сам заказчик в своей Метрике и CRM.
Модель «оплата за результат» действительно снижает финансовый риск заказчика, но только если результат определён в договоре точно. Удобнее всего — через трафик и заявки из поиска, измеренные в собственной аналитике, а не только через число запросов в топе.
Вопросы к любому подрядчику по нейро-продвижению
- Какие именно работы выполняет ИИ, а какие — специалист, и кто проверяет тексты перед публикацией?
- Какие внешние методы используются, если доступ к сайту не нужен, и соответствуют ли они правилам Яндекса и Google о ссылках и пользовательских сигналах?
- По каким запросам фиксируется результат, какова их частотность по Вордстату и в каком регионе снимаются позиции?
- Как результат связан с трафиком и заявками, а не только с позициями?
- Что происходит с достигнутыми позициями после прекращения работ?
- Какие данные компании и клиентов передаются в модели и на каких серверах они обрабатываются?
Эти вопросы применимы к neirosite.com так же, как к любому другому агентству или фрилансеру, который продвигает сайты с помощью нейросетей.
Риски SEO-продвижения с нейросетями и меры защиты
Ошибки в фактах
Модель уверенно придумывает цены, нормы, характеристики, ссылки на несуществующие исследования. В темах, где ошибка влияет на здоровье, деньги или права человека, это особенно опасно: Google прямо пишет, что в медицинских, финансовых и гражданских темах его системы ещё больше опираются на сигналы надёжности. Защита — правило «ни одна цифра без первоисточника» и проверка экспертом профильных материалов до публикации.
Тонкие и дублирующиеся страницы
Лёгкость генерации подталкивает создавать отдельную страницу под каждую вариацию запроса: «услуга + город», десятки почти одинаковых статей. Это прямой путь к каннибализации, лишней нагрузке на краулинговый бюджет и признакам малополезности. Перед созданием новой страницы стоит проверить, нет ли на сайте близкой по смыслу. С этим помогают эмбеддинги: узкие темы лучше объединять в один полный материал. Яндекс отдельно упоминает, что многочисленные страницы с результатами фильтрации, не несущие пользы, увеличивают нагрузку на сайт и снижают эффективность обхода ценных страниц.
Конфиденциальность данных
Выгрузки из CRM, клиентские базы, номера телефонов и коммерческая тайна не должны попадать в публичные облачные модели без оценки рисков. Требования зависят от страны. В России обработку персональных данных регулирует Федеральный закон № 152-ФЗ, в ЕС — GDPR. Базовые меры: обезличивать данные перед отправкой, использовать корпоративные тарифы провайдеров с договором об обработке данных или локальные модели на собственном сервере. Тот же Screaming Frog позволяет работать с локальными моделями через Ollama и подключать частные API по совместимому интерфейсу.
Права на сгенерированный текст
Правовой статус результатов генерации в разных странах определяется по-разному, и практика ещё складывается. В России статья 1228 Гражданского кодекса признаёт автором гражданина, творческим трудом которого создан результат, а нейросеть субъектом права не является. Специального режима для результатов генерации закон пока не установил. Текст или изображение, полученные по короткому запросу без переработки, могут не получить охраны, и защитить их от копирования конкурентами будет трудно. Шансы на охрану растут при существенной творческой переработке человеком. Для международных проектов этот вопрос нужно решать по праву конкретной страны.
Колебания позиций и изменения выдачи
Ранний рост ИИ-страниц бывает обманчивым: в экспериментах страницы быстро индексировались и получали показы, а через два-три месяца теряли видимость. Ещё один фактор — ИИ-блоки в выдаче, которые могут снижать переходы при неизменных позициях. Поэтому позиции стоит отслеживать вместе с кликами и заявками. Оценку любого изменения лучше откладывать хотя бы на квартал, а резкие провалы диагностировать в Search Console и Яндекс Вебмастере, где отображаются ручные меры и нарушения.
Рабочая схема продвижения сайта с помощью ИИ
Собранные вместе правила поисковых систем и результаты экспериментов складываются в понятную последовательность. Она подходит и для владельца небольшого сайта, и для команды, которая выбирает между собственными силами и подрядчиком.
- Данные из первоисточников. Запросы и частотность — из Вордстата или Keyword Planner с указанием региона и даты; позиции, клики и показы — из Search Console и Яндекс Вебмастера; поведение и заявки — из Метрики, Google Analytics и CRM; структура сайта — из краулера.
- Модель обрабатывает, а не придумывает. Разметка интента, черновая группировка, поиск каннибализации, приоритизация задач. Группы сверяются с выдачей, частотность от модели не принимается.
- Одна тема — одна сильная страница. Перед созданием новой страницы проверяется, нет ли близкой. Объём сайта растёт за счёт закрытых вопросов пользователей, а не количества вариаций.
- Черновик от модели, смысл от человека. В текст добавляются собственный опыт, цены, условия, расчёты, фотографии и примеры. Каждый факт сверяется с первоисточником, редактор убирает повторы и пустые абзацы.
- Метаданные и разметка проверяются так же строго, как текст. Title и Description соответствуют содержанию, структурированные данные — видимому тексту, разметка проходит валидатор.
- Техническая гигиена с помощью краулера. Смысловые дубли, страницы не по теме, сироты без входящих ссылок, корректные редиректы. Изменения на сайте утверждает человек.
- Ссылки — только те, что полезны читателю. Коммерческие размещения помечаются rel="sponsored", массовая закупка через биржи не используется.
- Готовность к ИИ-выдаче через обычное SEO. Сканирование разрешено, важный контент доступен в тексте, страница в индексе и ранжируется. Специальные файлы и особая разметка для этого не требуются.
- Оценка по деньгам. Для каждого канала считаются заявки, их стоимость и вклад в сделки, с учётом всех касаний, а не только последнего клика. Изменения проверяются на контрольной группе страниц.
При такой схеме нейросети для продвижения сайтов перестают быть способом быстро наполнить сайт текстом и становятся тем, чем их подтверждённо можно считать: инструментом, который в разы ускоряет рутину и освобождает время специалиста для работы, от которой на самом деле зависят позиции, — пользы, точности и доверия.