Нейросеть, чтобы заменить лицо на видео: как работает замена персонажа по фото
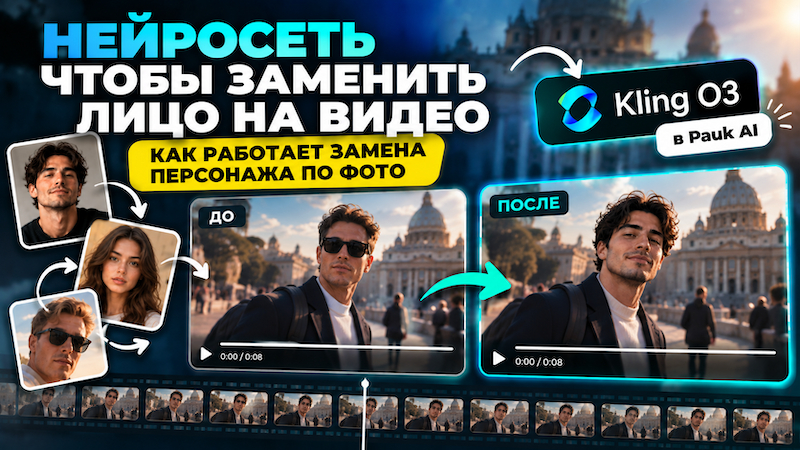
Когда мы видим удачный face swap, результат кажется почти магией: был один человек — загрузили фотографию — появился другой. Но нейросеть, чтобы заменить лицо на видео, не просто берёт лицо с фото и приклеивает его поверх каждого кадра. Ей приходится одновременно работать с внешностью, движением, ракурсами, светом и десятками промежуточных состояний лица.
Понять принцип полезно даже тому, кто вообще не интересуется технической стороной ИИ. Когда знаешь, какую информацию модель получает из видео, а какую — из фотографии, становится намного понятнее, почему один референс работает отлично, а другой даёт странный результат. Разберём это на простой связке: готовое видео + фото человека + Kling O3 в Pauk AI.
Как нейросеть заменяет лицо человека на видео по фотографии
Что получает нейросеть на входе
В нашем сценарии есть три основных компонента.
Первый — исходное видео. Это не просто набор красивых кадров. В ролике уже содержится огромное количество информации: где находится персонаж, как он двигается, куда смотрит, как поворачивает голову и что происходит вокруг.
Второй — фотография. Она отвечает на другой вопрос: кто должен оказаться в сцене?
Третий компонент — промпт. Он связывает первые два и объясняет, чего мы хотим: например, заменить главного героя человеком с фотографии, но сохранить исходные движения и фон.
Упрощённо вся задача выглядит так:
Видео = что происходит.Фото = кто участвует.Промпт = что изменить и что сохранить.
Это полезная модель для понимания любой замены человека на видео нейросетью.
Что она берёт из исходного видео
Представим простой ролик. Мужчина идёт по улице, останавливается, смотрит в камеру, улыбается и надевает очки.
Когда мы хотим вставить человека в видео, нам не требуется заново описывать каждое из этих действий. Они уже существуют в исходнике.
Из видео модель получает визуальную основу сцены: положение персонажа в кадре, позы, жесты, движение, изменение ракурсов и окружение. Там же содержится информация о работе камеры, освещении и взаимодействии героя с предметами.
Поэтому исходный ролик можно представить как готовую «хореографию».
Если герой поворачивает голову вправо, новый персонаж тоже должен выполнить этот поворот. Если камера приближается, новое лицо должно корректно выглядеть уже крупным планом. Если человек попадает в тень, освещение нового героя тоже должно измениться.
Именно поэтому заменить лицо на видео ИИ сложнее, чем изменить человека на одной фотографии: нейросети приходится сохранять согласованность во времени.
Что переносит с фотографии
Фотография решает противоположную задачу. Она сообщает модели, как выглядит новый человек.
Самая очевидная информация — черты лица: форма глаз, носа, губ, подбородка, общие пропорции. Также модель видит волосы, примерный возраст и другие визуальные особенности, которые присутствуют на снимке.
Но здесь появляется важное ограничение.
Фотография показывает человека только в том виде, в котором он снят.
Если у нас есть один портрет анфас, на нём нет точной информации о том, как нос выглядит в профиль или как меняется лицо при широкой улыбке. Когда такие состояния появляются в ролике, недостающие детали приходится генерировать.
Поэтому запрос «нейросеть чтобы заменить лицо на видео» немного обманчив своей простотой. Мы даём модели одно изображение, а просим создать десятки или сотни согласованных изображений этого человека в новых состояниях.
Чем информативнее фото, тем меньше приходится додумывать.
Видео задаёт движение, а фото — внешность нового персонажа
Что происходит с мимикой, движениями и одеждой
Здесь особенно хорошо видна разница между заменой лица и заменой всего персонажа.
Мимика
Допустим, на фотографии девушка смотрит в камеру с нейтральным выражением, а исходный герой смеётся.
Если задача выполнена правильно, новый персонаж не должен всё видео сохранять выражение лица с фотографии. Нейросети необходимо перенести идентичность девушки, но мимику взять из происходящего в ролике.
То есть меняется человек, а действие сохраняется.
Движения
Похожая логика работает с телом.
Новый герой должен повторять движение исходного персонажа: идти, поворачиваться, танцевать или взаимодействовать с объектами.
Фотография не содержит эту хореографию — её даёт видео.
Одежда
А вот здесь результат уже зависит от задачи.
Если нужно только заменить лицо на видео онлайн, логично сохранить одежду исходного героя.
Если хочется полноценнее вставить человека в видео, можно попросить перенести часть внешнего образа с референса или адаптировать одежду под нового персонажа.
Поэтому до генерации полезно решить: я меняю лицо или человека?
Это звучит как мелочь, но для промпта разница существенная.
Эксперимент: одно видео + три разных фотографии
Чтобы понять механику на практике, я бы провёл простой эксперимент.
Берём одно видео: например, человек идёт по набережной, затем останавливается и поворачивается к камере.
Сам ролик вообще не меняем.
Теперь делаем три генерации.
В первой используем фотографию молодого мужчины. Во второй — фотографию девушки. В третьей — другого человека с заметно отличающейся внешностью и причёской.
Если всё сделано правильно, во всех трёх версиях должны сохраниться узнаваемые элементы оригинала: траектория движения, поворот головы, положение камеры, набережная и общий тайминг.
Меняться будет персонаж.
Так особенно хорошо видно, что замена человека на видео нейросетью — это не создание трёх совершенно новых роликов. Один исходник выступает каркасом, а разные фото задают новую идентичность героя.
Есть и второй интересный эксперимент: оставить одну фотографию, но изменить промпты.
В одном попросить заменить только лицо, в другом — перенести нового персонажа шире. Результаты покажут, насколько сильно формулировка задачи влияет на границы изменений.
Как повторить эксперимент в Pauk AI
Практическая часть здесь короткая.
Шаг 1. Открываем Pauk AI
Переходим в Pauk AI и открываем раздел создания видео.
Шаг 2. Выбираем Kling O3
Для эксперимента используем Kling O3.
Шаг 3. Загружаем одно видео
Выбираем ролик с хорошо видимым главным героем. Для чистоты эксперимента во всех генерациях используем один и тот же исходник.
Шаг 4. Добавляем первую фотографию
Загружаем фото человека, которого хотим увидеть вместо героя.
Шаг 5. Добавляем промпт
Например:
Замени главного персонажа исходного видео человеком с загруженной фотографии. Максимально сохрани узнаваемые черты лица, возраст и причёску нового героя. Сохрани оригинальные движения, позы, жесты, мимику, фон, освещение, композицию и движение камеры. Новый персонаж должен естественно выполнять все действия исходного героя.
Запускаем генерацию.
После этого повторяем тот же процесс со второй и третьей фотографией, не меняя исходное видео и базовую формулировку.
Так проще сравнить результаты: изменяется только один элемент — фото персонажа.
Что прописывать в промпте, а что модель и так видит
Я бы не пытался словами пересказывать всё видео.
Если человек идёт по вечерней улице, не обязательно писать огромный абзац: «мужчина делает три шага, затем поворачивает голову на 30 градусов…». Модель уже получает ролик и видит происходящее.
Промпт полезнее использовать для управления изменениями.
Например:
Замени только лицо.
Или:
Перенеси внешность человека с фотографии на главного героя.
И дальше:
Сохрани исходные движения, фон и камеру.
То же относится к фотографии. Не обязательно подробно писать «карие глаза, тёмные волосы, овальное лицо», если всё это хорошо видно на референсе.
Но если какая-то характеристика принципиальна и постоянно теряется, её можно подчеркнуть отдельно.
Поэтому хороший промпт для нейросети, чтобы заменить лицо на видео, я воспринимаю скорее как набор правил, чем как литературное описание картинки.
Модель видит исходники. Моя задача — объяснить, как именно ими воспользоваться.
Где нейросеть ошибается
Большинство ошибок становится понятнее, если вспомнить принцип «видео + фото».
Например, человек в ролике резко поворачивается в профиль, а на фотографии есть только анфас. Модель получает от видео нужный ракурс, но не получает от фото точную внешность в этом ракурсе. Возникает зона неопределённости.
То же происходит, когда лицо перекрывается рукой или предметом.
Сложными остаются и очень быстрые движения, сильное размытие, экстремальное освещение, маленькое лицо в кадре и сцены с несколькими людьми.
Иногда проблема противоположная: лицо получилось хорошо, но модель слишком сильно изменила героя целиком. Тогда в промпте стоит чётче ограничить задачу: если нужно только заменить лицо на видео ИИ, отдельно просим сохранить тело, одежду и причёску оригинального персонажа.
Если же новый герой выглядит как чужое лицо на чужом теле, можно перейти от face swap к более полной замене персонажа.
Ответы на технические вопросы
Нейросеть просто накладывает фотографию поверх видео?
Нет, такой способ плохо работал бы при изменении ракурса и мимики. В описанном сценарии фотография используется как референс внешности, которую нужно адаптировать к происходящему в ролике.
Почему лицо может быть разным в соседних кадрах?
Видео требует временной стабильности: персонаж должен оставаться узнаваемым при движении. Сложные ракурсы, перекрытия и недостаточно информативный референс могут ухудшать эту стабильность.
Можно ли заменить лицо на видео онлайн по одному фото?
Одного качественного референса может быть достаточно для базового эксперимента. Но чем сложнее ракурсы в ролике, тем больше информации модели приходится достраивать.
Что важнее — фотография или промпт?
Они решают разные задачи. Фото содержит информацию о внешности, а промпт задаёт правила преобразования. Очень длинное описание не способно полностью компенсировать плохой референс.
Можно ли вставить человека в видео, а не только заменить лицо?
Да. В таком случае задача формулируется шире: фотография используется как референс нового персонажа, а видео сохраняет действия и сцену.
Почему после замены меняется фон?
Модель может получить слишком много свободы при преобразовании. В промпте стоит явно указать, что фон, композиция, камера и окружающие объекты должны сохраниться.
Итог
Если убрать всю сложную терминологию, принцип довольно понятный. Нейросеть, чтобы заменить лицо на видео, получает готовую сцену, фотографию нового человека и инструкцию, связывающую эти материалы. Видео отвечает за движение и происходящее, фото — за идентичность, а промпт определяет границы изменений.
В Pauk AI этот эксперимент собирается по схеме Kling O3 → видео → фото персонажа → промпт → генерация. И понимание механики здесь действительно помогает: вместо попытки описать нейросети то, что она уже видит, лучше сосредоточиться на главном — кого необходимо заменить, насколько полно переносить внешность и какие части исходного ролика должны остаться без изменений.