Нейросети для решения задач по фото: ТОП-10 моделей, которые распознают условие и объясняют ответ
Нейросети для решения задач по фото: как сфотографировать условие и получить пошаговый разбор, какие модели лучше справляются с математикой, геометрией, графиками и рукописным текстом и как проверить ответ.
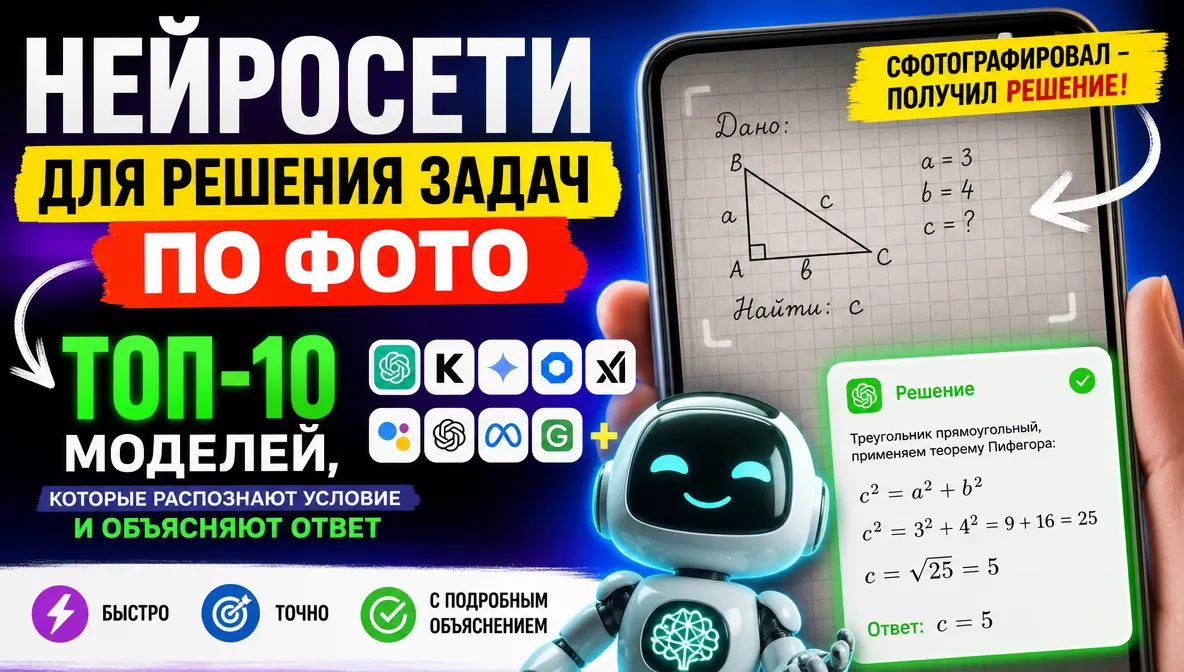
Сфотографировал задачу — получил не только ответ, но и ход решения. Ещё недавно для этого нужно было перепечатывать условие в поисковик или искать номер упражнения в ГДЗ. Сегодня нейросети для решения задач по фото сами распознают текст, формулы, чертежи и графики на снимке, а затем решают задание и объясняют каждый шаг.
 STIVA.ai — российский агрегатор нейросетей, где в одном чате собраны десятки моделей для текста, изображений, видео и аудио. Для решения задач по фото это удобно: одно и то же фото можно отправить разным моделям, сравнить решения и выбрать то объяснение, которое понятнее.
Как работают нейросети для решения задач по фото
Схема почти всегда одинаковая:
- Вы фотографируете или делаете скриншот задания — страницу учебника, условие с доски, лист контрольной, чертёж или график.
- Загружаете снимок в чат и пишете, что нужно: «Реши и объясни по шагам», «Проверь моё решение», «Объясни проще, как для 7 класса».
- Модель распознаёт условие — текст, формулы, обозначения на чертеже, данные таблицы.
- Нейросеть решает задачу и, если попросить, показывает формулы, промежуточные вычисления и проверку ответа.
- Вы задаёте уточняющие вопросы — например, просите объяснить непонятный шаг другим способом.
Ключевое отличие от обычного ГДЗ — интерактивность. Готовый решебник показывает один вариант решения. Нейросеть можно попросить разобрать условие, подсказать только первый шаг, найти ошибку в вашем решении или придумать похожую задачу для тренировки.
Какие задачи можно решать по фото
- Математика и алгебра — уравнения, неравенства, системы, текстовые задачи, дроби, проценты, функции.
- Геометрия — задачи по чертежу: углы, треугольники, окружности, площади и объёмы. Здесь особенно важно, чтобы модель не просто читала текст, а понимала рисунок.
- Физика — задачи с формулами, схемами цепей, графиками скорости и движения.
- Химия — уравнения реакций, цепочки превращений, задачи на растворы и количество вещества.
- Информатика — скриншоты кода, блок-схемы, задания на алгоритмы.
- Гуманитарные предметы — фото параграфа, документа или литературного отрывка: пересказать, выделить главное, составить план ответа.
- Иностранные языки — упражнение с картинки: перевести, вставить пропущенные формы, объяснить правило на примере с фото.
- Рукописные записи — конспект, решение на черновике, условие, написанное от руки. С рукописным текстом справляются не все модели одинаково хорошо, поэтому его лучше проверять особенно внимательно.
Ниже — подробнее о каждой модели: что она умеет делать с фотографией задания и в каких случаях её стоит выбрать.
1. ChatGPT 5.6 Sol — для самых сложных задач по фото
ChatGPT 5.6 Sol — флагманская модель серии ChatGPT 5.6 от OpenAI с контекстом 1 050 000 токенов и работой с изображениями, PDF, документами и таблицами.
Её стоит выбирать, когда на фото — сложная задача в несколько действий: стереометрия с чертежом, физика с графиком, цепочка по химии или задача, где условие частично в тексте, а частично на рисунке. Модель можно попросить сначала переписать распознанное условие — так вы сразу увидите, правильно ли она прочитала снимок, — а затем решать по шагам с самопроверкой результата.
В PRO-режиме Sol даёт максимальную глубину рассуждений. Для обычного упражнения по фото он избыточен, а вот для олимпиадной задачи, подготовки к экзамену или разбора «нерешаемой» задачи с учебника — это самый сильный вариант в подборке.
2. ChatGPT 5.5 — универсальный выбор на каждый день
ChatGPT 5.5 — флагман OpenAI, который работает с текстом, документами и изображениями на уровне распознавания и анализа.
Это удобный баланс глубины и универсальности: по одному фото модель решит задачу по математике или физике с формулами и промежуточными вычислениями, по скриншоту кода из учебника информатики объяснит алгоритм и найдёт ошибку, а по снимку параграфа поможет составить план сочинения или пересказ. Если непонятен один шаг, попросите объяснить его проще или показать решение другим способом — модель хорошо держит контекст диалога и не теряет условие.
3. Gemini 3.1 Pro Preview — сильный разбор фото, схем и рукописных пометок
Gemini 3.1 Pro Preview — мультимодальная модель Google с контекстом до 1 000 000 токенов. В карточке модели прямо указаны анализ изображений, схем, графиков и PDF, извлечение данных из таблиц и понимание рукописных пометок.
Для решения задач по фото это один из самых практичных вариантов. Не нужно перепечатывать длинное условие: загрузите фото страницы, и Gemini распознает задание, выделит данные, покажет формулы и последовательность вычислений. Модель также удобно использовать как репетитора: она объясняет темы по уровням — от школьного до продвинутого — и проверяет готовые решения с разбором ошибок.
Единственная оговорка — статус Preview: поведение и лимиты версии могут меняться, поэтому критичные ответы лучше перепроверять.
4. Gemini 3.8 Flash — быстро решить задачу по фото
Gemini 3.8 Flash — быстрая мультимодальная модель Google, которая принимает текст, изображения и видео и поддерживает контекст до 1 000 000 токенов.
Flash-версия подходит для повседневного сценария «сфотографировал — получил разбор через несколько секунд»: одно-два упражнения с учебника, проверка домашнего задания, объяснение правила по фото параграфа. Модель распознаёт визуальный контекст снимка и связывает его с вашим вопросом, поэтому можно отправить, например, фото графика функции и попросить описать его свойства.
Для очень сложной многошаговой задачи глубже разберётся Gemini 3.1 Pro Preview, а для скорости и потока однотипных заданий Flash удобнее.
5. ChatGPT 5.6 Luna — лёгкая модель для одного снимка
ChatGPT 5.6 Luna — самая быстрая и доступная модель серии ChatGPT 5.6. При этом она сохраняет контекст 1 050 000 токенов и принимает изображения, PDF, документы и таблицы.
Luna — вариант «на каждый день»: сфотографировать упражнение, получить краткий разбор, проверить ответ, попросить похожий пример. Для простого фото-задания её возможностей достаточно, а отвечает она заметно быстрее старших моделей. Если задача оказалась сложнее, чем выглядела на снимке, включите PRO-режим или отправьте то же фото в ChatGPT 5.6 Sol и сравните решения.
6. Claude Sonnet 5 — аккуратный разбор и работа с текстом на фото
Claude Sonnet 5 — модель Anthropic с контекстом до 1 000 000 токенов и поддержкой изображений в vision-режиме.
Сильная сторона Claude — внимательная работа с формулировками. По фото текстового задания — параграфа учебника, условия гуманитарной задачи, фрагмента произведения — модель составит план ответа, выделит главное, объяснит термин простым языком и проверит ваш текст. Для точных наук Sonnet 5 также подойдёт: отправьте снимок задачи и попросите решение по шагам, а непонятный этап разберите отдельно.
При этом у модели ограниченная мультимодальность по сравнению со специализированными решениями: сложную геометрию по чертежу или мелкий рукописный текст лучше дополнительно сверить с ответом второй модели.
7. Grok 4.7 — рассуждение по фото и проверка готового решения
Grok 4.7 — модель xAI с контекстом 500 000 токенов, которая принимает изображения, PDF, документы и таблицы вместе с запросом.
Grok удобен там, где по фото нужно не просто «решить», а последовательно рассуждать: разобрать условие, выбрать способ, выполнить несколько действий и проверить результат. Хороший сценарий — отправить фотографию уже решённой задачи и попросить модель выступить проверяющим: найти ошибку, указать спорное место и объяснить, как исправить. Также Grok подходит для скриншотов кода и задач по информатике.
8. Kimi K3 — несколько заданий с одного разворота
Kimi K3 — флагман Moonshot AI с контекстом 262 144 токена и поддержкой изображений, PDF, документов и таблиц.
Модель выручает, когда на фото не одна задача, а целый разворот учебника, вариант контрольной или несколько страниц конспекта. Загрузите снимки, попросите сначала объяснить тему раздела, затем решить примеры по шагам и в конце составить похожие задания для самостоятельной тренировки — Kimi удержит общий контекст и не придётся заново объяснять условия каждой задачи. Русский язык модель понимает свободно.
9. GLM 5.3 — нативная мультимодальность для чертежей и схем
GLM 5.3 — нативно мультимодальная модель Z.AI: текст, изображения и видео обрабатываются в единой архитектуре, контекст — до 1 000 000 токенов.
В этой подборке GLM 5.3 заменяет GLM 5.2 из прежних обзоров. Нативная — а не «пристроенная» — обработка изображений делает модель интересной для задач, где данные разнесены между текстом и рисунком: геометрический чертёж, схема по физике, скриншот с графиком. Попросите модель сначала перечислить, что она видит на изображении — точки, обозначения, значения, — и только потом решать. Так проще поймать ошибку распознавания до начала вычислений.
10. Qwen 3.8 Max — фото, графики и таблицы в одном запросе
Qwen 3.8 Max — мультимодальная модель Alibaba с контекстом до 1 000 000 токенов, которая работает с текстом, изображениями и видео.
Qwen удобна для заданий, где на фото — не чистый текст, а график, диаграмма или таблица: отправить снимок, попросить извлечь данные, объяснить, что показывает график, и решить задачу на его основе. Модель также сильна в объёмных материалах: можно загрузить фото нескольких страниц и задавать вопросы по всему массиву. Отдельно стоит отметить заявленные результаты модели в научных задачах — для сложной математики и физики это плюс, хотя финальный ответ всё равно стоит проверять.
Каких моделей не хватает в списке — и почему
В подборки «для домашки» часто включают DeepSeek и топовые текстовые Claude и ChatGPT последних версий. Для решения именно по фото мы их не взяли: по карточкам на STIVA, DeepSeek V4 Pro прямо заявлен как текстовая модель без приёма изображений, а у ChatGPT 6.1 Sol нативная обработка изображений не подтверждена. Такие модели отлично решают задачу, если перепечатать условие текстом, но фотографию условия они не обработают. Поэтому перед выбором модели проверяйте в её карточке поле «Работа с файлами»: там должно быть указано «изображения».
Как решить задачу по фото: пошаговая инструкция
- Сделайте читаемый снимок. Фотографируйте перпендикулярно странице, при хорошем свете, без бликов и обрезанных краёв. Формулы, степени, индексы и обозначения на чертеже должны читаться без увеличения.
- Обрежьте лишнее. Оставьте одно задание или один логически связанный блок: чем меньше постороннего текста на фото, тем точнее распознавание.
- Выберите мультимодальную модель из списка выше под тип задачи: сложная — Sol или Gemini Pro, повседневная — Luna или Flash, по чертежу — GLM 5.3 или Qwen 3.8 Max.
- Напишите, что нужно сделать с фото. Не просто «реши», а в каком формате: с объяснением, по шагам, с проверкой, проще/подробнее.
- Попросите сначала переписать условие. Это главный приём контроля: модель показывает распознанный текст, и вы сверяете цифры, знаки и обозначения до решения.
- Проверьте ответ. Сопоставьте результат с учебником, подставьте ответ в условие или отправьте то же фото второй модели и сравните ходы решения.
- Разберитесь, а не перепишите. Попросите объяснить непонятный шаг, дать похожую задачу и проверить уже ваше решение.
Готовые промпты для решения задач по фото
Универсальный:
На фото — задача. Сначала перепечатай условие точно так, как ты его распознал, включая все цифры и обозначения. Затем реши задачу по шагам: что дано, какая формула или правило применяется, промежуточные вычисления, ответ. В конце проверь ответ подстановкой.
Если нужен не ответ, а понимание:
На фото — задача. Не давай готовое решение. Объясни, как к нему подойти: какой это тип задачи, что нужно вспомнить и какой первый шаг. Дальше я попробую сам, а ты проверишь.
Для геометрии и задач с чертежом:
На фото — задача с чертежом. Сначала перечисли всё, что отмечено на рисунке: фигуры, точки, углы, равные элементы и числовые значения. Затем реши задачу по шагам и обоснуй каждый вывод теоремой или свойством.
Для проверки своего решения:
На первом фото — условие, на втором — моё решение. Проверь каждый шаг, найди первую ошибку и объясни, почему там ошибка. Правильное решение целиком не пиши — дай подсказку, чтобы я исправил сам.
Объяснить проще:
Реши задачу с фото и объясни решение так, как будто объясняешь ученику [класс] класса: без сложных терминов, на простом примере из жизни, а в конце — короткое правило, которое нужно запомнить.
От чего зависит точность решения по фото
- Качество снимка. Размытое фото, блик на глянцевой странице и обрезанный край — главная причина неверных ответов. Модель не «додумывает» цифру, которую не видит: она может прочитать её неправильно и уверенно решить не ту задачу.
- Сложность визуальных данных. Печатный текст распознаётся лучше рукописного, а простой график — лучше плотного чертежа с десятком обозначений.
- Формулировка запроса. «Реши» даёт короткий ответ. «Перепиши условие, реши по шагам и проверь» даёт контролируемый результат.
- Тип модели. Для фото нужна именно мультимодальная модель. Сильная текстовая модель без vision не заменит её, каким бы хорошим ни был её «мозг».
- Проверка. Нейросети иногда ошибаются даже в арифметике. Подстановка ответа, решение другим способом и сверка со второй моделью занимают минуту и отсекают большинство ошибок.
Преимущества и ограничения решения задач по фото
Плюсы:
- не нужно перепечатывать длинное условие с формулами и чертежом;
- ответ — с пошаговым объяснением, а не одна цифра, как в классическом ГДЗ;
- можно уточнять, просить проще или другим способом, получать похожие задачи;
- модель находит ошибку в вашем решении, а не просто показывает чужое;
- одно фото можно отправить разным моделям и сравнить объяснения.
Минусы:
- ошибка распознавания одной цифры меняет всю задачу;
- рукописный и мелкий текст читаются хуже печатного;
- модель может уверенно выдать неверный ход решения — проверку никто не отменял;
- качественные снимки с чертежами и графиками получаются не с первого раза;
- готовые ответы провоцируют списывание, если не просить объяснение и тренировку.
Частые вопросы
Какая нейросеть лучше всего решает задачи по фото?
Для сложных многошаговых задач — ChatGPT 5.6 Sol и Gemini 3.1 Pro Preview. Для повседневных заданий по одному снимку — ChatGPT 5.6 Luna и Gemini 3.8 Flash: они быстрее и проще. Для задач с чертежами и графиками стоит попробовать GLM 5.3 и Qwen 3.8 Max.
Можно ли решить по фото задачу, написанную от руки?
Да, современные мультимодальные модели читают рукописный текст, а у Gemini 3.1 Pro Preview работа с рукописными пометками заявлена отдельно. Но после распознавания обязательно сверьте переписанное моделью условие с оригиналом: одна неверно прочитанная цифра — и решение будет формально правильным, но не для вашей задачи.
Что делать, если нейросеть решила задачу неправильно?
Попросите её сначала перепечатать условие и проверьте распознавание. Затем отправьте то же фото второй модели из подборки и сравните, на каком шаге решения разошлись. Также помогает запрос «реши другим способом и сравни ответы».
Можно ли отправлять фото контрольной или экзамена?
Технически — да, но использовать нейросеть на контрольной и экзамене нельзя: это нарушение правил, а в ряде случаев — и основание для аннулирования работы. Решение по фото предназначено для домашки, самоподготовки и разбора тем.
Решение по фото — это списывание?
Зависит от того, как пользоваться. Если переписать ответ, не читая, — да. Если попросить объяснить условие, подсказать первый шаг, проверить собственное решение и потренироваться на похожей задаче — это формат цифрового репетитора.
Итог
Нейросети для решения задач по фото уже заменяют классическое ГДЗ: они распознают условие с учебника, доски или черновика, показывают ход решения и объясняют его на вашем уровне. Главное — выбирать именно мультимодальную модель, делать читаемый снимок и всегда просить модель сначала переписать распознанное условие.
Начните с быстрой ChatGPT 5.6 Luna или Gemini 3.8 Flash для обычных заданий, сложную задачу отправьте в ChatGPT 5.6 Sol или Gemini 3.1 Pro Preview, а чертёж или график проверьте в GLM 5.3 или Qwen 3.8 Max. Все эти модели доступны в одном чате на STIVA.ai — можно решить одну и ту же задачу разными нейросетями и выбрать объяснение, после которого тема действительно стала понятной.