10 лучших нейросетей, чтобы убрать голос из песни онлайн
Создание качественной минусовки или чистой акапеллы долгое время оставалось задачей для профессиональных звукорежиссеров, требующей доступа к студийным исходникам. Сегодня алгоритмы машинного обучения способны анализировать спектр аудиофайла и с высокой точностью распознавать паттерны человеческой речи, отделяя их от звучания музыкальных инструментов.
Мы изучили актуальные ИИ-инструменты и собрали 10 сервисов, которые помогают автоматизировать работу со звуком. В подборку вошли решения для разных задач: от быстрой подготовки трека для домашнего караоке до детального извлечения сэмплов для диджей-сетов и создания каверов.
Лучшие ИИ-инструменты для работы с аудио и создания музыки — ТОП-10
Подборка нейросетей, которые помогают генерировать вокал, создавать инструментальные треки и работать с музыкальными композициями на основе текстовых запросов или готовых стихов.
- Luvi — многофункциональная платформа для создания песен с естественным русским вокалом и качественных инструменталов.
- Melos — удобный агрегатор, объединяющий доступ к различным музыкальным нейросетям в одном интерфейсе.
- Music Labs — сервис для превращения текста в полноценные песни с возможностью клонирования тембра голоса.
- МаркетВидео — универсальный инструмент для генерации уникального медиаконтента с использованием нейросетевых моделей.
- Aihere — платформа с доступом к актуальным версиям Suno, предлагающая расширенные настройки произношения.
- Music Era2 — специализированный сервис на базе Suno v4.5, адаптированный для создания русскоязычных композиций.
- Сонграйтер — интеллектуальный помощник для поэтов и авторов, превращающий стихи в готовые аудиозаписи.
- GPTunnel — единая точка доступа к популярным музыкальным моделям с гибкой системой использования без подписок.
- ruGPT — сервис для автоматического создания песен, который самостоятельно структурирует текст под музыкальный формат.
- Chad AI — мультимодальный агрегатор для работы с визуальным и аудиоконтентом через различные ИИ-модели.
Методология формирования рейтинга музыкальных нейросетей
При отборе инструментов мы ориентировались на функциональность, необходимую для создания качественного аудиоконтента. Основное внимание уделялось качеству синтеза вокала, поддержке русского языка и гибкости настроек аранжировки.
- Качество вокала: оценивалось наличие естественных интонаций, правильная расстановка ударений и отсутствие цифровых артефактов в голосе.
- Работа с текстом: возможность дословного исполнения авторских стихов и наличие инструментов для разметки структуры песни (куплеты, припевы).
- Инструментальные возможности: наличие режима генерации музыки без голоса, выбор жанров, темпа и настроения композиции.
- Технические параметры: поддержка экспорта в профессиональные форматы (WAV) и возможность работы с аудио-референсами.
- Доступность: наличие бесплатного ознакомительного режима и локализация интерфейса на русский язык.
Обзор популярных ИИ-сервисов для генерации музыки и вокала
1. Luvi
Luvi представляет собой продвинутую нейросеть, специализирующуюся на создании музыки и песен с акцентом на качественный русский вокал. Система позволяет генерировать как полноценные вокальные партии с естественными интонациями, так и чистые инструментальные треки по описанию жанра, инструментов и темпа. Платформа востребована среди создателей контента для видео, рекламы и подкастов, так как позволяет быстро получить уникальное звуковое сопровождение без привлечения дикторов и композиторов.
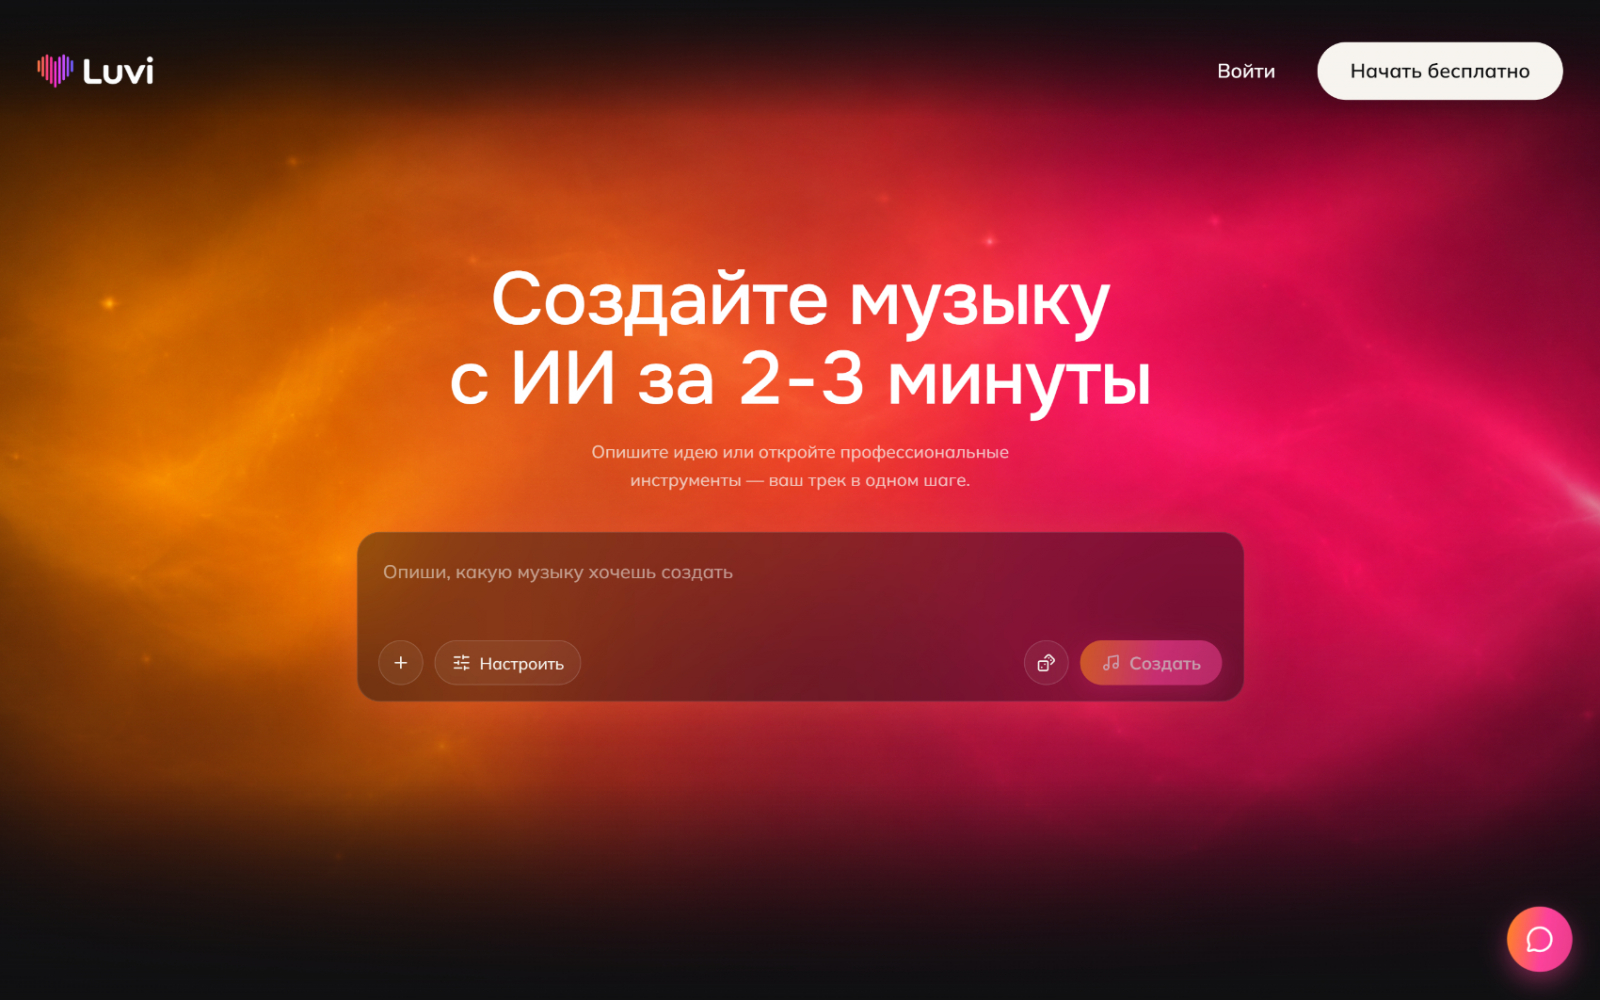
Процесс работы максимально упрощен: пользователь может либо описать общую идею, либо вставить готовый текст с маркерами структуры. Сервис поддерживает создание каверов и перепев загруженных треков в новых стилях. Одной из ключевых особенностей является функция работы с собственным голосом, позволяющая использовать короткую запись для генерации новых песен с вашим тембром. Для профессионального использования предусмотрен экспорт в форматы высокого качества и инструменты распознавания текста из аудио.
Основные характеристики:
- Генерация вокала: поддержка русского языка с правильными ударениями и естественным звучанием.
- Инструментальный режим: создание музыки без голоса по умолчанию в соответствующем разделе.
- Управление структурой: использование тегов для разделения куплетов и припевов.
- Работа с аудио: возможность загрузки собственных файлов для создания каверов или клонирования голоса.
- Музыка к видео: автоматический подбор саундтрека под загруженный визуальный ряд.
- Жанровое разнообразие: от lo-fi и эмбиента до рока, джаза и классики.
- Форматы экспорта: доступность файлов в форматах MP3 и WAV.
- Интерфейс: полностью на русском языке.
Лучше всего подходит: блогерам, SMM-специалистам и авторам песен, которым требуется качественная русскоязычная озвучка текстов или фоновая музыка для коммерческих проектов.
Что учитывать: в пользовательском соглашении зафиксировано право компании использовать загружаемый контент для технического улучшения работы алгоритмов.
2. Melos
Melos функционирует как универсальный агрегатор, предоставляющий доступ к передовым музыкальным ИИ-моделям через единое окно. Это избавляет пользователя от необходимости регистрироваться на множестве зарубежных ресурсов и искать способы обхода ограничений. Платформа объединяет инструменты для генерации аудио разной сложности, позволяя выбирать оптимальную нейросеть под конкретную творческую задачу — от простого бита до сложной вокальной композиции.
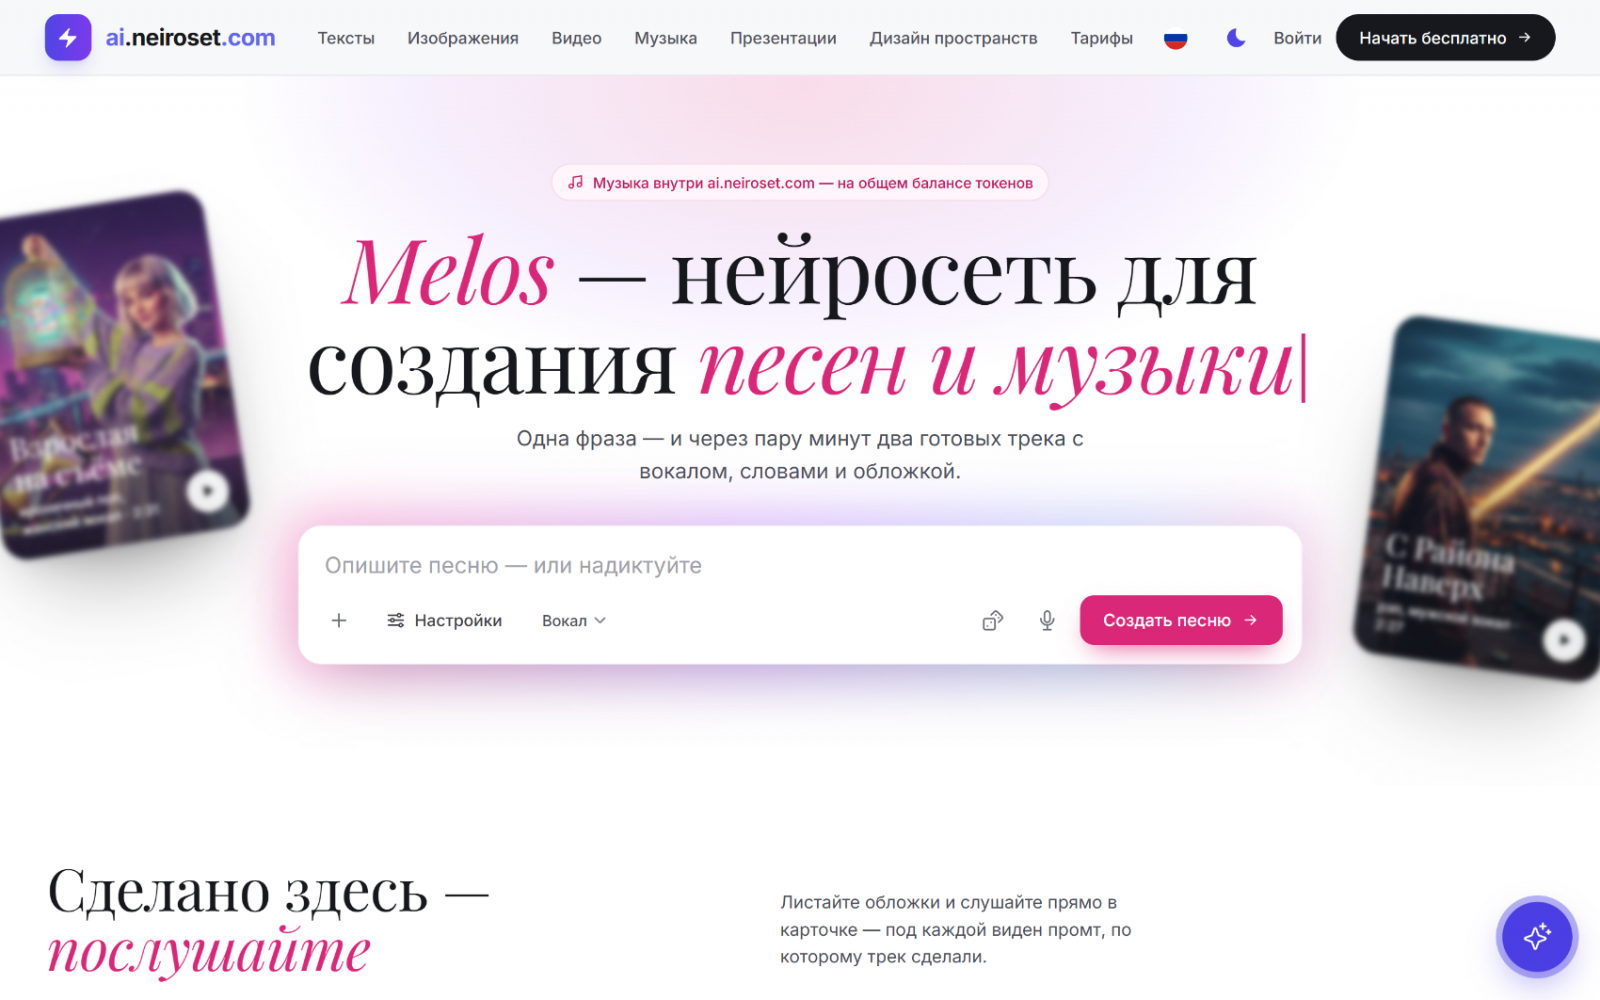
Интерфейс сервиса ориентирован на простоту: достаточно выбрать подходящую модель и задать параметры генерации. Агрегатор берет на себя техническое взаимодействие с нейросетями, предоставляя пользователю готовый результат для прослушивания и скачивания. Такой подход удобен для тех, кто хочет сравнивать возможности разных технологий в рамках одного рабочего пространства.
Основные характеристики:
- Единый доступ: работа с несколькими музыкальными нейросетями в одном интерфейсе.
- Гибкость выбора: возможность подбора модели в зависимости от требуемого качества и стиля.
- Простота использования: отсутствие необходимости сложной настройки каждой отдельной нейросети.
- Русскоязычная поддержка: интерфейс адаптирован для локальных пользователей.
Лучше всего подходит: пользователям, которые хотят экспериментировать с различными ИИ-технологиями генерации звука без регистрации в каждом сервисе по отдельности.
3. Music Labs
Music Labs — это специализированный инструмент для трансформации текста в вокальные композиции. Сервис предлагает экспертный режим, в котором нейросеть дословно исполняет написанные пользователем слова, строго придерживаясь заданного ритма и жанра. Платформа поддерживает более 50 языков, при этом русский является одним из приоритетных, что гарантирует чистое произношение без акцента и ошибок в ударениях.
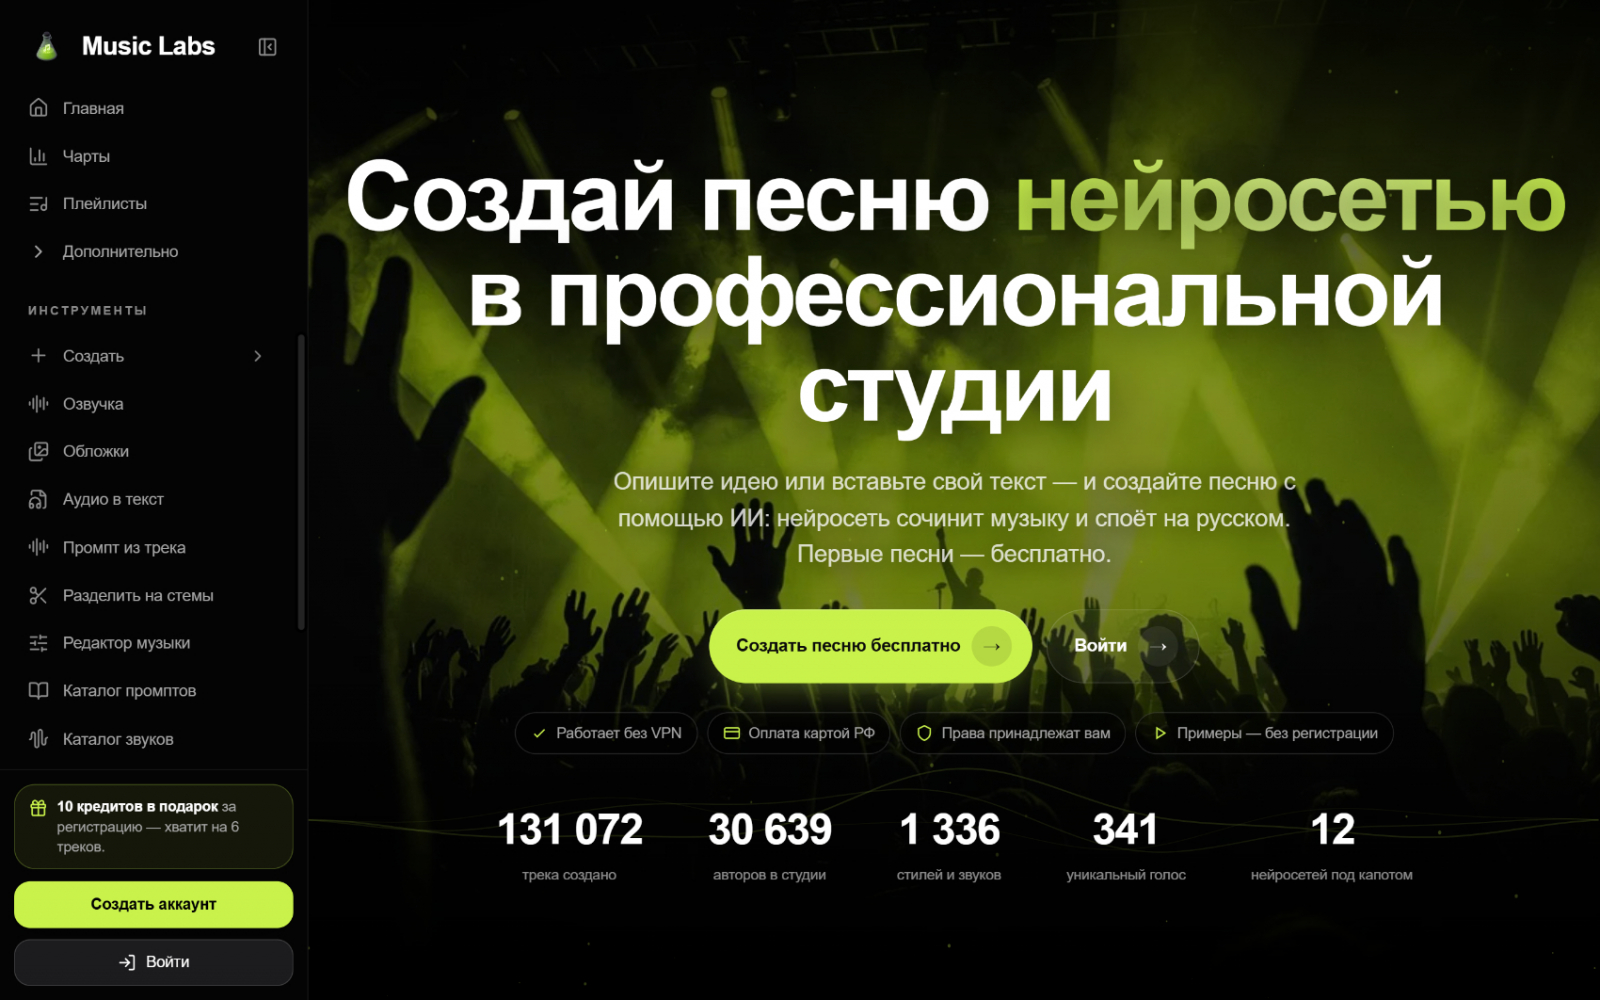
Уникальной чертой сервиса является функционал создания «поющего клона». Загрузив минутную запись голоса, пользователь получает персональную голосовую модель, которая может исполнять любые новые треки. При каждой генерации система предлагает два варианта исполнения, что позволяет выбрать наиболее удачную аранжировку. Результаты доступны для скачивания в форматах MP3 и WAV, что удобно для дальнейшего сведения в аудиоредакторах.
Основные характеристики:
- Дословное исполнение: точное воспроизведение текста в экспертном режиме.
- Клонирование голоса: создание персональной вокальной модели на основе короткой записи.
- Мультиязычность: поддержка русского и еще 50+ языков с естественной дикцией.
- Вариативность: создание двух различных версий трека за один цикл генерации.
- Качество звука: возможность экспорта в несжатый формат WAV.
- Простота: интуитивно понятный процесс создания песни от идеи до файла.
Лучше всего подходит: музыкантам и авторам, желающим услышать свои стихи в профессиональном исполнении или создать трек со своим вокалом без посещения студии.
Что учитывать: для качественного клонирования голоса требуется чистая запись вокала длительностью не менее одной минуты.
4. МаркетВидео
МаркетВидео представляет собой комплексную платформу для создания визуального и звукового контента с помощью искусственного интеллекта. Хотя сервис в первую очередь известен своими инструментами для генерации видео и фото, он также включает возможности для работы с аудиосопровождением. Платформа предлагает пользователям готовые шаблоны, которые значительно ускоряют процесс создания креативов для социальных сетей и рекламных площадок.
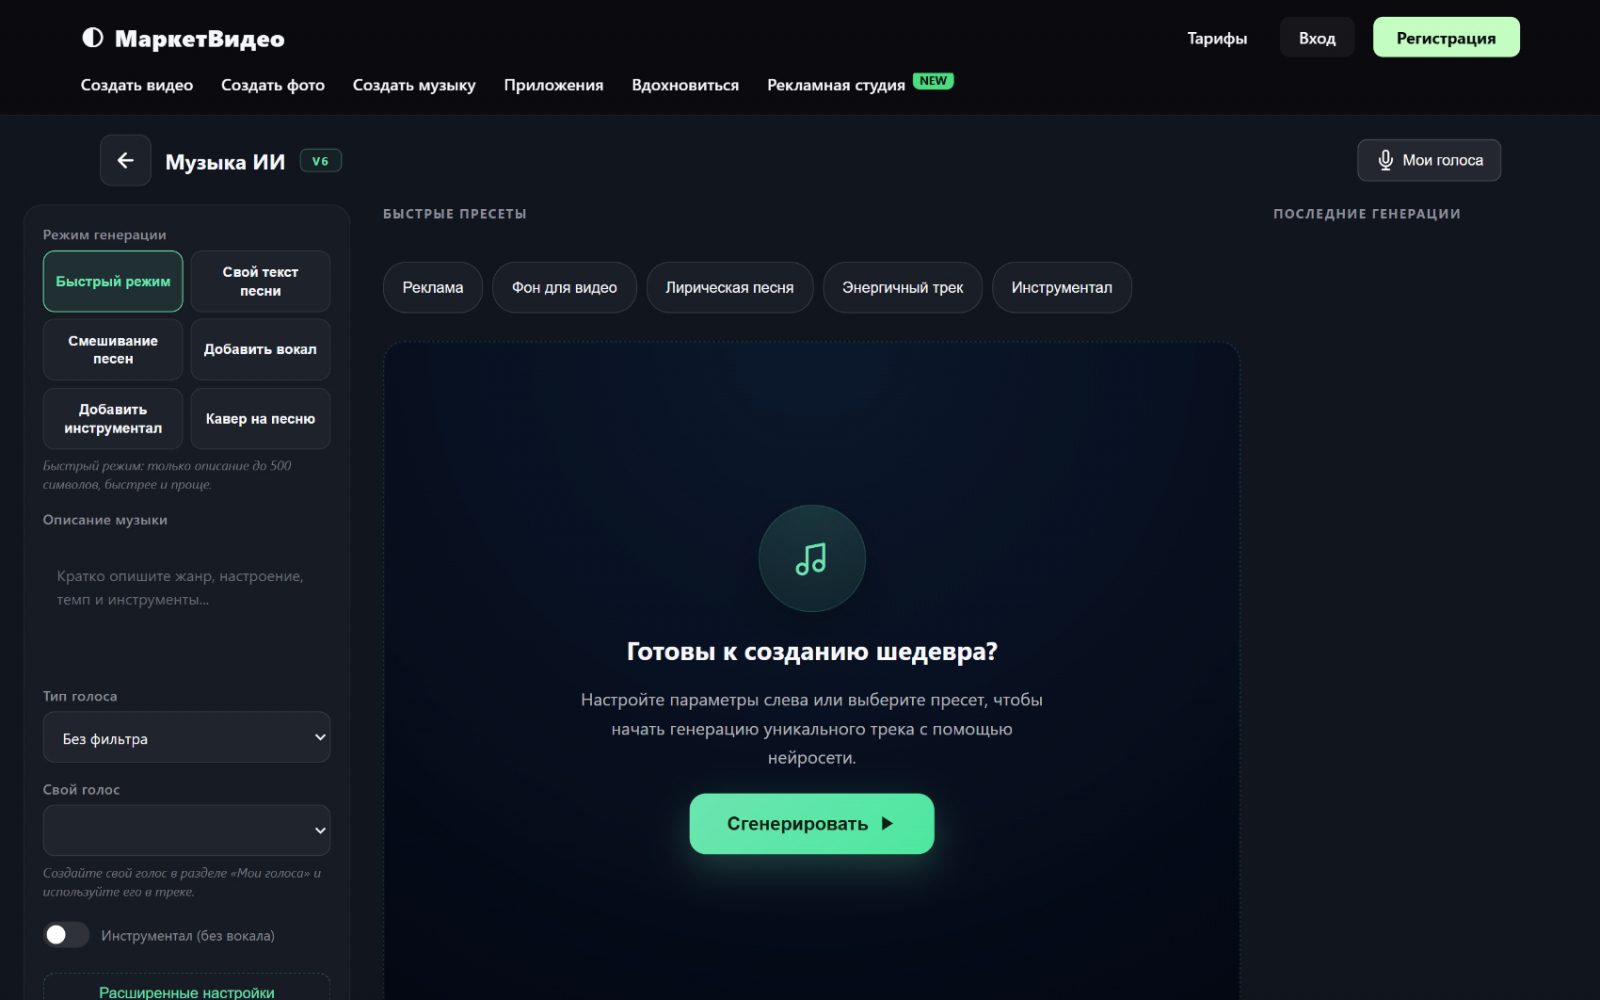
Сервис полностью локализован и доступен через веб-интерфейс, а также через мобильные приложения в популярных магазинах. Это делает его удобным инструментом для мобильного маркетинга и быстрого создания контента «на ходу». Пользователи могут генерировать уникальные материалы, комбинируя визуальные эффекты с нейросетевой музыкой, создавая целостные медиапроекты в рамках одной экосистемы.
Основные характеристики:
- Мультимодальность: инструменты для создания видео, фото и аудио в одном месте.
- Шаблоны: наличие готовых пресетов для быстрой генерации контента.
- Мобильность: наличие приложений для смартфонов на базе Android.
- Локализация: интерфейс и поддержка на русском языке.
Лучше всего подходит: SMM-менеджерам и создателям видеоконтента, которым нужен универсальный комбайн для генерации медиафайлов.
5. Aihere
Aihere выступает в роли мощного агрегатора, предоставляющего доступ к последним версиям нейросети Suno. Сервис выделяется среди конкурентов наличием специфических инструментов для тонкой настройки вокала: функций расстановки ударений и управления «разговорным» произношением. Это позволяет избежать типичных для ИИ ошибок при пении на русском языке, делая результат более профессиональным и пригодным для публикации.
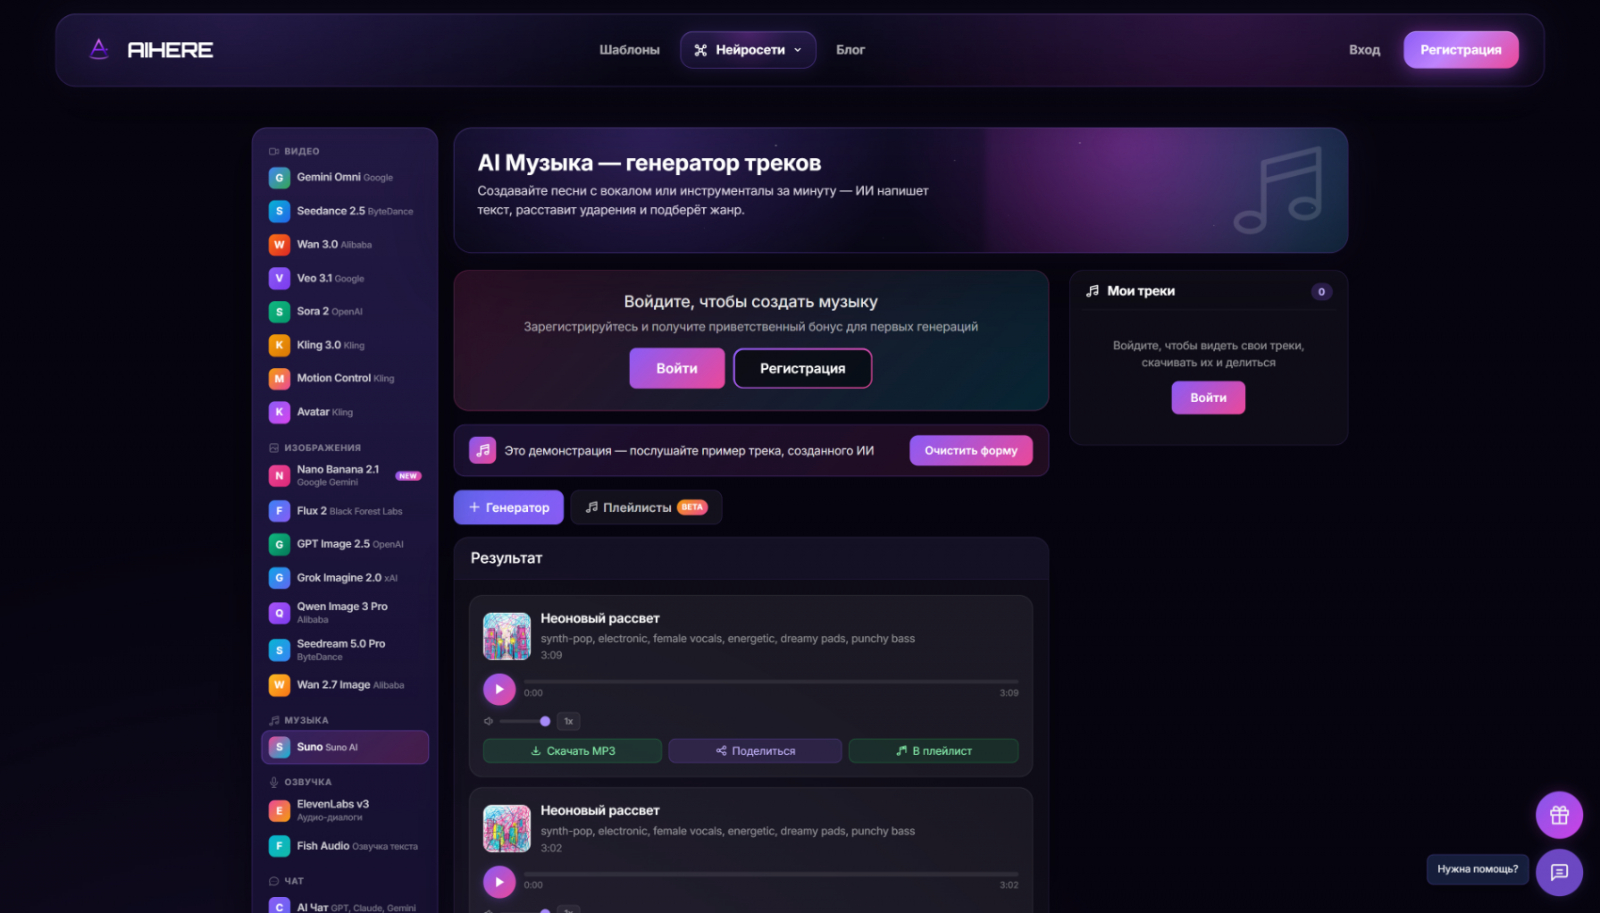
Платформа поддерживает генерацию треков длительностью до 8 минут, что позволяет создавать полноценные музыкальные произведения, а не только короткие фрагменты. Пользователи могут выбирать между мужским и женским вокалом, а также использовать режим «Инструментал» для создания минусовок. Система работает по принципу единого баланса, который можно использовать для доступа к музыкальным, видео- и текстовым моделям одновременно.
Основные характеристики:
- Актуальные модели: доступ к Suno версий V4.5 и V5.5.
- Коррекция вокала: ручное управление ударениями и спецификой произношения слов.
- Длительные композиции: возможность создания треков до 8 минут.
- Жанровый охват: поддержка широкого спектра стилей от хип-хопа до классики.
- Текстовый помощник: встроенный ИИ для написания лирики.
- Структурирование: поддержка тегов для управления композицией трека.
Лучше всего подходит: продвинутым пользователям, которым важен контроль над нюансами произношения и возможность создавать длинные аудиозаписи.
Что учитывать: коммерческое использование результатов генерации требует предварительного согласования с администрацией сервиса.
6. Music Era2
Music Era2 — это специализированное решение для тех, кому нужны персональные песни на русском языке. Сервис базируется на модели Suno v4.5, дополненной уникальным «русским адаптером», который значительно улучшает понимание контекста и фонетики русского языка. Основной упор сделан на создание праздничного и подарочного контента: на сайте представлены готовые сценарии для свадеб, юбилеев и других семейных событий.
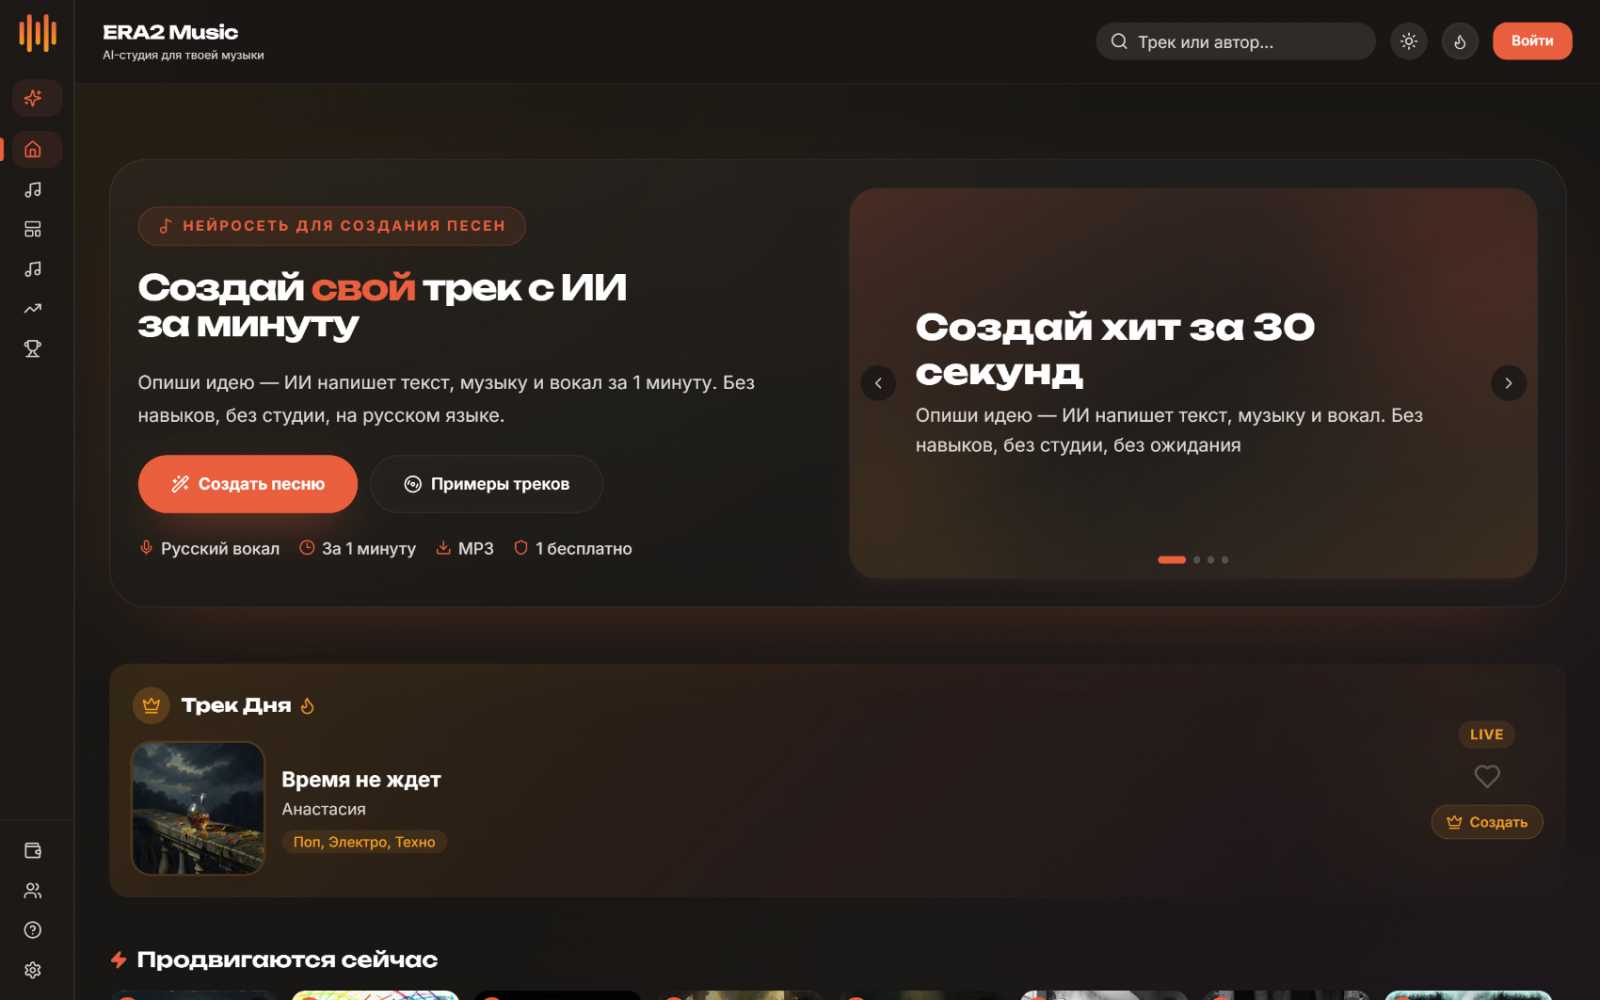
Пользователь может выбрать один из множества стилей — от рок-баллады до современного дрилла. Система генерирует два варианта композиции, позволяя выбрать наиболее подходящий по настроению. Важным преимуществом является то, что сервис работает без необходимости использования дополнительных инструментов для доступа и поддерживает локальные способы взаимодействия. Готовые работы сохраняются в личном кабинете и доступны для скачивания в формате MP3.
Основные характеристики:
- Русский адаптер: улучшенное качество вокала и понимание текстов на русском языке.
- Сценарные шаблоны: готовые формы для создания песен к праздникам и событиям.
- Разнообразие стилей: выбор из более чем 10 популярных музыкальных направлений.
- Бесплатный старт: возможность протестировать сервис без привязки платежных данных.
- Удобство: простая система генерации в несколько кликов.
Лучше всего подходит: частным пользователям для создания музыкальных подарков и поздравлений, а также начинающим блогерам.
Что учитывать: по умолчанию предоставляется неисключительная лицензия, а для коммерческого использования требуется отдельное разрешение.
7. Сонграйтер
Сонграйтер позиционируется как идеальный инструмент для поэтов, желающих превратить свои стихи в полноценные песни. Сервис оснащен интеллектуальным редактором, который анализирует размер стиха, падежи и рифмы, адаптируя текст под выбранный музыкальный жанр. Помимо аудиофайлов в форматах MP3 и WAV, платформа умеет создавать караоке-видео, что делает её отличным выбором для подготовки контента для YouTube или социальных сетей.
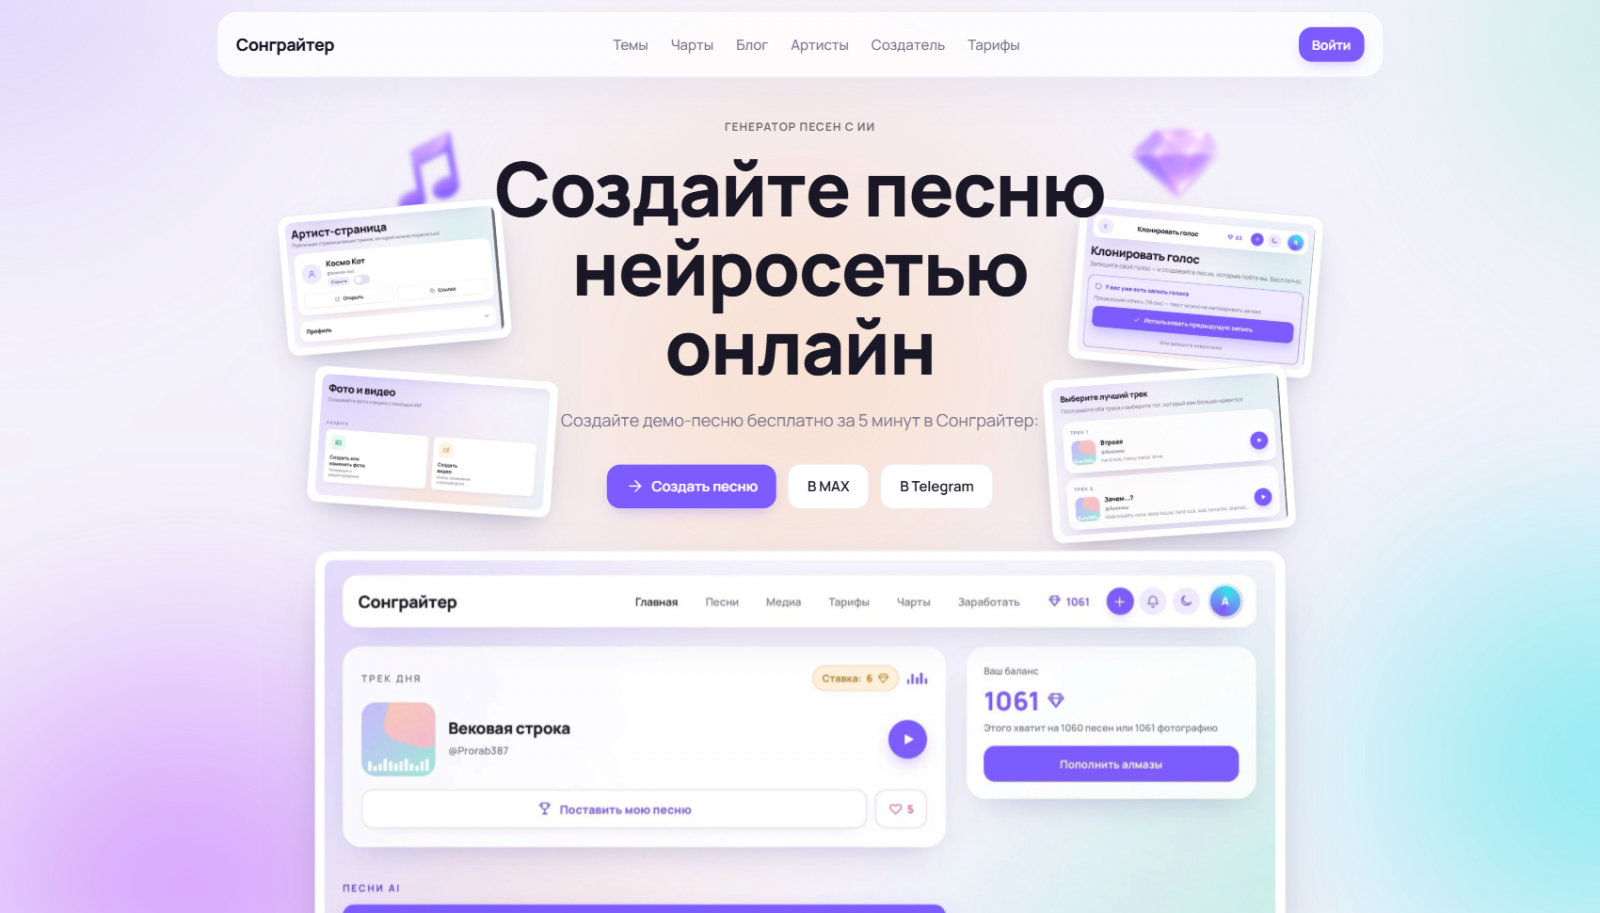
Функционал «Голосовая персона» позволяет пользователям обучать нейросеть на собственном голосе, создавая уникального виртуального вокалиста. Это открывает широкие возможности для брендинга и создания авторского контента. Важным отличием является прозрачная политика в отношении авторских прав: сгенерированные материалы полностью принадлежат пользователю, включая право на их продажу и использование в рекламе.
Основные характеристики:
- AI-редактор текста: помощь в доработке ритма и рифмовки стихов.
- Караоке-режим: генерация видео с текстом в формате MP4.
- Собственный вокалист: создание голосовой модели на базе записи пользователя.
- Высокое качество: поддержка экспорта в WAV.
- Полные права: разрешение на коммерческое использование и монетизацию.
Лучше всего подходит: авторам текстов, поэтам и музыкантам, ориентированным на коммерческое использование своего творчества.
8. GPTunnel
GPTunnel предлагает удобный формат доступа к топовым музыкальным нейросетям, таким как Suno, Mureka и MiniMax. Главная особенность сервиса — отсутствие необходимости оформлять подписку на каждый отдельный инструмент. Пользователь пополняет единый баланс и расходует его только на конкретные генерации, что значительно экономит средства при нерегулярном использовании ИИ-инструментов.
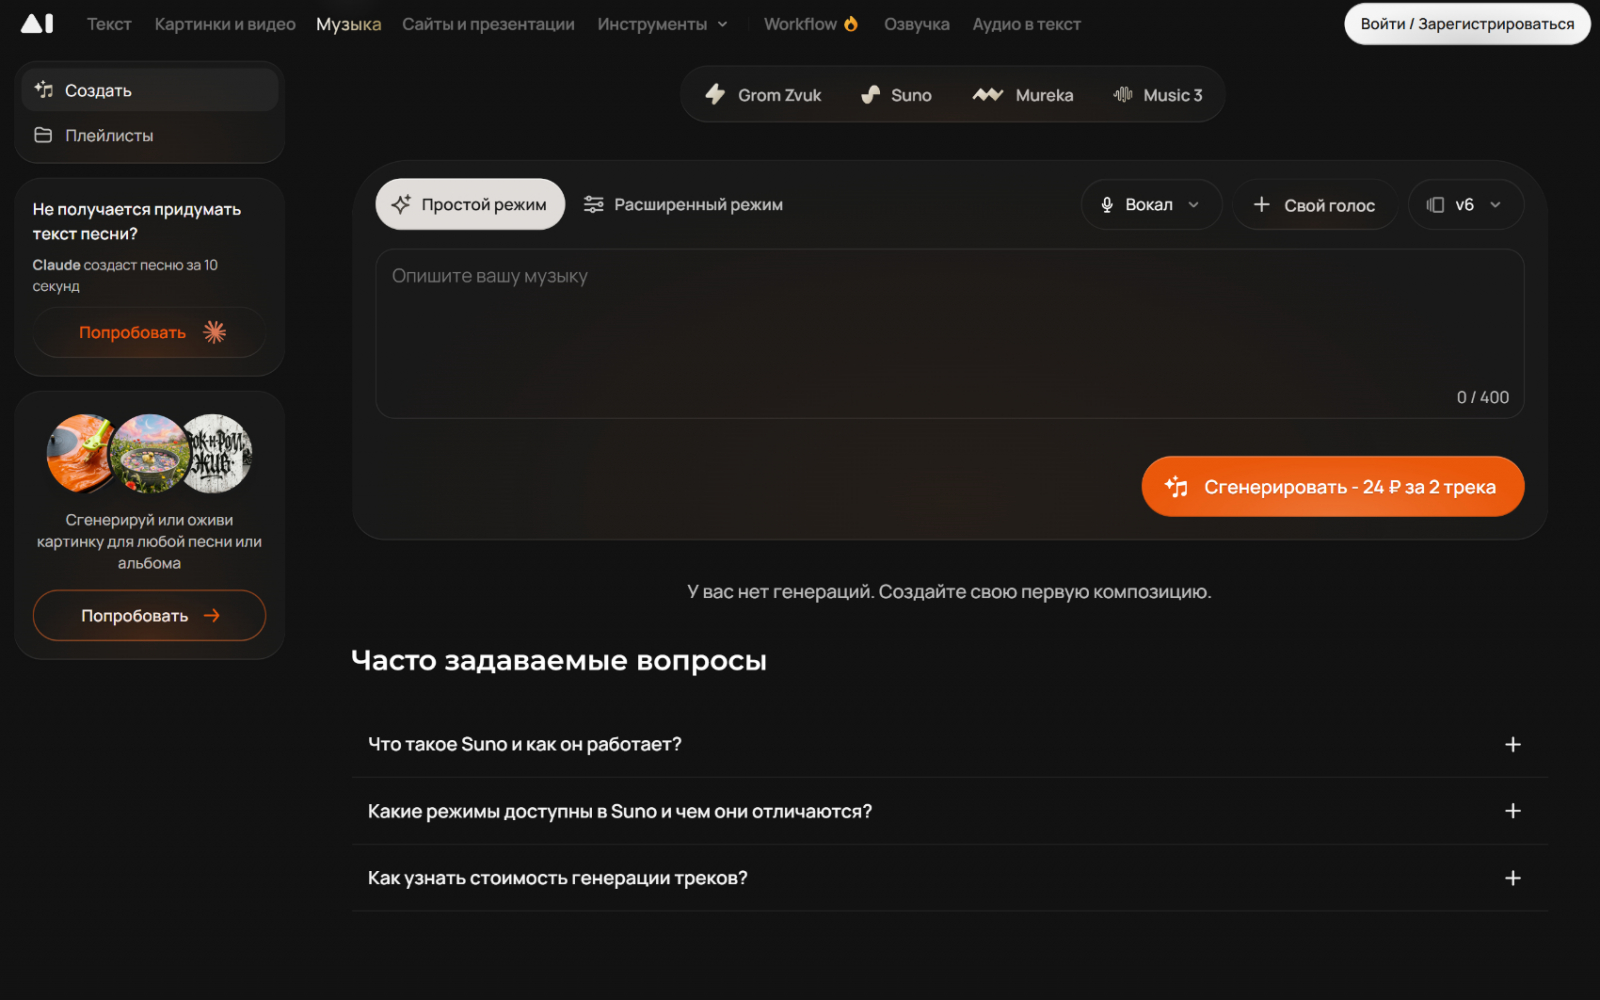
В музыкальном разделе доступна актуальная модель Suno V5.5, поддерживающая расширенный режим работы с текстом. Пользователь может гибко настраивать параметры трека или создавать чистые минусовки в режиме «Инструментал». Благодаря объединению нескольких моделей в одном месте, сервис позволяет быстро переключаться между разными алгоритмами генерации для достижения наилучшего результата.
Основные характеристики:
- Мультимодельность: доступ к Suno, Mureka и MiniMax в одном кабинете.
- Отсутствие подписок: оплата только за фактически выполненные запросы.
- Расширенный режим: детальная настройка структуры и текста песни.
- Инструментал: быстрый переключатель для создания музыки без вокала.
- Русский интерфейс: простая навигация и поддержка.
Лучше всего подходит: фрилансерам и творческим специалистам, которым периодически требуются разные ИИ-модели для работы со звуком.
9. ruGPT
ruGPT — это многофункциональная платформа, которая упрощает процесс создания песен на базе Suno до максимума. Сервис берет на себя самую сложную часть работы — структурирование текста. Пользователь может загрузить длинное стихотворение или даже рассказ, а нейросеть самостоятельно разделит его на логические блоки (куплеты, припевы, бриджи) и подберет соответствующий ритмический рисунок.
Помимо музыкального генератора, платформа предоставляет широкий спектр других ИИ-инструментов, включая озвучку текста и транскрибацию аудио. Это делает ruGPT полезным инструментом для комплексной работы с контентом. Созданные музыкальные треки разрешены к использованию в коммерческих целях, что позволяет без опасений вставлять их в видеоролики для соцсетей или рекламные интеграции.
Основные характеристики:
- Автоструктурирование: автоматическое разделение текста на части песни.
- Длинные тексты: возможность работы с объемными литературными формами.
- Коммерческая лицензия: право на использование треков в бизнесе и соцсетях.
- Комплексность: доступ к генерации изображений и текстов в том же интерфейсе.
- Формат: скачивание готовых работ в MP3.
Лучше всего подходит: пользователям, у которых есть готовые тексты, но нет навыков их музыкальной разметки.
10. Chad AI
Chad AI замыкает подборку как мощный инструмент для генерации и обработки медиафайлов. Хотя основной фокус платформы направлен на работу с изображениями (включая такие модели, как Midjourney и Flux), она также предоставляет возможности для генерации аудио и видео. Сервис позволяет работать с референсами: пользователь может загрузить до четырех исходных файлов, чтобы задать нейросети нужное направление для творчества.
Платформа отличается высокой скоростью работы — генерация контента занимает в среднем от 3 до 5 секунд. Это делает Chad AI отличным выбором для быстрого прототипирования идей. Благодаря поддержке высокого разрешения (до 4K для изображений) и возможности детального редактирования объектов, сервис подходит для профессиональных дизайнеров и контент-мейкеров, которым важна эстетическая составляющая их проектов.
Основные характеристики:
- Широкий выбор моделей: доступ к Nano Banana, Midjourney, Flux и другим.
- Работа с референсами: использование до 4 исходных картинок для генерации.
- Высокая скорость: получение результата за несколько секунд.
- Редактирование: возможность изменять отдельные элементы на готовых кадрах.
- Многозадачность: инструменты для текста, фото, видео и аудио в одном месте.
Лучше всего подходит: креаторам и дизайнерам, которым нужен быстрый доступ к визуальным и звуковым нейросетям для создания комплексного контента.
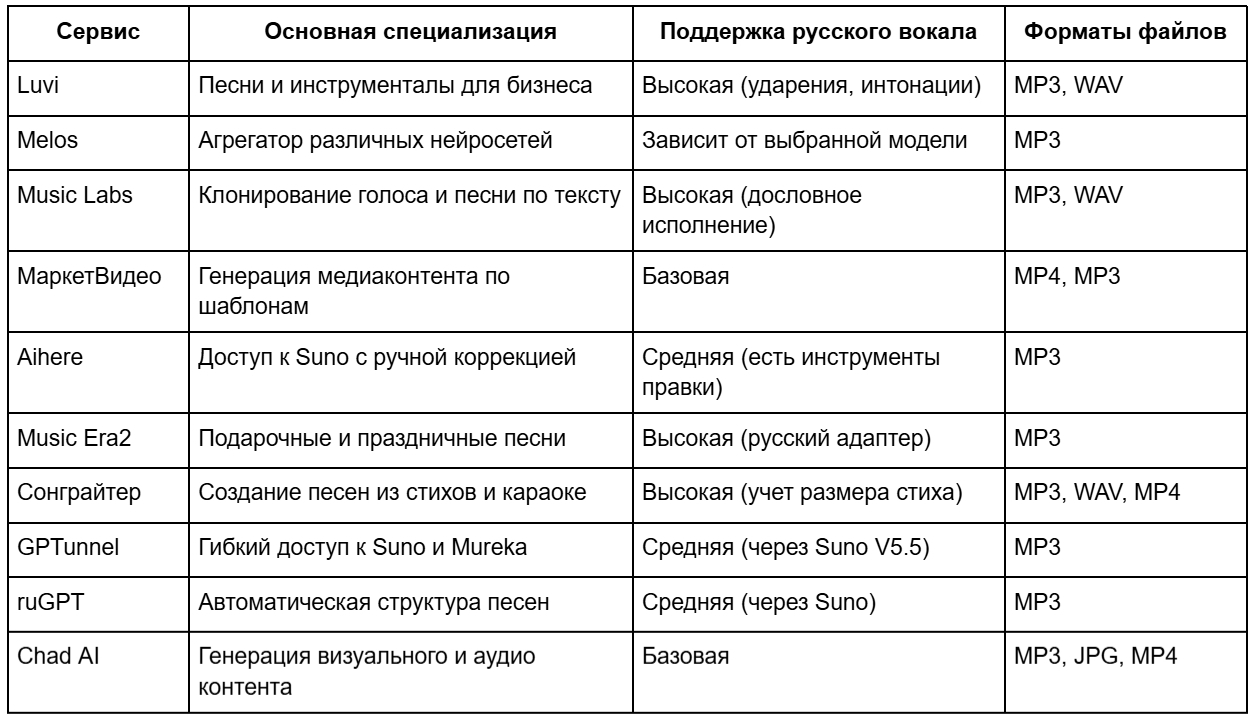
Сравнение возможностей музыкальных ИИ-сервисов
Как выбрать подходящую нейросеть для работы со звуком
Выбор конкретного инструмента зависит от ваших целей и исходных материалов. Для тех, кто хочет создать песню на свои стихи с качественным русским вокалом, оптимальным выбором станут Luvi, Music Labs или Сонграйтер. Эти сервисы лучше всего справляются с фонетикой русского языка и позволяют точно передать авторский текст.
Если ваша задача — получить трек со своим собственным голосом, стоит обратить внимание на Music Labs или Сонграйтер. Функция клонирования голоса в этих сервисах позволяет создать виртуального вокалиста на основе короткой записи вашего пения.
Для профессиональной работы и создания минусовок лучше использовать Luvi или агрегаторы вроде Melos и GPTunnel. Они предоставляют доступ к качественным инструментальным моделям и позволяют скачивать результат в формате WAV, который необходим для дальнейшего сведения и мастеринга.
В случаях, когда нужно быстро сделать музыкальное поздравление или подарок, идеально подойдет Music Era2 благодаря наличию готовых праздничных шаблонов. А если у вас есть длинный текст без четкой структуры, сервис ruGPT поможет автоматически превратить его в логически выстроенную песню с куплетами и припевами.
Пошаговая инструкция: как отделить вокал от инструментала
Процесс работы с ИИ-ремуверами сегодня стандартизирован и не требует установки сложных студийных программ. Чтобы убрать голос из песни онлайн, достаточно выполнить простой универсальный алгоритм, который поддерживается большинством современных платформ. Вся процедура от загрузки до получения готового файла обычно занимает пару минут.
Подготовка аудиофайла и загрузка
Качество итоговой минусовки напрямую зависит от того, какой файл вы отдаете алгоритму. Нейросети обучаются на студийных записях высокого разрешения, поэтому они гораздо лучше справляются с чистыми исходниками. Если загрузить пережатый файл, пересланный несколько раз через мессенджеры, ИИ может запутаться в частотах из-за цифрового шума.
Перед тем как отделить голос от музыки, проверьте формат и битрейт вашего аудио. Идеальным вариантом станет использование несжатых форматов, таких как WAV или FLAC. Если вы работаете с MP3, убедитесь, что его битрейт составляет не менее 320 kbps. Чем больше звуковой информации содержит оригинальный файл, тем точнее алгоритм распознает и вырежет человеческую речь, оставив музыкальную подложку нетронутой.
Выбор режима разделения трека на дорожки
Многие сервисы предлагают пользователю выбрать глубину обработки в зависимости от конечной цели. Разделить трек на дорожки нейросеть может по нескольким сценариям:
- Базовое разделение (2 стема). Алгоритм выдает только две дорожки: чистый голос (акапеллу) и всю остальную музыку (минусовку). Это оптимальный выбор, если вам нужно просто подготовить трек для домашнего караоке или записать кавер.
- Продвинутое разделение (4 и более стемов). ИИ разбивает композицию на вокал, ударные, бас и остальные инструменты (синтезаторы, гитары, клавишные). Этот режим незаменим для диджеев и саунд-продюсеров, которым нужно вырезать вокал из бита или взять отдельную партию баса для создания ремикса.
Проверка результата и скачивание минусовки
После завершения обработки не спешите сразу скачивать готовые файлы. Обязательно воспользуйтесь функцией предпрослушивания, которая есть практически на каждом сайте, где можно убрать голос из песни. Алгоритмы машинного обучения могут отлично справиться с куплетами, но допустить ошибки в сложных местах композиции.
Особое внимание уделите припевам, где звучит максимальное количество инструментов, и моментам с активным бэк-вокалом. Перемещайте ползунки громкости во встроенном плеере, чтобы послушать инструментал отдельно. Если в кульминации трека остались обрывки слов или музыка звучит слишком глухо, возможно, стоит попробовать другой сервис или загрузить исходник в лучшем качестве. Только убедившись в чистоте звучания, экспортируйте результат.
От чего зависит качество удаления вокала из трека
Пользователи часто ожидают от нейросетей студийного чуда, надеясь получить идеальный минус из старой диктофонной записи или видеоролика с плохим звуком. Однако ИИ не всесилен. Технология опирается на спектральный анализ, и на итоговый результат сильно влияют технические характеристики самой композиции.
Даже самый продвинутый ремувер вокал может выдать разный результат на двух песнях одного и того же исполнителя. Успех зависит от плотности аранжировки, частотного диапазона инструментов и того, как именно был сведен оригинальный микс на студии.
Влияние битрейта и исходного сведения
Физика звука такова, что частоты человеческого голоса часто пересекаются с частотами других инструментов. Например, в плотной рок-песне гитарный дисторшн и железо ударной установки находятся в том же диапазоне, что и вокал. Когда нейросеть пытается удалить вокал из трека с такой аранжировкой, она неизбежно «задевает» часть гитарного звука, делая минус более тусклым.
С другой стороны, акустические баллады, где голос звучит только под фортепиано или легкую гитару, чистить гораздо проще. В таких минималистичных миксах инструменты разведены по частотам, и алгоритм легко понимает, где заканчивается музыка и начинается пение. Поэтому качество исходного сведения играет решающую роль.
Как избежать звуковых артефактов и искажений
При удалении вокала из аудио часто возникают специфические звуковые артефакты. На месте вырезанных слов может остаться неприятное «бульканье», эффект подводного звучания или металлическое эхо. Полностью избежать их в сложных треках трудно, но мелкие огрехи можно замаскировать.
- Используйте эквализацию. Если минус звучит глухо, слегка поднимите высокие частоты (от 5 до 10 кГц) в любом аудиоредакторе. Это вернет треку яркость.
- Добавьте легкую реверберацию. Чтобы сгладить «бульканье» на месте удаленного голоса, наложите на инструментальную дорожку едва заметный эффект эха (Reverb). Он заполнит образовавшиеся пустоты в миксе.
- Сгенерируйте новый инструментал. Если оригинальный трек очистить не удается из-за сильных искажений, можно пойти альтернативным путем. Платформы вроде GPTunnel или Music Era2 позволяют создать полностью новую инструментальную музыку с нуля по текстовому описанию, что решает проблему грязных артефактов.
Ограничения ИИ: когда вырезать вокал из бита сложнее всего
Несмотря на стремительное развитие технологий, у машинного обучения есть свои слабые места. Честное понимание этих ограничений помогает избежать завышенных ожиданий. В некоторых музыкальных жанрах получить идеальную минусовку практически невозможно из-за специфики обработки звука.
Например, треки с агрессивным использованием автотюна или вокодера сильно сбивают алгоритмы с толку. Нейросеть начинает воспринимать синтезированный голос как музыкальный инструмент (например, как синтезатор) и оставляет его в инструментальной дорожке. В таких случаях частично убрать голос из песни онлайн получается, но полностью очистить музыку от голоса онлайн — нет.
Проблемы с бэк-вокалом и сильными эффектами
Современная поп- и электронная музыка редко обходится без пространственных эффектов. Реверберация (эхо), дилэй (повторения) и хорус размывают голос по всей стереопанораме. ИИ хорошо справляется с основным, сухим сигналом голоса, но часто путает хвосты эффектов с фоновой музыкой.
В результате, после того как вы попытаетесь удалить вокал с музыки, в минусовке может остаться призрачное эхо от слов певца. То же самое касается плотного бэк-вокала, который часто сводится очень широко и сливается с синтезаторами. Эти эффекты буквально «въедаются» в микс, и алгоритмам сложно отделить их, не повредив саму мелодию.
Почему концертные записи плохо поддаются очистке
Модели искусственного интеллекта тренируются на огромных базах студийных мультитреков, где звук записан в идеальных условиях. Концертные (лайв) выступления имеют совершенно иную акустическую картину. Шум толпы, гул стадиона, отражения звука от стен зала и свист микрофонов создают хаотичный звуковой фон.
Когда вы пытаетесь разделить голос и музыку онлайн нейросетью на концертной записи, алгоритм теряется в этом шуме. Он может принять крики зрителей за вокал или, наоборот, вырезать часть музыки, посчитав ее гулом зала. Для работы с лайвами требуются специализированные инструменты реставрации звука, а стандартные онлайн-ремуверы здесь показывают низкое качество.
Можно ли полностью убрать текст из музыки, оставив только мелодию
Многие пользователи ищут способ убрать из песни текст, подразумевая удаление именно смысловой нагрузки — слов. Однако важно понимать, как мыслит ИИ. Нейросеть не знает языков и не понимает смысла стихов. Она обучена распознавать и удалять весь спектр человеческого голоса как физического явления.
Это значит, что алгоритм удалит не только слова, но и любые другие вокальные проявления: шепот, дыхание, смех, вокализы (пение без слов, вроде «ооо» или «ааа») и хоровые распевки. Если ваша задача — убрать слова в музыке, но оставить красивый фоновый хор, стандартный ремувер с этим не справится, так как он сотрет весь вокальный диапазон целиком. В таких ситуациях на помощь приходят генеративные сервисы. Например, в Сонграйтер или Luvi можно сгенерировать новую песню, задав нужные параметры вокала и мелодии, чтобы получить трек, идеально подходящий под ваши задачи.
Дополнительные функции нейросетей для работы со звуком
Современные сервисы давно вышли за рамки простого разделения трека на вокал и инструментал. Для создания качественных каверов, ремиксов или видеороликов часто требуется комплексная обработка аудио. Разработчики интегрируют в свои платформы дополнительные ИИ-инструменты, которые заменяют базовые функции профессиональных аудиоредакторов.
Это позволяет выполнять всю работу в одном окне браузера. Вы можете не только отделить вокал от инструментала онлайн, но и сразу адаптировать полученные дорожки под свои нужды, экономя время на экспорт и импорт файлов в сторонние программы.
Изменение тональности и темпа минусовки
Оригинальная тональность песни далеко не всегда подходит диапазону голоса человека, который планирует петь под полученный минус. Встроенные питч-шифтеры (pitch shifters) на базе ИИ позволяют изменить тональность трека без искажения его скорости.
Например, если песня звучит слишком высоко, вы можете понизить минусовку на два-три полутона прямо на сайте. Алгоритмы пересчитывают аудио так, чтобы инструменты сохранили свое естественное звучание без эффекта «замедленной пленки». Также доступно изменение темпа (BPM), что полезно для диджеев, подгоняющих трек под свой сет.
Подавление фонового шума в аудио
Функция денойза (denoise) стала настоящим спасением для подкастеров, видеоблогеров и тех, кто записывает голос в домашних условиях. Нейросети отлично чистят речь от бытового шума, который неизбежно попадает на запись.
Если на вашей голосовой дорожке слышен гул кондиционера, шум системного блока компьютера или звуки улицы из открытого окна, ИИ-фильтры способны изолировать голос и полностью подавить фоновые помехи. В результате даже запись, сделанная на недорогой микрофон в неподготовленной комнате, приобретает плотное и чистое студийное звучание.
Часто задаваемые вопросы (FAQ)
Заключение
Технологии машинного обучения сделали профессиональную обработку звука доступной каждому. Сегодня, чтобы получить чистую инструментальную версию любимого трека, достаточно иметь доступ к сети и качественный исходный файл. Развитие алгоритмов позволяет минимизировать артефакты и сохранять естественное звучание инструментов даже в сложных композициях.
- Luvi — предлагает комплексный подход к созданию музыки с возможностью генерации как вокальных партий, так и чистых инструментальных треков с экспортом в профессиональные форматы.
- Melos — объединяет доступ к различным музыкальным нейросетям в едином интерфейсе, позволяя экспериментировать с разными технологиями без множественных регистраций.
- Music Labs — специализируется на точном дословном исполнении текстов и клонировании голоса для создания персонализированных вокальных композиций.
Выбор подходящего инструмента зависит от ваших творческих целей. Планируете ли вы создать уникальный ремикс, подготовить фонограмму для выступления или просто очистить запись диктофона — современные нейросети справятся с этими задачами за считанные минуты. Для какой задачи вам потребовалось отделить вокал от музыки: планируете домашнюю караоке-вечеринку, собираете уникальный диджей-сет или хотите записать собственный кавер на любимый хит?