10 нейросетей, чтобы сгенерировать вокал: обзор ИИ-инструментов
Поиск подходящего исполнителя, аренда студии звукозаписи и многочасовые сессии сведения вокальных партий традиционно требуют значительных временных и организационных ресурсов. Для создателей контента, инди-музыкантов и продюсеров рекламных роликов этап работы с голосом часто становится главным узким местом в производстве аудиоматериалов, особенно когда требуется специфический тембр или редкая манера исполнения.
Современные алгоритмы машинного обучения предлагают альтернативный подход, позволяя синтезировать реалистичное пение на основе текстового запроса или референсного аудио. В этой подборке мы собрали актуальные сервисы, которые помогают создавать вокальные дорожки с нуля, клонировать голоса и интегрировать готовые акапеллы в музыкальные проекты без необходимости привлекать живых сессионных певцов. Вы сможете подобрать подходящий генератор вокала, исходя из задач по качеству синтеза и гибкости настроек тембра.
Нейросети для вокала: ТОП-10 сервисов для создания песен
Подборка включает русскоязычные и международные платформы, которые генерируют песни с вокалом по текстовому описанию или готовым стихам.
- Luvi — русский вокал с правильными ударениями и возможность загрузки своего голоса.
- Melos — доступ к генерации музыки через универсальный агрегатор.
- Music Labs — создание поющего клона из минутной записи голоса для исполнения новых треков.
- МаркетВидео — платформа для работы с AI-контентом и музыкальными инструментами.
- Aihere — агрегатор с функциями расстановки ударений и управления произношением.
- Music Era2 — генерация персональных песен на русском языке через адаптированные модели.
- Сонграйтер — инструмент для превращения стихов в песню с ИИ-редактором рифм и ритма.
- GPTunnel — доступ к нескольким музыкальным моделям с единого баланса.
- ruGPT — автоматическое структурирование длинных текстов в куплеты и припевы.
- Chad AI — многофункциональный агрегатор для работы с аудио, видео и изображениями.
Методология формирования рейтинга ИИ-инструментов
При отборе сервисов мы опирались на функциональные возможности платформ, необходимые для профессионального и любительского создания аудиоконтента. Оценка проводилась по следующим критериям:
- Качество вокальной генерации — способность нейросети создавать естественное пение, соответствующее заданному жанру и темпу.
- Поддержка русского языка — корректность произношения, соблюдение правил ударения и отсутствие акцента в русскоязычных треках.
- Гибкость работы с текстом — наличие инструментов для вставки собственных стихов и управления структурой композиции (куплеты, припевы, бриджи).
- Персонализация — наличие функций клонирования голоса или создания уникальных голосовых моделей на основе пользовательских записей.
- Технический экспорт — поддержка форматов высокого качества (WAV) и возможность получения отдельных дорожек.
- Юридическая прозрачность — условия передачи прав на сгенерированный контент для его дальнейшего использования в блогах и рекламе.
Обзор популярных сервисов для создания песен с вокалом
1. Luvi
Luvi представляет собой комплексное решение для генерации музыки и полноценных песен с вокалом на русском языке. Система позволяет создавать треки двумя способами: через описание жанра и настроения для инструментальных композиций или с помощью специализированного инструмента «создать песню» для вокальных партий. Нейросеть отличается высокой точностью в расстановке ударений и естественностью интонаций, что делает её подходящей для озвучки Reels, YouTube-каналов и рекламных роликов. Пользователи могут работать как с короткими заставками, так и с длинными фоновыми композициями.
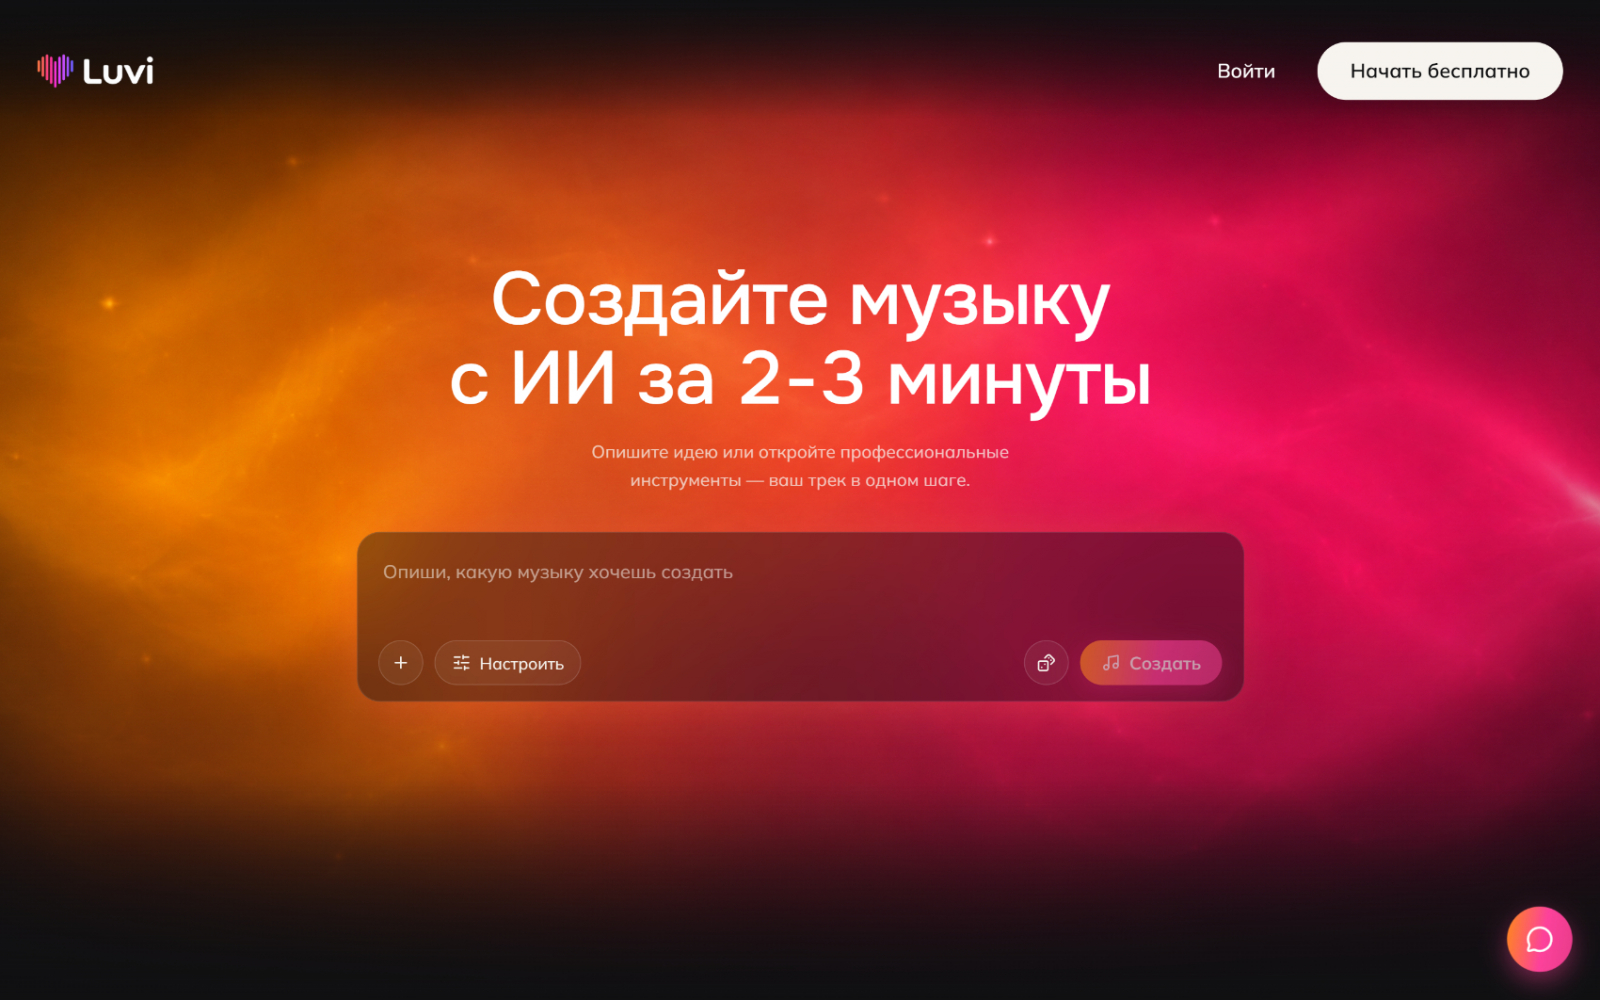
Функционал платформы включает караоке-плеер с динамической подсветкой строк и автоматическую генерацию обложек к трекам. Продвинутые возможности позволяют загружать от 15 до 30 секунд собственного вокала для создания песен своим голосом, а также использовать функцию каверов для перепевки существующих мелодий в новых стилях. Сервис поддерживает распознавание текста из аудио с автоматическим разбором структуры произведения. Экспорт готовых работ доступен в форматах MP3 и WAV, что удовлетворяет запросы как обычных пользователей, так и профессиональных контент-мейкеров.
Основные характеристики:
- Генерация песни: по текстовому описанию идеи или готовым стихам с маркерами структуры.
- Русский вокал: полная поддержка с соблюдением естественных интонаций.
- Инструментальный режим: возможность создания музыки без голоса по умолчанию.
- Жанровое разнообразие: от lo-fi и эмбиента до рока, джаза и классики.
- Работа с аудио: загрузка собственных файлов для создания каверов и перепевок.
- Персонализация: использование собственного тембра голоса для исполнения новых песен.
- Дополнительные инструменты: автогенерация обложек и распознавание текста из звуковых файлов.
- Форматы: скачивание в MP3 и WAV.
Лучше всего подходит: блогерам, SMM-специалистам и авторам, которым требуется качественный русский вокал и возможность использования собственного голоса в ИИ-генерациях.
Что учитывать: компания оставляет за собой право использовать загружаемый контент для технического улучшения работы алгоритмов сервиса.
2. Melos
Melos функционирует как агрегатор, объединяющий доступ к различным ИИ-моделям для работы с музыкой через единый интерфейс. Это избавляет пользователя от необходимости регистрироваться на множестве зарубежных площадок и позволяет решать разноплановые задачи — от создания простых мелодий до генерации сложных вокальных партий. Платформа ориентирована на быстрый результат: достаточно выбрать нужный инструмент в меню и задать параметры генерации.
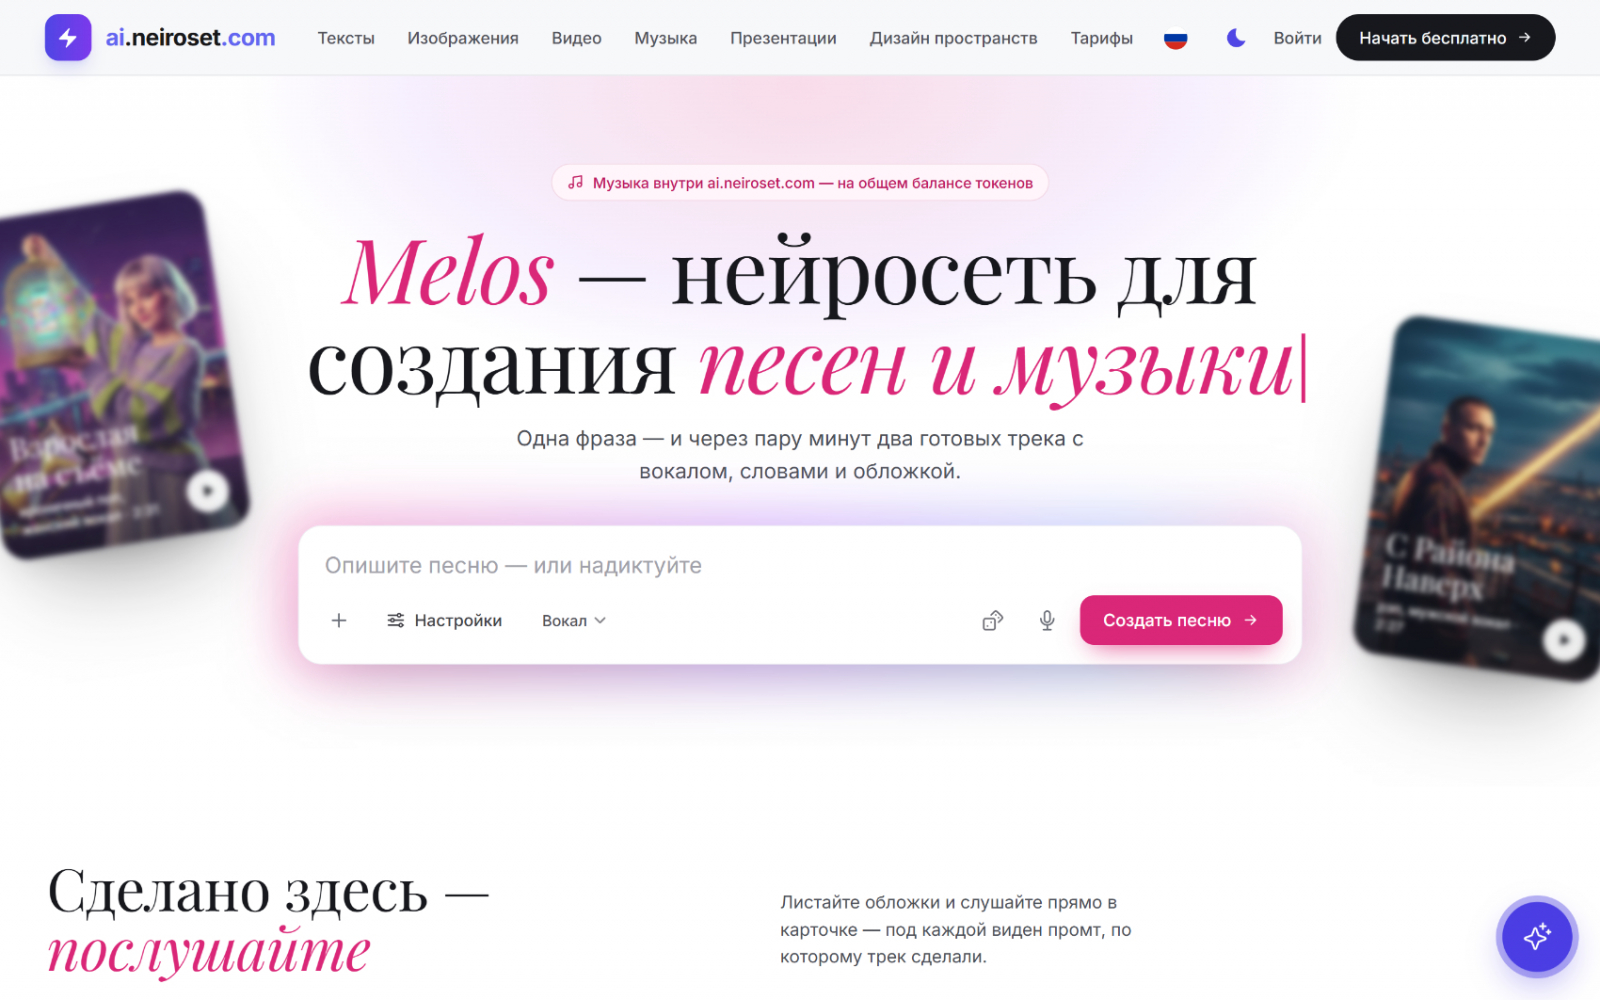
Интерфейс полностью переведен на русский язык, что упрощает настройку параметров для тех, кто не знаком с англоязычной музыкальной терминологией. Поскольку сервис является посредником между пользователем и нейросетями, набор доступных функций и качество итогового аудио зависят от выбранной внутри системы модели. Это гибкое решение для тех, кто хочет протестировать возможности разных алгоритмов в одном месте.
Основные характеристики:
- Тип сервиса: агрегатор музыкальных ИИ-моделей.
- Интерфейс: полностью на русском языке.
- Управление: единая панель для доступа к разным генераторам.
- Задачи: создание инструменталов и песен с вокалом.
Лучше всего подходит: пользователям, предпочитающим работать с разными нейросетями через одно окно без прямой регистрации в иностранных сервисах.
3. Music Labs
Music Labs специализируется на точном превращении текста в вокальные композиции. Одной из ключевых особенностей является «экспертный режим», в котором нейросеть исполняет предложенные стихи дословно, строго придерживаясь авторского текста. Сервис поддерживает более 50 языков, включая русский, обеспечивая чистое произношение без искажений. При каждой генерации система предлагает два варианта трека, что позволяет выбрать наиболее удачную аранжировку или исполнение.
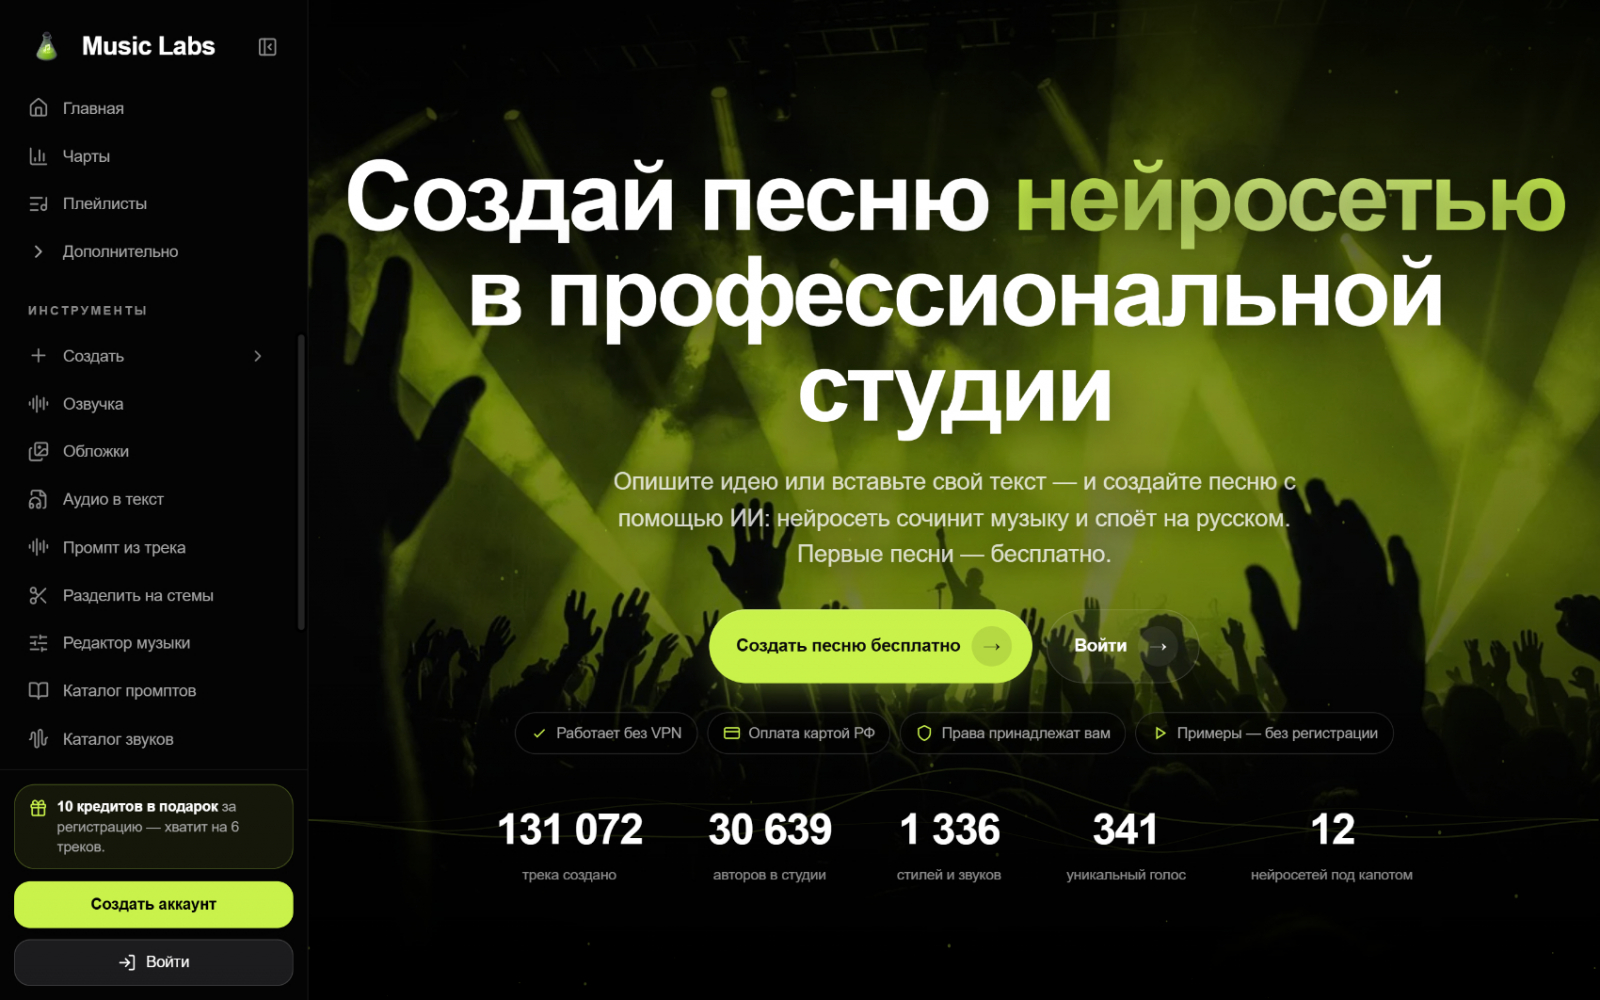
Для тех, кто хочет придать песням индивидуальность, предусмотрена функция клонирования голоса: после загрузки минутной записи вашего пения нейросеть создает цифровую модель, способную исполнять любые новые тексты вашим тембром. Платформа не претендует на исключительные права на созданный контент, передавая пользователю максимально возможный объем прав для использования треков. Результаты доступны для скачивания в форматах MP3 и WAV.
Основные характеристики:
- Режимы работы: генерация по идее или дословное исполнение готового текста.
- Клонирование голоса: создание поющего клона на основе минутной записи.
- Языковая поддержка: русский и еще 50+ мировых языков.
- Вариативность: выдача двух разных версий песни за один запрос.
- Качество звука: поддержка экспорта в несжатом формате WAV.
- Права: передача прав пользователю в максимально допустимом объеме.
Лучше всего подходит: поэтам и музыкантам, которым важно точное следование тексту и использование собственного уникального тембра в ИИ-треках.
4. МаркетВидео
МаркетВидео представляет собой многофункциональную платформу, ориентированную на создателей визуального и звукового контента. Сервис предлагает инструменты для генерации AI-видео и фото, дополненные музыкальным функционалом. Платформа адаптирована для мобильных пользователей: помимо веб-версии, доступны приложения в популярных магазинах RuStore и Google Play, что позволяет работать над проектами со смартфона.
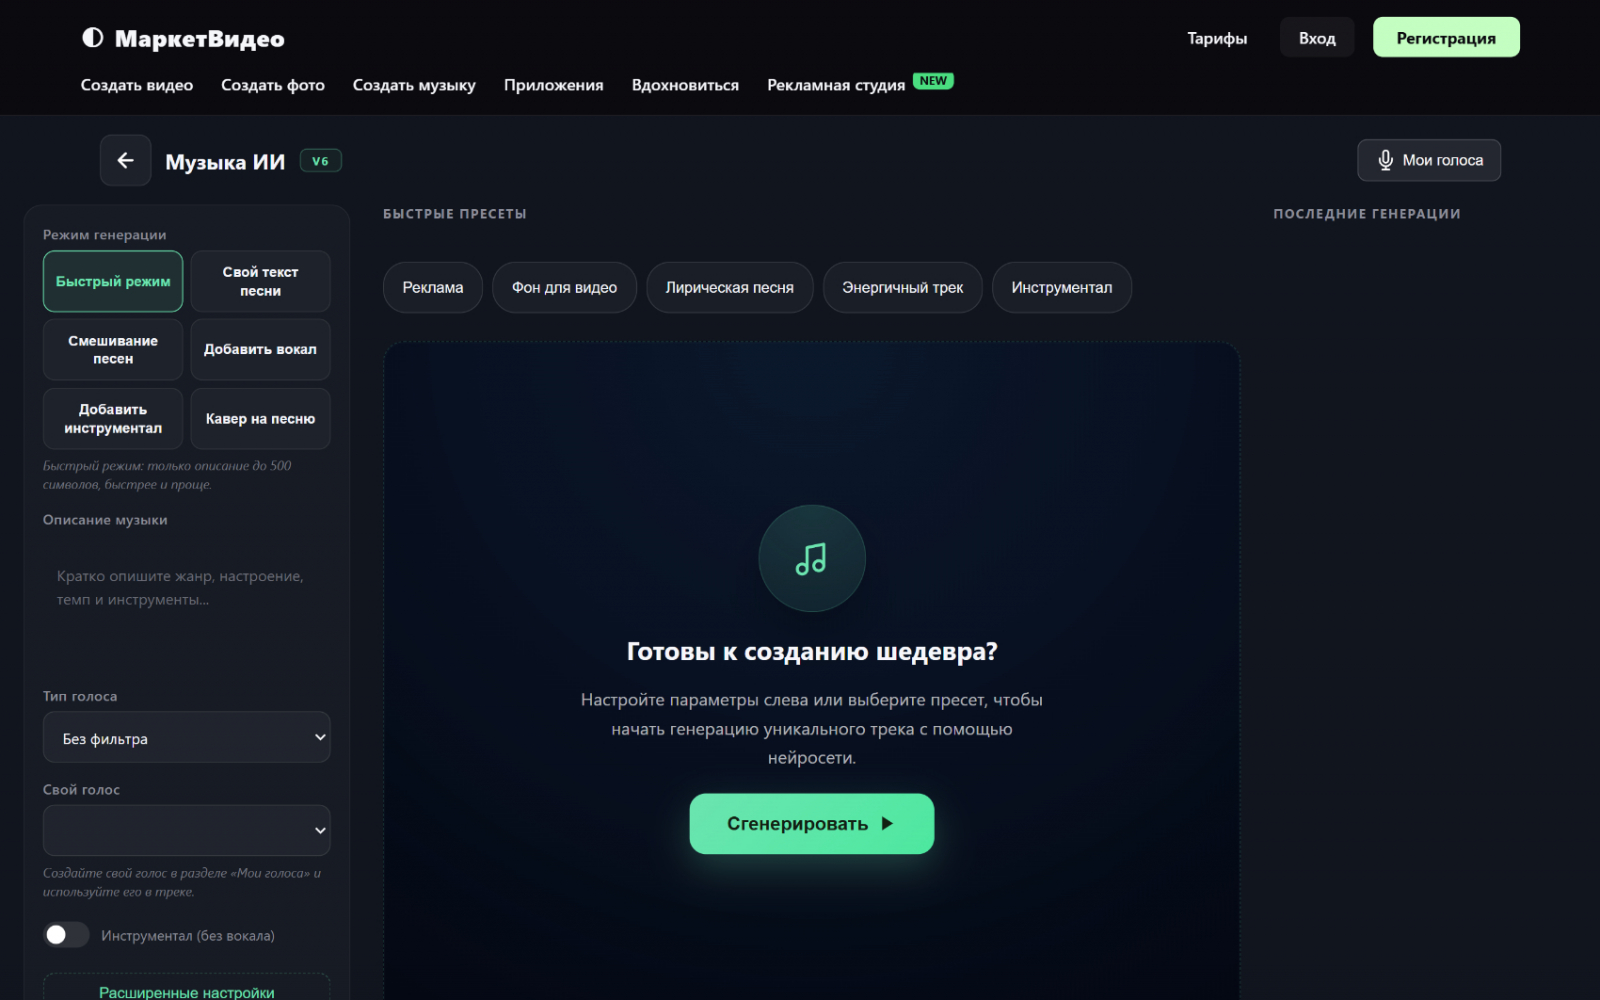
Основной упор в сервисе сделан на простоту использования через готовые шаблоны. Пользователи могут создавать уникальный контент, комбинируя визуальные эффекты с музыкальным сопровождением. Несмотря на то, что детальные технические параметры музыкального движка не афишируются, платформа позиционируется как универсальный комбайн для быстрого производства креативов для социальных сетей и бизнеса.
Основные характеристики:
- Инструментарий: генерация видео, фото и аудиоконтента.
- Доступность: наличие мобильных приложений для Android.
- Интерфейс: полностью русскоязычный.
- Удобство: работа через систему шаблонов для ускорения процесса.
Лучше всего подходит: мобильным креаторам и тем, кому нужно быстро создавать комплексный контент (видео + музыка) в одном приложении.
5. Aihere
Aihere выступает мощным посредником для доступа к передовым моделям Suno, включая последние версии V4.5 и V5.5. Главным преимуществом сервиса для русскоязычного сегмента являются встроенные инструменты для тонкой настройки вокала: функции принудительной расстановки ударений и управления разговорным произношением. Это позволяет избежать типичных для ИИ ошибок в сложных словах и добиться максимально естественного звучания русской речи в песнях.
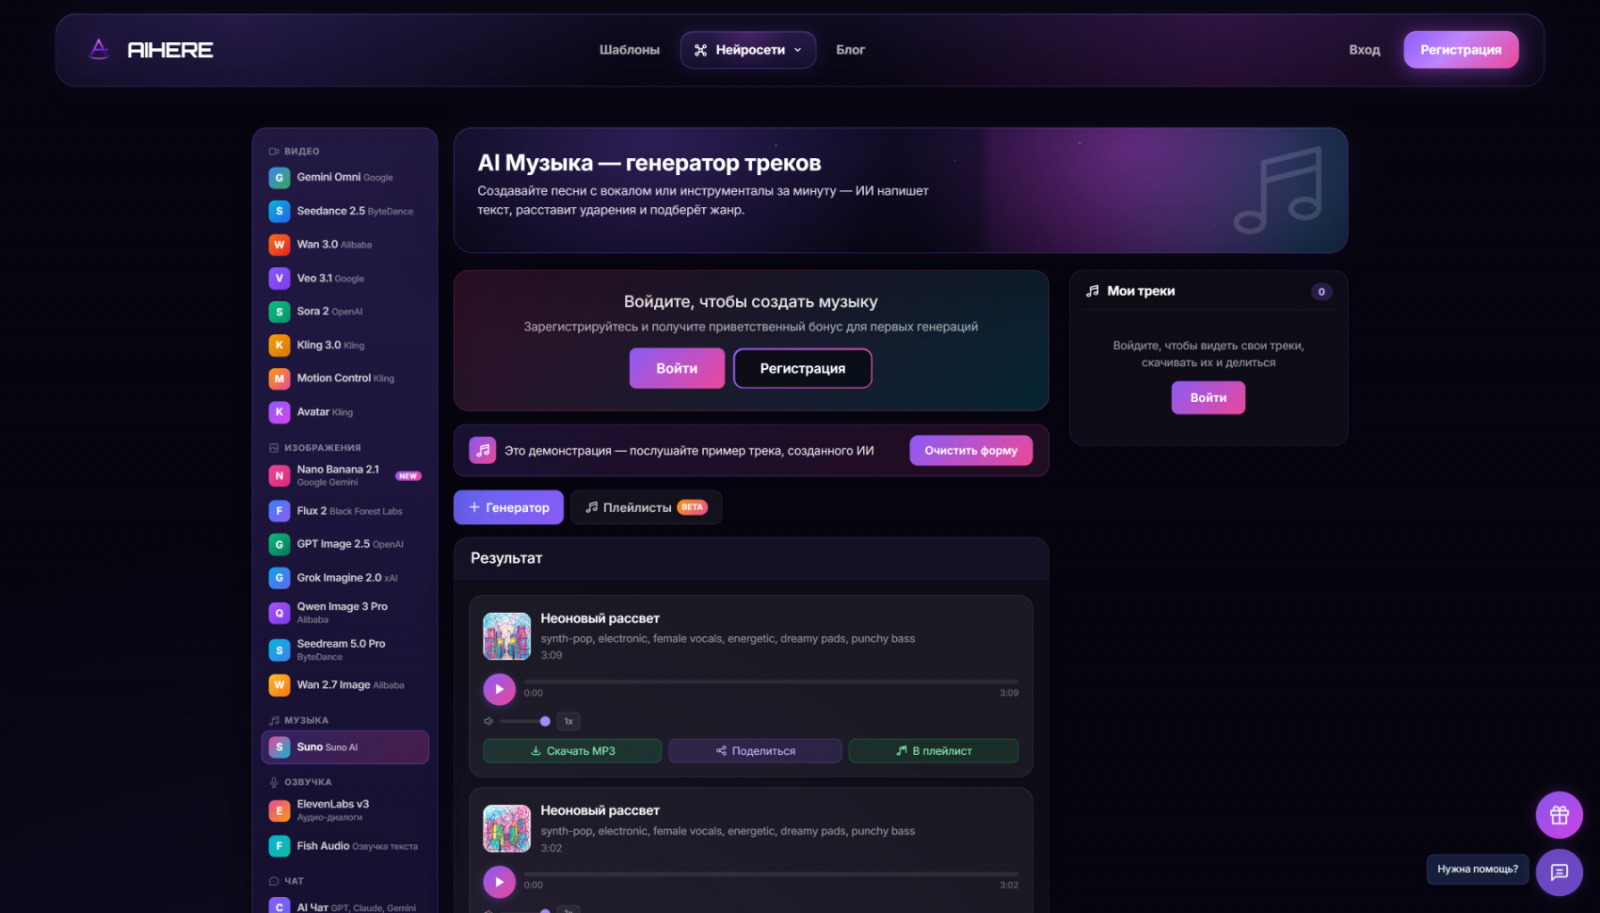
Система поддерживает управление структурой композиции через специальные теги (куплет, припев, финал) и позволяет генерировать треки длительностью до 8 минут. Пользователи могут выбирать между мужским и женским вокалом, а также задавать сложные стилистические описания объемом до 1000 символов. Платформа работает без необходимости использования дополнительных средств обхода ограничений и предлагает единую систему доступа ко всем своим инструментам, включая генераторы видео и текста.
Основные характеристики:
- Модели: доступ к актуальным версиям Suno (V4, V4.5, V5, V5.5).
- Коррекция вокала: инструменты для расстановки ударений и настройки произношения.
- Длительность: создание длинных композиций до 8 минут.
- Жанры: обширная библиотека от метала и реггетона до классики и лоу-фая.
- Структура: ручное управление частями песни через теги.
- Дополнительно: встроенный ИИ-помощник для написания текстов песен.
Лучше всего подходит: продвинутым пользователям, которым важен контроль над произношением и доступ к самым современным алгоритмам генерации.
Что учитывать: для использования контента в коммерческих целях правилами сервиса предусмотрена необходимость получения согласия администрации.
6. Music Era2
Music Era2 ориентирован на создание персональных и поздравительных композиций. Сервис базируется на модели Suno v4.5, дополненной специальным русским адаптером для улучшения качества вокала на кириллице. Платформа предлагает упрощенный процесс создания: пользователь может выбрать готовый сценарий (например, песня на свадьбу, юбилей или для Reels), вставить текст и получить два варианта исполнения. Первая генерация доступна без регистрации, что позволяет мгновенно оценить возможности нейросети.
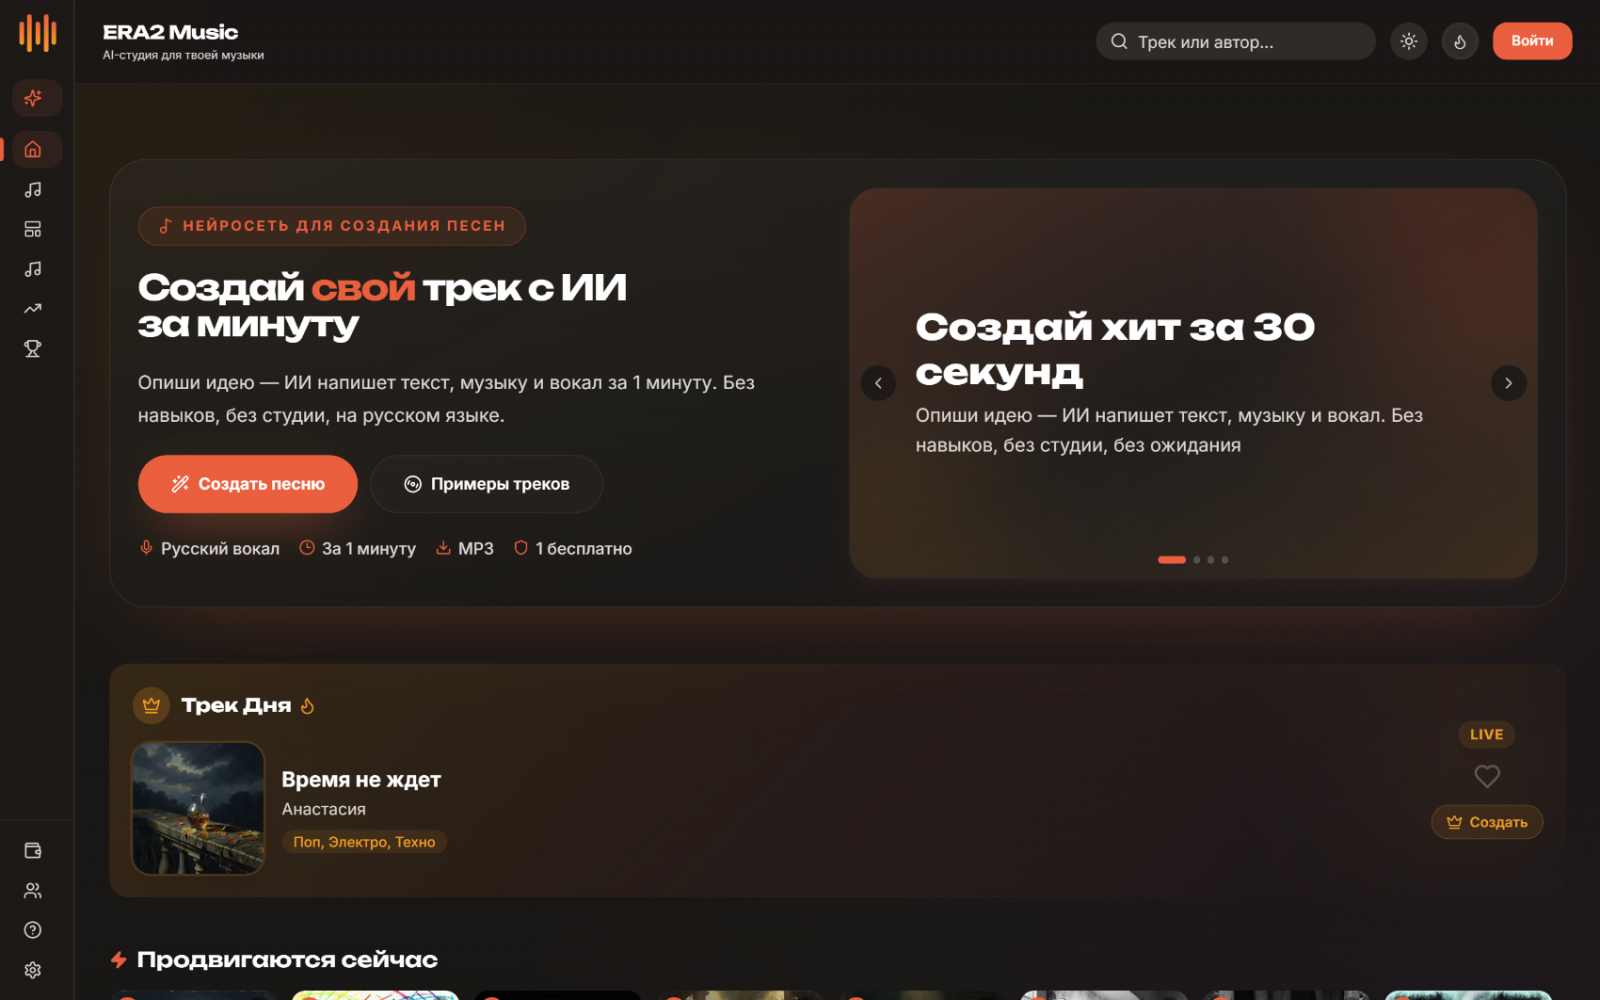
Сервис поддерживает широкий спектр современных жанров, включая фонк, дрилл и рок-баллады. Особое внимание уделено удобству публикации: готовые MP3-файлы легко отправлять в мессенджеры или использовать в личных блогах. Юридически сервис предоставляет пользователю неисключительную лицензию на использование результатов, сохраняя основные права за собой, что оптимально для частного использования и поздравлений.
Основные характеристики:
- Технология: Suno v4.5 с оптимизацией под русский язык.
- Сценарии: наличие шаблонов для праздников и семейных событий.
- Жанры: поддержка трендовых стилей (Phonk, Drill, EDM).
- Простота: быстрый старт без обязательного ввода данных карты.
- Варианты: создание двух версий трека за один цикл генерации.
Лучше всего подходит: для создания музыкальных подарков, поздравлений и оформления личного контента в соцсетях.
Что учитывать: коммерческое использование результатов генерации без письменного разрешения правообладателя ограничено условиями соглашения.
7. Сонграйтер
Сонграйтер — это специализированный инструмент для поэтов и авторов текстов. Его отличительной чертой является встроенный интеллектуальный редактор, который анализирует загруженные стихи и помогает корректировать рифмы, ритмический рисунок и структуру припевов перед началом генерации. Нейросеть использует модель, специально обученную учитывать особенности русского языка: падежи, стихотворные размеры и правильные ударения, что минимизирует «роботизированность» вокала.
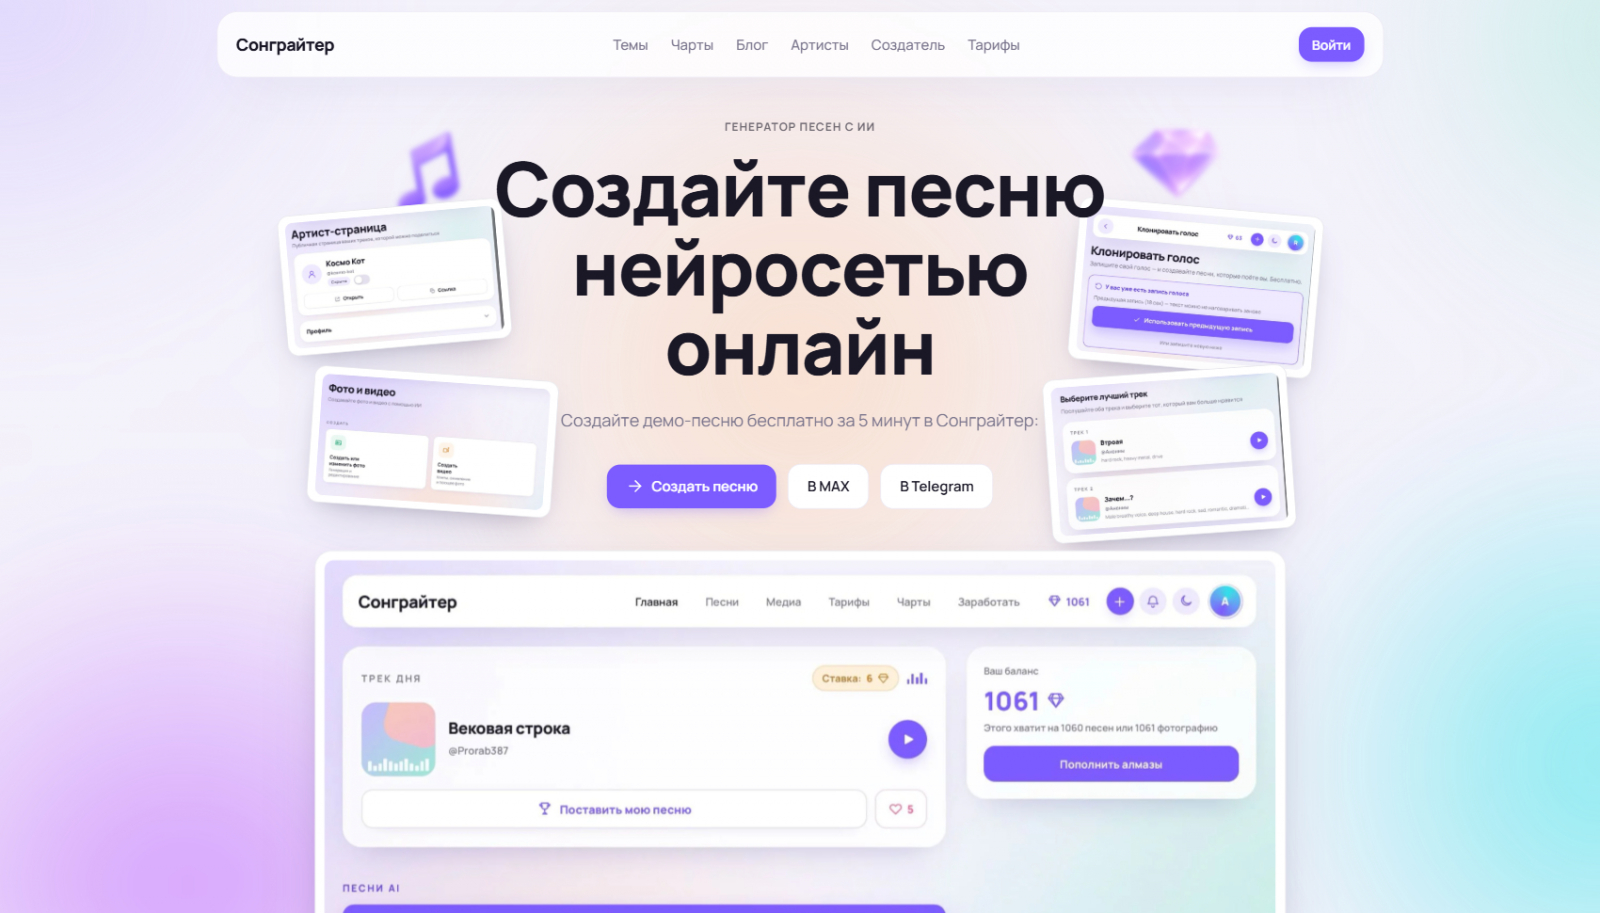
Помимо работы с текстом, сервис предлагает функцию создания «голосовой персоны». Записав короткий фрагмент своего голоса, пользователь может заставить нейросеть петь его тембром в любых жанрах. Платформа предоставляет полные права на сгенерированные аудиофайлы, видео-караоке и обложки, разрешая их коммерческое использование, продажу и публикацию на любых площадках без ограничений. Экспорт возможен в форматах MP3, WAV и MP4 (для видео).
Основные характеристики:
- Редактор текста: ИИ-помощник для доработки рифм и ритма стихов.
- Русская модель: глубокая адаптация под правила русского языка и стихосложения.
- Клонирование: создание уникальной голосовой персоны для вокала.
- Видео: генерация караоке-роликов в формате MP4.
- Права: полное владение результатом с разрешением на коммерцию.
- Качество: доступ к профессиональному формату WAV.
Лучше всего подходит: авторам песен, которым нужен надежный инструмент для превращения стихов в качественные демо-записи или готовые треки с полными правами.
8. GPTunnel
GPTunnel представляет собой агрегатор, который дает возможность работать с топовыми музыкальными нейросетями Suno, Mureka и MiniMax в рамках одного интерфейса. Это удобно для тех, кто хочет сравнивать результаты разных алгоритмов, не переключаясь между вкладками и не оплачивая несколько разных подписок. Сервис поддерживает расширенный режим настройки, где можно детально прописать текст песни и выбрать инструментальный режим для создания минусовок.
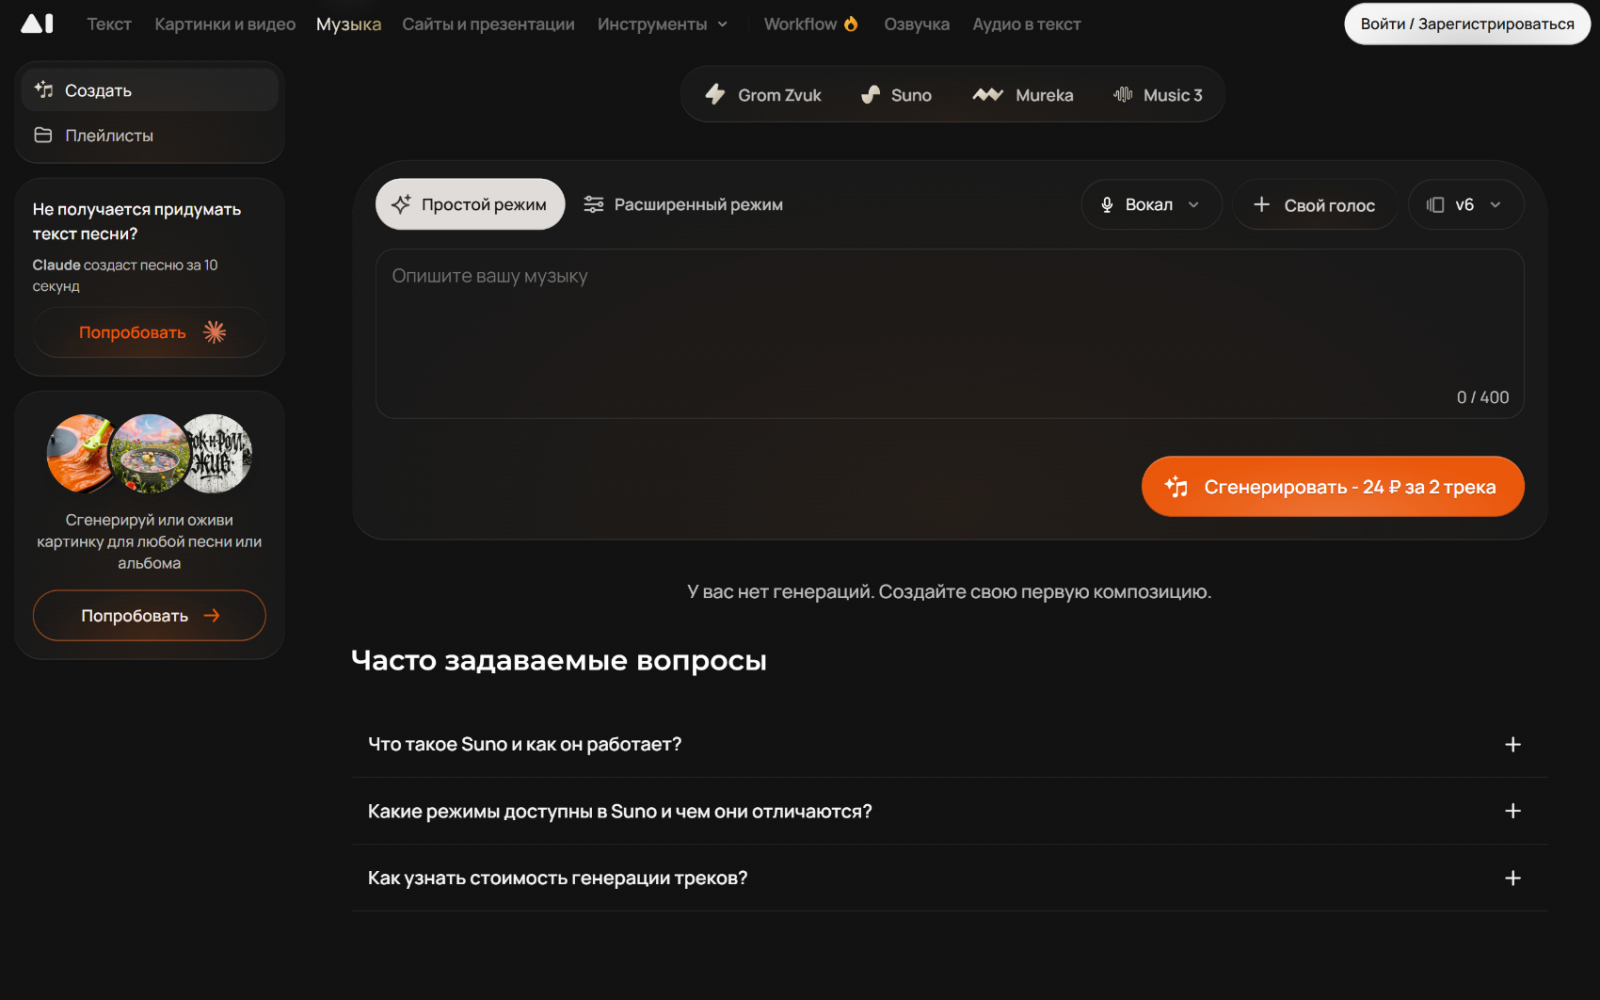
Платформа работает по системе списания за фактические действия, что позволяет гибко управлять ресурсами. Интерфейс полностью на русском языке, а для модели Suno доступна актуальная версия V5.5. При каждом запросе система генерирует два варианта композиции, предоставляя выбор между различными аранжировками одного и того же текста.
Основные характеристики:
- Мультимодельность: доступ к Suno, Mureka и MiniMax.
- Единый интерфейс: управление всеми генерациями из одного кабинета.
- Инструментал: отдельный режим для создания музыки без вокала.
- Гибкость: отсутствие обязательных ежемесячных подписок.
Лучше всего подходит: пользователям, которые хотят иметь доступ к разным ИИ-технологиям генерации музыки в одном месте.
9. ruGPT
ruGPT предлагает автоматизированный подход к созданию песен на базе технологий Suno. Главное преимущество сервиса — интеллектуальное структурирование: пользователю достаточно вставить сплошной текст (стихотворение, рассказ или поздравление), а нейросеть самостоятельно разделит его на логические блоки, выделит припевы и подберет подходящий ритм. Это избавляет от необходимости вручную расставлять технические маркеры в тексте.
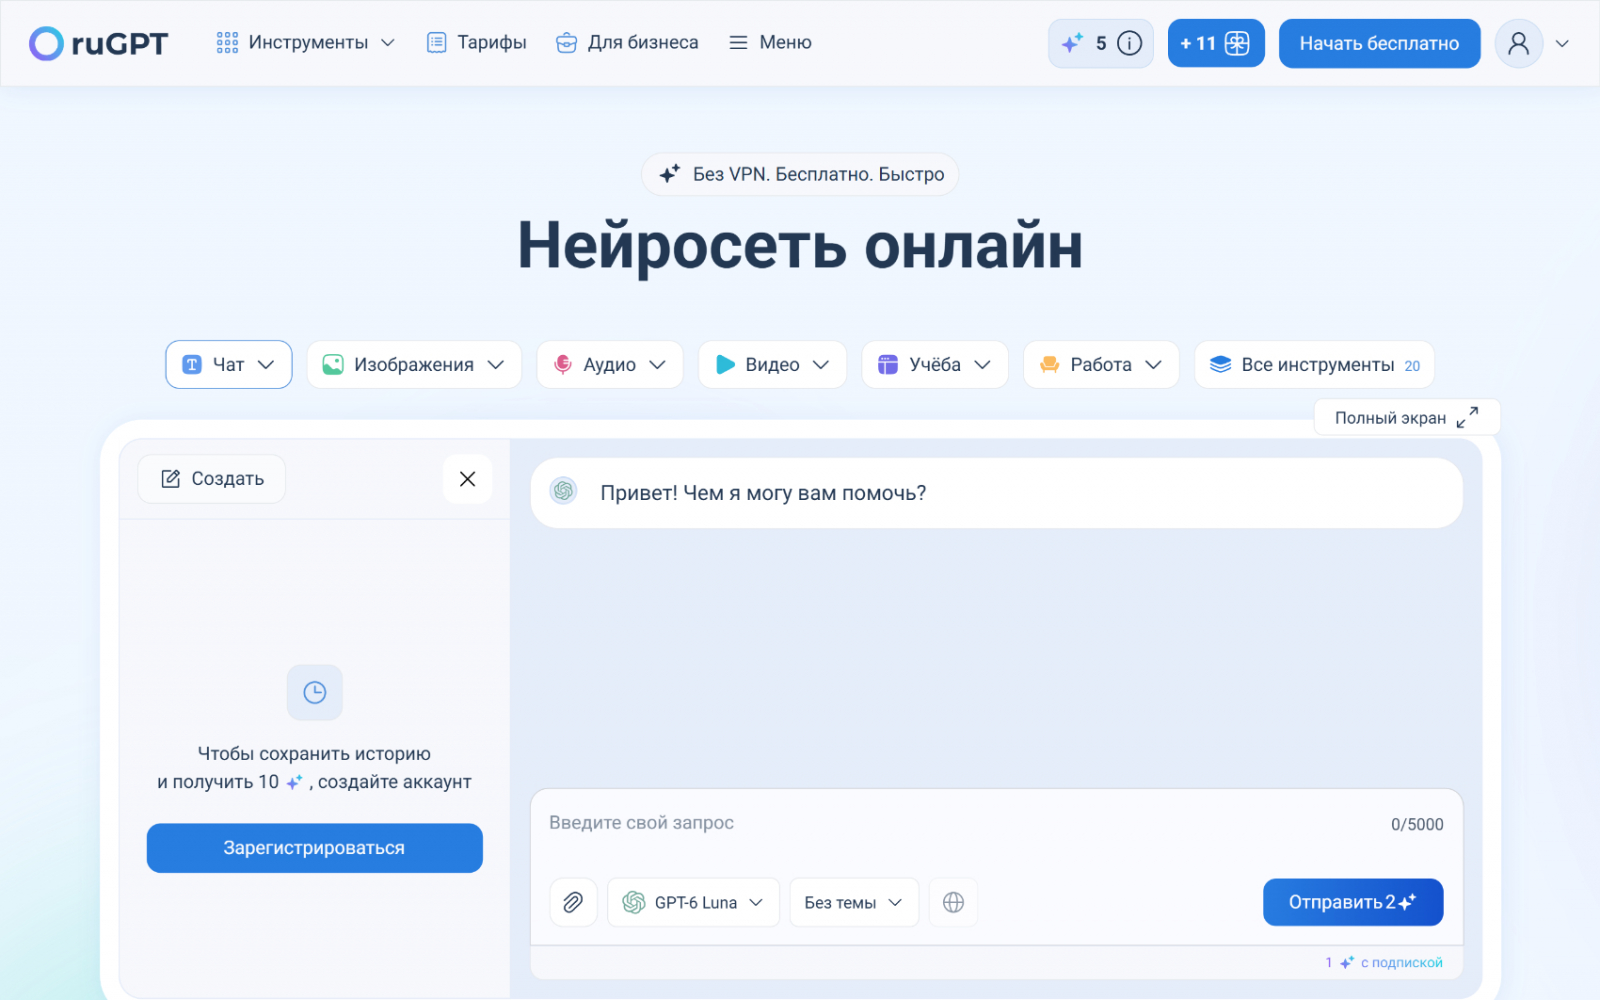
Платформа поддерживает длинные текстовые задания и позволяет выбирать стиль и тип вокала. Сгенерированные треки можно использовать в коммерческих проектах, включая видео для соцсетей и рекламу. Интерфейс сервиса максимально упрощен, что делает его доступным для людей, не имеющих опыта работы с музыкальными редакторами или сложными ИИ-промптами.
Основные характеристики:
- Автоструктура: самостоятельное разделение текста на куплеты и припевы.
- Длинные тексты: возможность загрузки объемных литературных произведений.
- Коммерция: официальное разрешение на использование треков в бизнесе и блогах.
- Простота: минималистичный интерфейс на русском языке.
Лучше всего подходит: тем, кто хочет быстро превратить готовый текст в песню без ручной разметки и сложных настроек.
10. Chad AI
Chad AI — это универсальный ИИ-ассистент, который, помимо работы с текстами и изображениями, предоставляет инструменты для генерации аудио и видео. В музыкальном плане сервис выступает как агрегатор, позволяя пользователям создавать звуковое сопровождение для своих проектов. Платформа поддерживает работу с референсами: можно загрузить до четырех примеров, чтобы направить нейросеть в нужное стилистическое русло.
Хотя основным фокусом Chad AI является визуальный контент и работа с изображениями (включая редактирование внешности и смену фона), наличие аудиомоделей делает его удобным инструментом для комплексных задач. Например, здесь можно в одном окне написать текст песни, сгенерировать для нее вокал и создать обложку или короткий видеоряд. Система работает быстро, выдавая результаты в течение нескольких секунд.
Основные характеристики:
- Многозадачность: генерация аудио, видео, текста и фото.
- Работа с референсами: использование до 4 исходных файлов для настройки стиля.
- Скорость: быстрая обработка запросов (от 3 секунд).
- Модели: доступ к широкому списку ИИ-алгоритмов (Midjourney, Flux и др.).
Лучше всего подходит: пользователям, которым нужен единый инструмент для создания всех типов контента (текст + звук + визуал) одновременно.
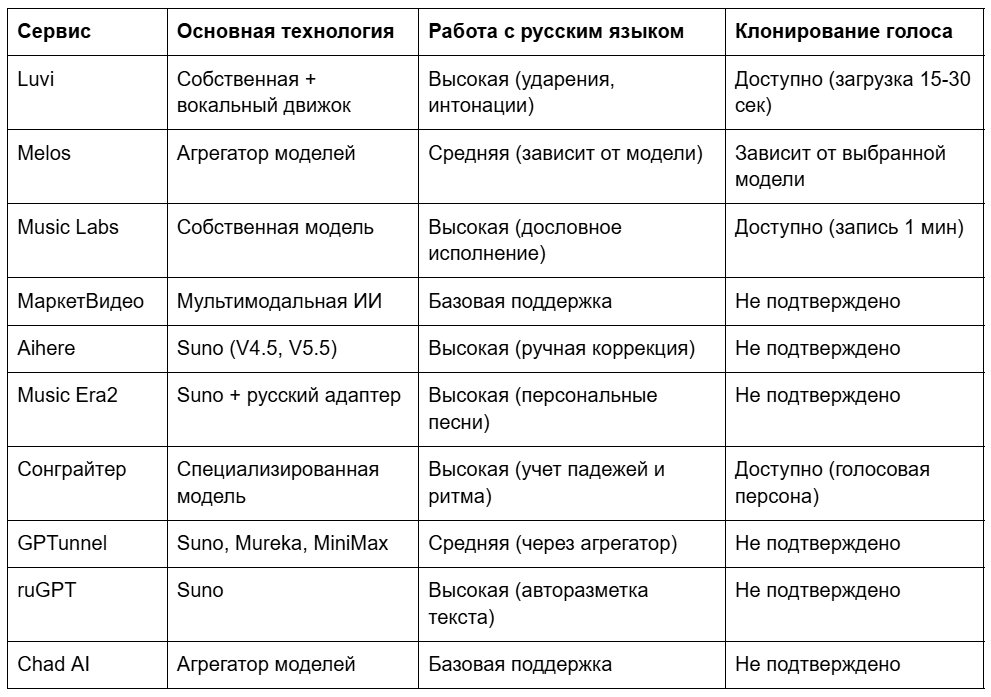
Сравнение возможностей нейросетей для вокала
Как выбрать подходящую нейросеть
Выбор инструмента зависит от ваших целей и глубины работы с музыкальным материалом:
- Для профессиональной работы со стихами: Обратите внимание на Music Labs или Сонграйтер. Эти сервисы лучше всего справляются с дословным исполнением текста и позволяют корректировать ритмику, что критично для поэтов.
- Для создания песен своим голосом: Лидерами здесь являются Luvi и Music Labs. Они позволяют создать цифровую копию вашего тембра, чтобы ИИ пел именно за вас.
- Для быстрого доступа к мировым технологиям: Используйте Melos, Aihere или GPTunnel. Это удобные «входные ворота» к моделям Suno и MiniMax с русскоязычным интерфейсом.
- Для подарков и поздравлений: Идеально подойдет Music Era2 благодаря наличию готовых сценариев для праздников и свадеб.
- Для автоматизации контента: ruGPT станет лучшим выбором, если у вас есть длинный текст, который нужно превратить в песню без ручной расстановки куплетов и припевов.
Как создать музыку с голосом: пошаговый процесс работы с ИИ
Перенос музыкальной идеи из головы в готовый аудиофайл требует четкого понимания того, как алгоритмы обрабатывают запросы. Современный ai генератор голоса работает не просто как синтезатор речи, а как виртуальный вокалист, которому нужны правильные инструкции по ритму, стилю и подаче. Чтобы создать музыку нейросеть с голосом бесплатно или в рамках базовых лимитов платформ, важно соблюдать последовательность действий.
Базовый алгоритм генерации с нуля включает несколько этапов:
- Формирование концепции. Определение жанра, темпа и настроения будущего трека.
- Написание и разметка текста. Подготовка лирики с указанием структурных частей (куплет, припев, бридж).
- Выбор платформы и модели. Использование сервисов вроде Сонграйтер или Music Labs для подбора нужного тембра.
- Генерация и отбор. Создание нескольких вариантов и выбор наиболее удачного дубля.
- Постобработка. Скачивание результата и, при необходимости, доработка в аудиоредакторе.
Каждый из этих шагов напрямую влияет на итоговое качество синтезированного голоса. Пропуск этапа разметки или неточный выбор жанровых тегов часто приводит к тому, что вокал звучит неестественно или не попадает в ритм.
Подготовка текста и выбор подходящего тембра
Текстовый исходник — это фундамент, на котором строится создание вокала нейросетью. Алгоритмы лучше справляются с задачей, когда понимают структуру песни. Если загрузить сплошной текст без абзацев, нейросеть может спеть его монотонно, не выделяя кульминацию.
Для правильной разметки используйте квадратные скобки. Теги [Verse] (куплет) и [Chorus] (припев) подсказывают искусственному интеллекту, где нужно изменить динамику. Если стоит задача сгенерировать голос девушки для энергичной поп-песни, припев должен звучать ярче и громче куплета. Некоторые платформы, такие как ruGPT, умеют автоматически структурировать длинные тексты, разбивая их на логические музыкальные фрагменты, что значительно экономит время.
Особое внимание стоит уделить фонетике. Если ии для создания вокала ставит неправильные ударения в сложных словах, используйте заглавные буквы для ударных гласных или прописывайте слова фонетически. Правильно расставленные запятые и точки заставят виртуального исполнителя делать естественные паузы для вдоха.
Настройка интонации и эмоциональной окраски
Монотонное исполнение — главная проблема ранних систем синтеза. Чтобы сгенерировать вокал, который будет звучать как живой человек, необходимо управлять эмоциональной динамикой. Современные инструменты для синтеза пения позволяют задавать настроение через текстовые подсказки или специальные ползунки в интерфейсе.
Добавление в промпт таких слов, как passionate (страстно), whisper (шепот) или belting (пение на опоре), кардинально меняет подачу. Например, при работе в Luvi точное описание настроения помогает алгоритму подобрать правильную артикуляцию. Тонкая настройка тембра и интонации оживляет партию: легкое вибрато на длинных нотах или слышимое дыхание перед сложной фразой стирают границу между машинным и человеческим исполнением.
ИИ для редактирования голоса и обработки готовых партий
Нейросети полезны не только на этапе создания контента с нуля. Ии для редактирования голоса становится незаменимым помощником на стадии сведения, когда нужно исправить огрехи исполнения нейросетью или живым вокалистом. Традиционный процесс выравнивания нот (питч-коррекция) и ритма требует глубоких знаний звукорежиссуры и часов кропотливой работы.
Умные алгоритмы анализируют аудиофайл целиком, определяя тональность и темп проекта. Они способны автоматически подтянуть фальшивые ноты до ближайших правильных значений в заданном звукоряде, сохраняя при этом естественные микротональные колебания голоса. Это позволяет получить коммерческое звучание без эффекта «роботизации», характерного для жесткого автотюна.
Удаление фонового шума из записи
Чистая вокальная дорожка критически важна для качественного микса. Домашние записи часто испорчены гулом компьютера, шумом кондиционера или отражениями звука от неподготовленных стен (реверберацией комнаты). Классические эквалайзеры и гейты при попытке вырезать эти помехи неизбежно повреждают полезные частоты самого голоса.
Нейросетевые денойзеры работают иначе. Они обучены отличать паттерны человеческой речи и пения от любых других звуков. При обработке алгоритм изолирует вокал и буквально перерисовывает поврежденные участки спектра, полностью удаляя фоновый шум из записи. В результате даже акапелла, записанная на микрофон смартфона в гулком помещении, может звучать так, будто была сделана в студийной кабине.
Автоматическое сведение и наложение на бит
Интеграция голоса в инструментальный микс — финальный и часто самый сложный этап. Вокал должен звучать внутри музыки, пробиваясь сквозь плотные партии синтезаторов и ударных, а не лежать поверх них инородным слоем. Чтобы добавить голос на музыку онлайн и получить цельный трек, требуется грамотная эквализация и компрессия.
Сервисы автоматического мастеринга анализируют частотный конфликт между инструментами и голосом. Алгоритм самостоятельно приглушает те частоты в минусовке, которые мешают вокалу читаться, и применяет динамическую компрессию для выравнивания громкости. Такое автоматическое сведение вокала экономит часы ручной работы и позволяет создателям контента быстро получать готовые треки прямо в браузере.
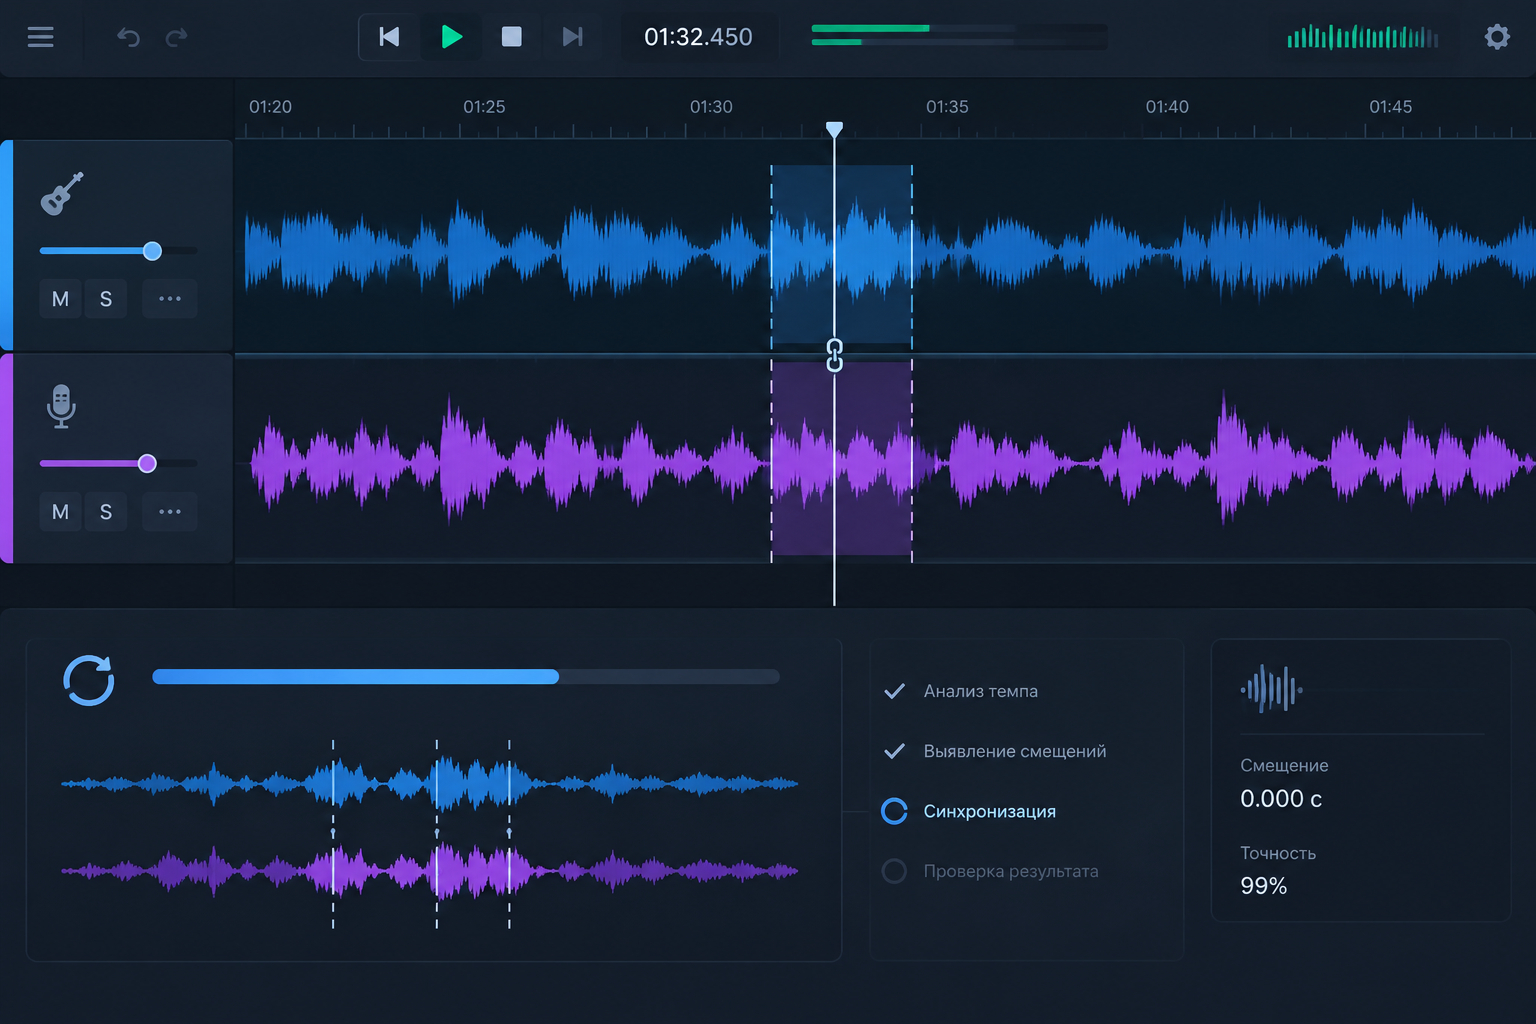
Нейросеть для отделения вокала от музыки: изоляция акапеллы
Извлечение чистого голоса из сведенной композиции долгое время считалось невыполнимой задачей, сродни попытке достать яйцо из испеченного пирога. Однако современная нейросеть для отделения вокала от музыки (стем-сепарация) успешно решает эту проблему. Технология востребована среди диджеев, битмейкеров и авторов ремиксов, которым нужны оригинальные акапеллы для новых аранжировок.
Алгоритмы машинного обучения, натренированные на миллионах мультитреков, умеют распознавать спектральные отпечатки различных инструментов. Нейросеть которая отделяет вокал от музыки, сканирует аудиофайл и разделяет его на независимые слои (стемы): голос, ударные, бас и остальные инструменты. Современные модели справляются с этой задачей практически без цифровых артефактов, сохраняя оригинальный тембр и эффекты.
Как разделить трек на голос и инструменты без потери качества
Качество полученной акапеллы напрямую зависит от исходного файла и правильного подхода к процессу сепарации. Если загрузить пережатый MP3 с низким битрейтом, нейросеть для отделения голоса от музыки выдаст результат с булькающими звуками и искажениями.
Чтобы минимизировать потери, следуйте простому алгоритму:
- Используйте форматы без потерь. Перед загрузкой в сервис всегда выбирайте исходники в форматах WAV или FLAC.
- Избегайте клиппинга. Убедитесь, что исходный трек не перегружен по громкости, иначе алгоритму будет сложно разделить слипшиеся частоты.
- Выбирайте профильные модели. Используйте сервисы, специализирующиеся именно на стем-сепарации, а не универсальные аудиоредакторы.
- Проверяйте артефакты в соло. После разделения прослушайте вокальную дорожку отдельно, чтобы убедиться в отсутствии остатков ударных (блидов).
Создание каверов и преобразование текста в вокал
В сфере ИИ-музыки существуют два принципиально разных подхода: Text-to-Vocal (генерация по тексту) и Voice-to-Voice (клонирование и перенос голоса). Преобразование текста в вокал отлично подходит для создания оригинальных демо-записей. Вы пишете стихи, задаете жанр, и нейросеть с нуля придумывает мелодию и исполняет ее. Это быстрый способ получить готовый результат без навыков пения.
Технология Voice-to-Voice работает иначе и используется, чтобы создать кавер с помощью ии или заменить вокалиста в готовом треке. В этом случае требуется референсное аудио — чистая запись пения (можно спеть самостоятельно, даже не попадая в ноты). Пользователь решает прогнать голос через нейросеть, которая накладывает на исходник новый тембр, полностью сохраняя оригинальную ритмику, дыхание и мелизмы. Платформы вроде Music Labs и Сонграйтер позволяют загрузить короткую запись собственного голоса, создать персональную голосовую модель и использовать ее для исполнения любых новых песен.
Промпты для генератора вокала: примеры и структура запросов
Точность текстового запроса (промпта) определяет, насколько результат будет соответствовать вашей задумке. Генератор вокала нейросеть воспринимает не как абстрактные пожелания, а как набор конкретных тегов. Если написать просто «красивая песня о любви», алгоритм выберет усредненные параметры, что часто приводит к банальному звучанию.
Эффективный промпт для сервисов, работающих на базе продвинутых моделей (например, через GPTunnel или Music Era2), должен иметь четкую структуру: [Жанр и поджанр] + [Темп/Ритм] + [Характер вокала] + [Настроение/Атмосфера] + [Ведущие инструменты]. Использование англоязычных тегов часто дает более предсказуемый результат, так как большинство моделей обучались на западных музыкальных базах.
Шаблоны описаний для различных музыкальных жанров
Чтобы сгенерировать вокал онлайн с нужным характером, полезно иметь под рукой проверенные комбинации тегов. Эксперименты с описаниями помогают найти уникальное звучание и избежать шаблонных мелодий.
Часто задаваемые вопросы (FAQ)
Заключение
Внедрение нейросетей в процесс музыкального продакшена фундаментально меняет подход к работе со звуком, автоматизируя рутинные задачи по сведению и открывая доступ к безграничной библиотеке виртуальных голосов. Выбор конкретного инструмента зависит от ваших целей: для быстрых джинглов подойдут сервисы формата «текст-в-песню», тогда как для профессиональных ремиксов и каверов потребуются продвинутые алгоритмы стем-сепарации и точечного клонирования тембра.
- Luvi — обеспечивает высокую детализацию вокальных партий с правильными ударениями и предлагает интуитивно понятный интерфейс для создания полноценных песен на русском языке с возможностью использования собственного голоса.
- Melos — выделяется гибкостью доступа к различным музыкальным моделям через единый агрегатор, позволяя экспериментировать с разными алгоритмами генерации без множественных регистраций.
- Music Labs — универсальный инструмент с функцией дословного исполнения текстов и клонирования голоса, который эффективно справляется как с генерацией новых тембров, так и с обработкой готового аудиоматериала.
Использование этих инструментов позволяет значительно сократить производственный цикл в аудиовизуальных проектах. Несмотря на то, что ИИ пока не может полностью заменить уникальную харизму живого артиста, он становится незаменимым помощником для быстрого прототипирования и создания качественного контента в условиях ограниченного времени и бюджета.