Три образа на эскалаторе: как создать ИИ-видео с переодеванием
Одно видео, один герой и сразу три разных наряда. В пресете «Три образа на эскалаторе» одежда меняется прямо во время поездки, а для генерации нужны фото человека и три референса образов.
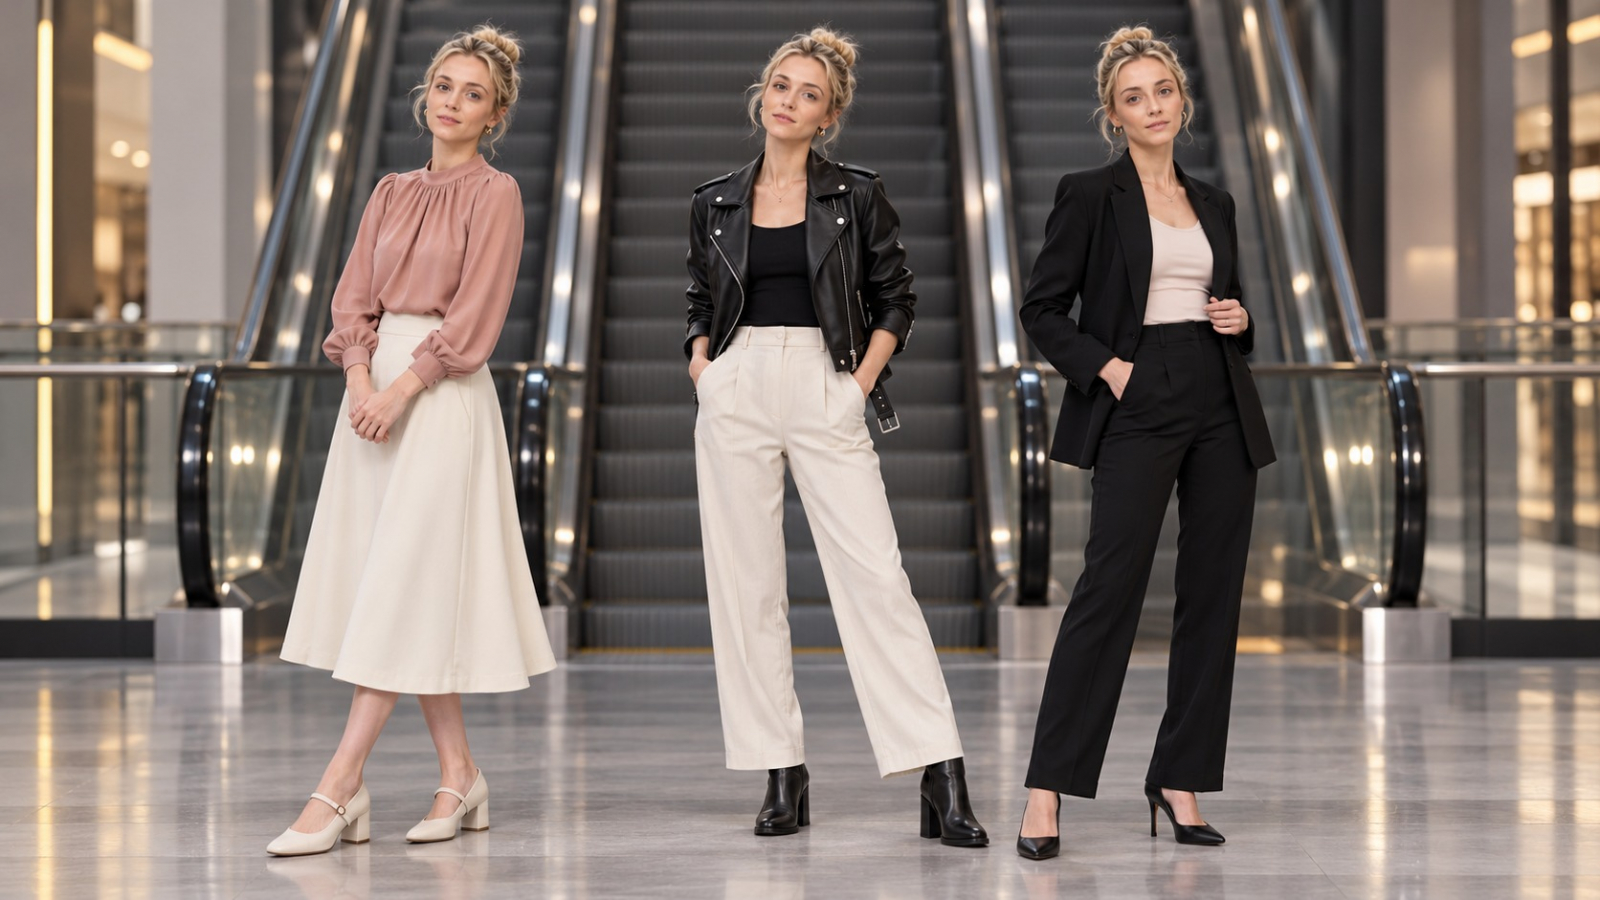
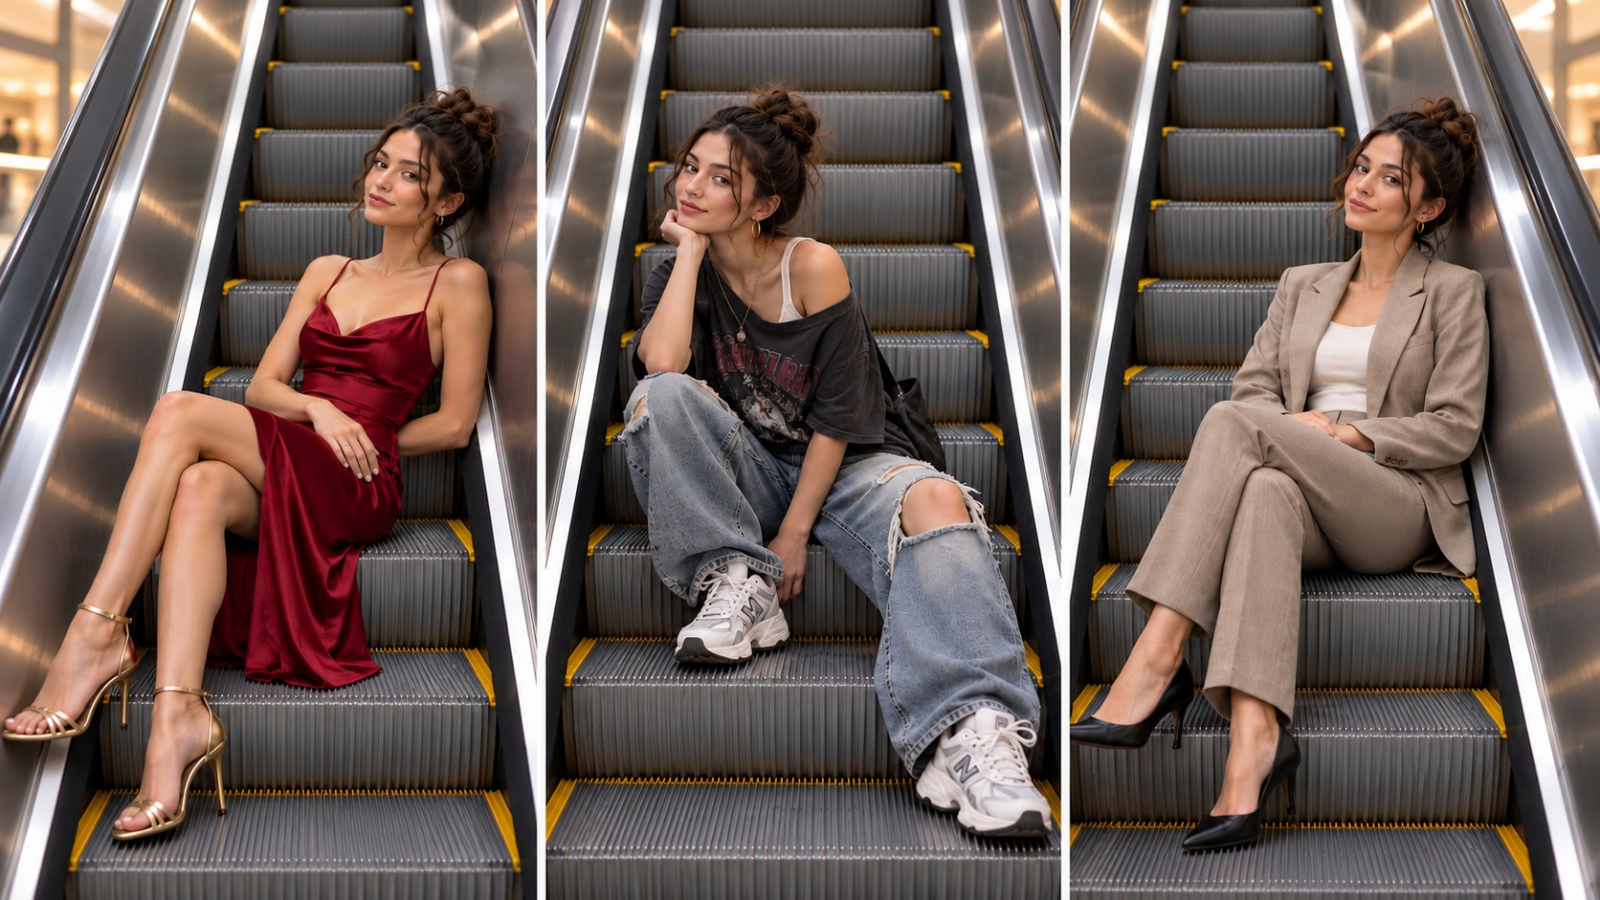
Человек едет на эскалаторе, камера удерживает его в центре кадра. Через несколько секунд одежда меняется, затем появляется второй образ, а после него третий.
Сам герой и движение по эскалатору остаются общими для всей сцены. За счёт этого смена одежды выглядит как последовательное fashion-переодевание внутри одного ролика, а не как три отдельных генерации.
В SpeShu.AI для этого есть готовый пресет «Три образа на эскалаторе». Пользователь загружает свою фотографию и три изображения одежды, а Bytedance Seedance 2 собирает из них 14-секундное вертикальное видео.
Что за пресет «Три образа на эскалаторе»
«Три образа на эскалаторе» относится к категории «Ворваться в тренды». Его идея строится вокруг одной сцены: герой продолжает ехать на эскалаторе, пока его одежда несколько раз меняется.
Вместо трёх отдельных роликов здесь получается одна последовательность. Зритель видит одного и того же человека в одном пространстве, но каждый следующий фрагмент показывает новый наряд.
Для генерации используются четыре исходных изображения. Первое — фотография человека. Ещё три — референсы одежды, которые должны появиться на герое по ходу видео.
Важно, что на изображениях с одеждой не нужны другие люди. Это именно референсы нарядов, а не дополнительные персонажи сцены.
Как создать ИИ-видео с тремя образами на эскалаторе
Сценарий уже настроен внутри пресета, поэтому самостоятельно описывать движение эскалатора, смену одежды и последовательность образов не требуется.
Нужно подготовить фотографию человека и три подходящих референса одежды.
Шаг 1. Открыть пресет
Откройте готовый пресет из категории «Ворваться в тренды». Для создания ролика используется Bytedance Seedance 2.
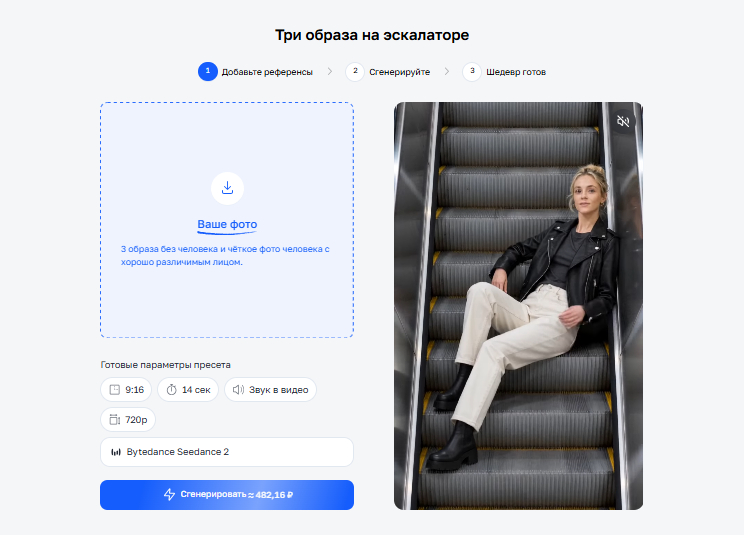
Отдельно выбирать модель или переносить сценарий в другой генератор не нужно.
Шаг 2. Выбрать фотографию человека
Для первого изображения понадобится фото героя будущего ролика. Лучше взять чёткий снимок, где хорошо видны лицо и фигура.
Старайтесь избегать сильного размытия, пересветов и тяжёлых фильтров. Чем понятнее исходный человек, тем проще оценить его сохранение при смене образов.
Шаг 3. Подготовить три референса одежды
Дальше понадобятся три отдельных изображения с нарядами. Именно они задают последовательность образов в видео.
Лучше выбирать референсы, на которых хорошо видны основные детали одежды. На этих изображениях не должно быть людей: пресету нужны именно наряды, которые будут перенесены на героя.
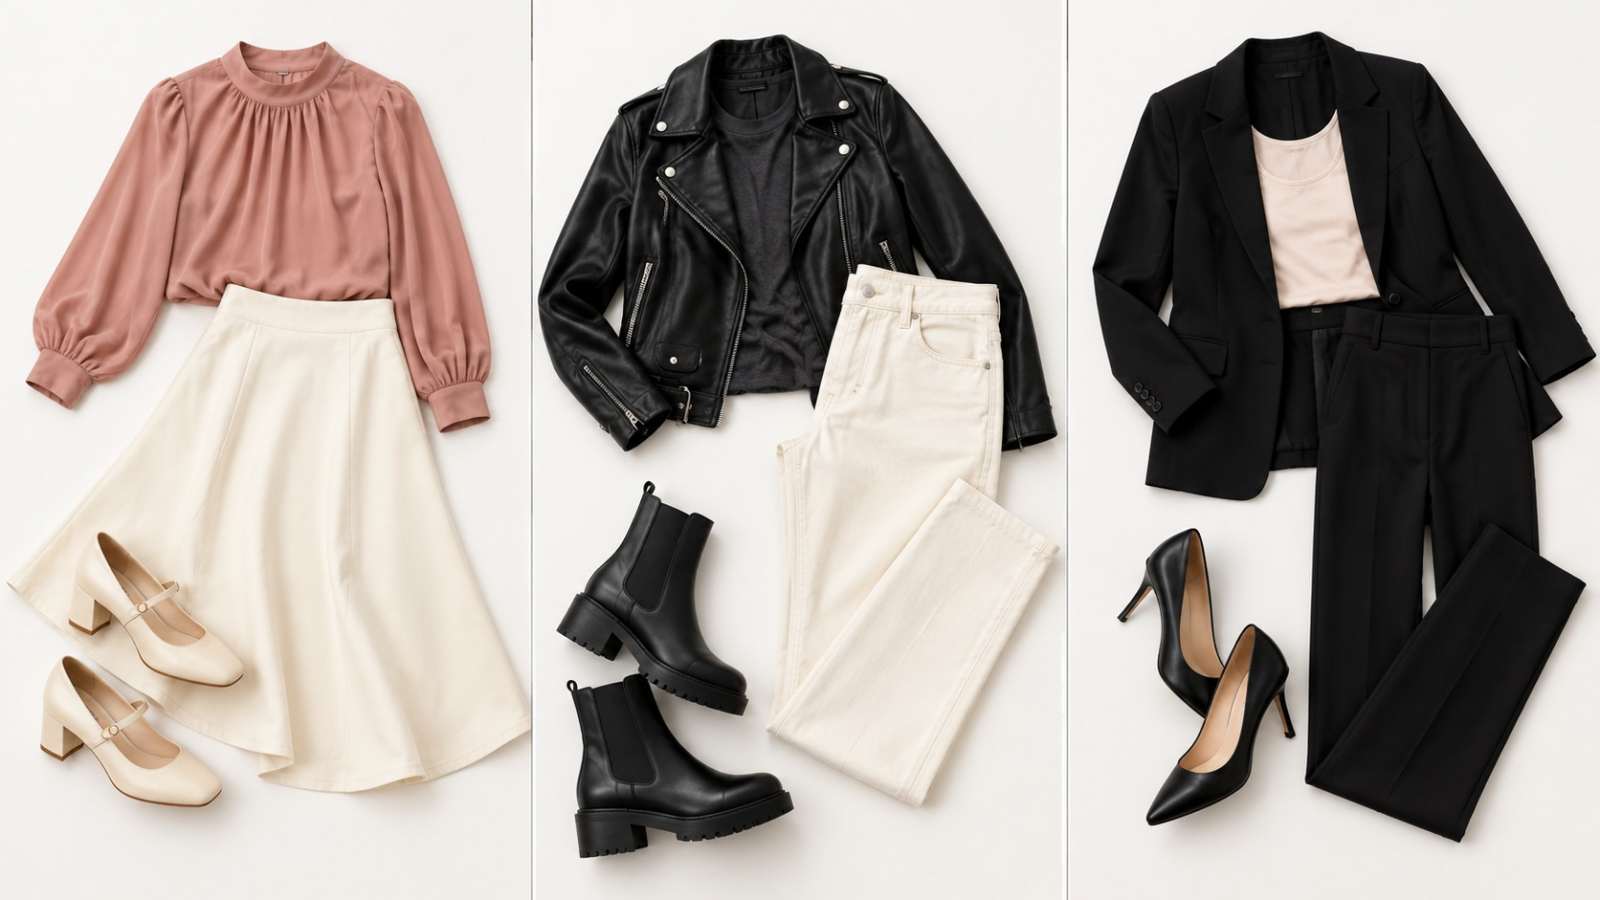
Можно собрать три заметно разных варианта, чтобы переходы сильнее отличались друг от друга, или подобрать вещи в одной стилистике и получить более цельную fashion-последовательность.
Шаг 4. Загрузить все четыре изображения
Сначала добавьте фотографию человека, затем три референса одежды в предусмотренные для них поля.
Собственный промпт писать не требуется. Порядок смены образов и сама сцена на эскалаторе уже заданы пресетом.
Шаг 5. Запустить генерацию и скачать ролик
После загрузки всех изображений запустите генерацию. На выходе получается вертикальное видео длительностью 14 секунд.
Формат ролика 9:16, разрешение 720p. В готовом видео есть звук.
После генерации стоит посмотреть всю последовательность целиком: насколько узнаваем герой и насколько хорошо отличаются друг от друга три выбранных образа.
Почему смена трёх образов выглядит цельно
Главный приём — постоянное движение. Герой всё время находится на эскалаторе, поэтому у трёх переодеваний есть единая визуальная основа.
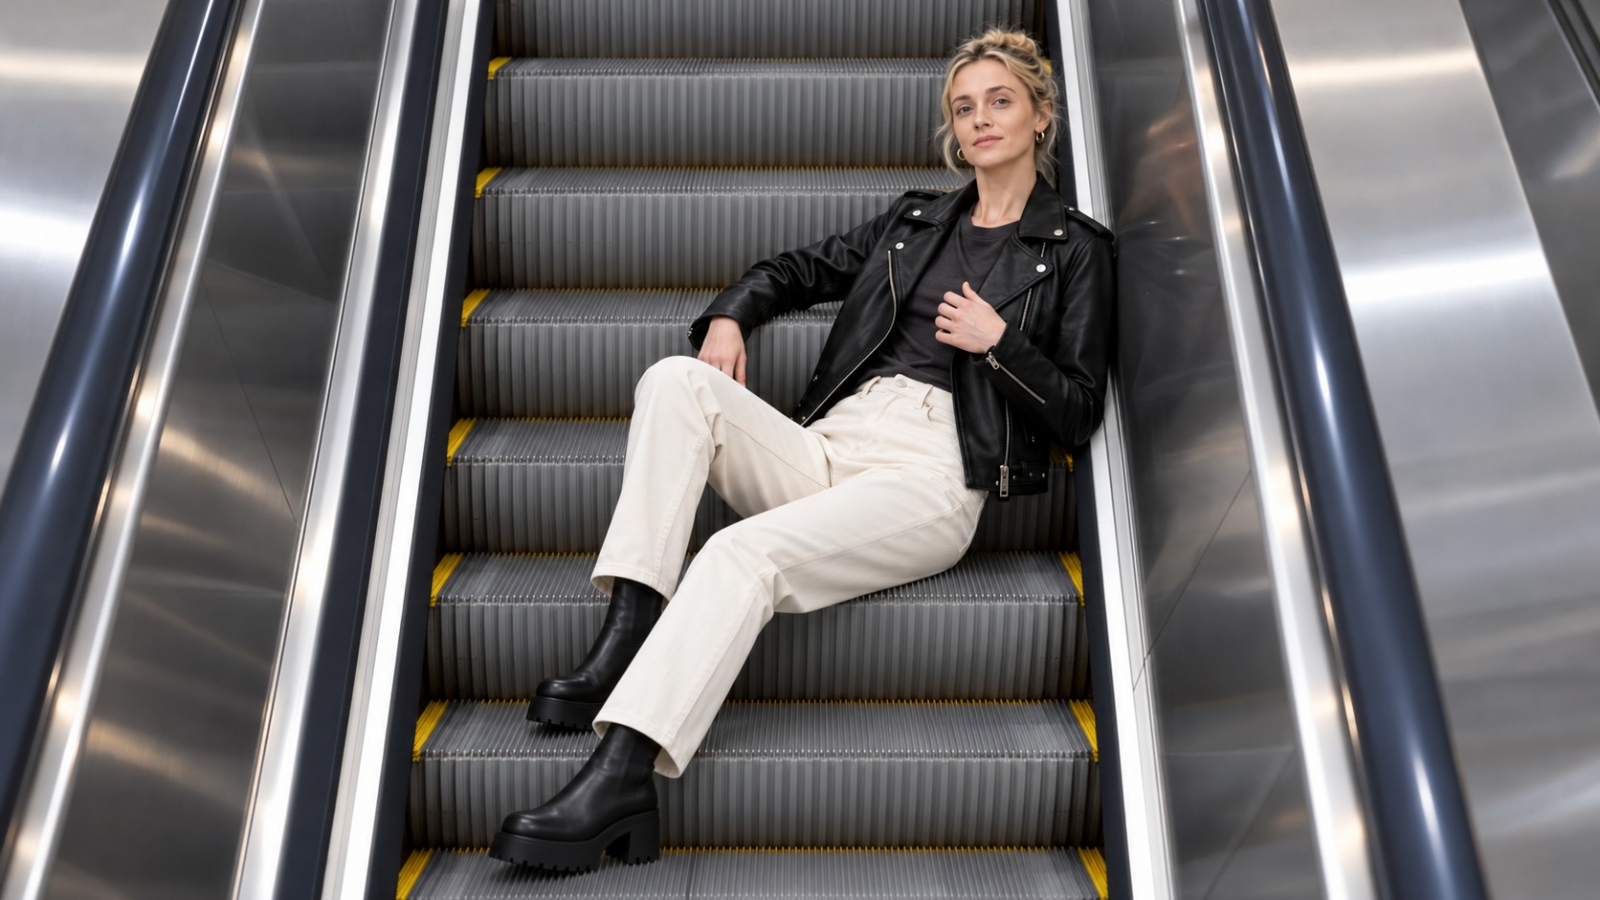
Сам эскалатор тоже помогает подчеркнуть смену образов. Человек продолжает двигаться вперёд, а одежда меняется по ходу сцены. Переходы воспринимаются как часть одного ролика.
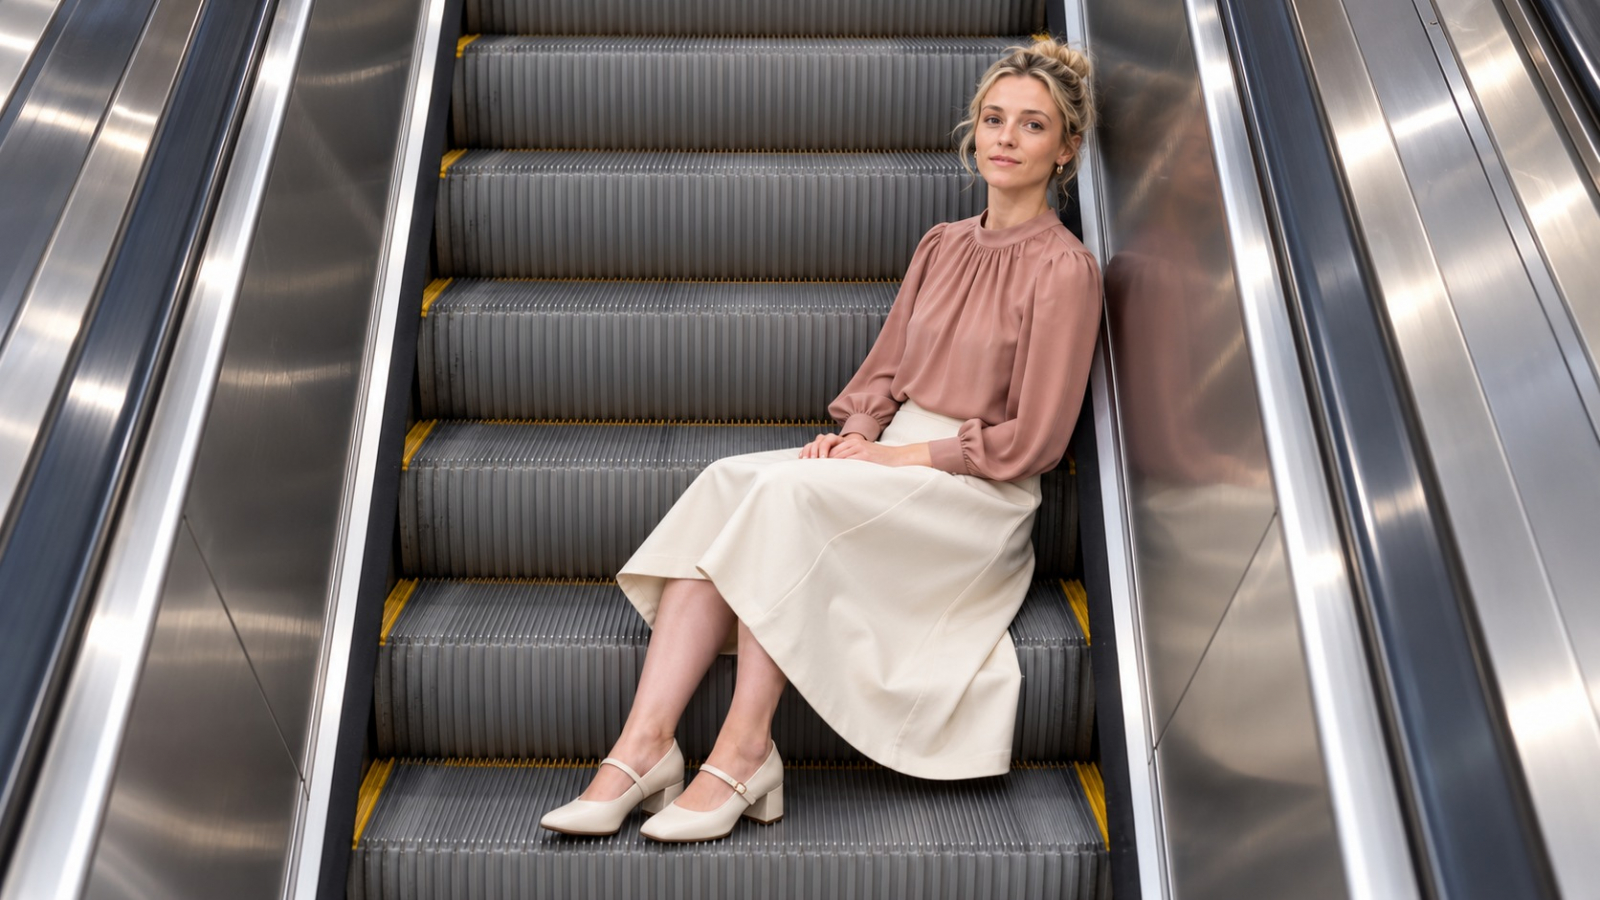
Второй важный элемент — повторяемость героя. Лицо, фигура и положение человека объединяют три наряда. Зритель сравнивает именно одежду, потому что основной персонаж остаётся тем же.
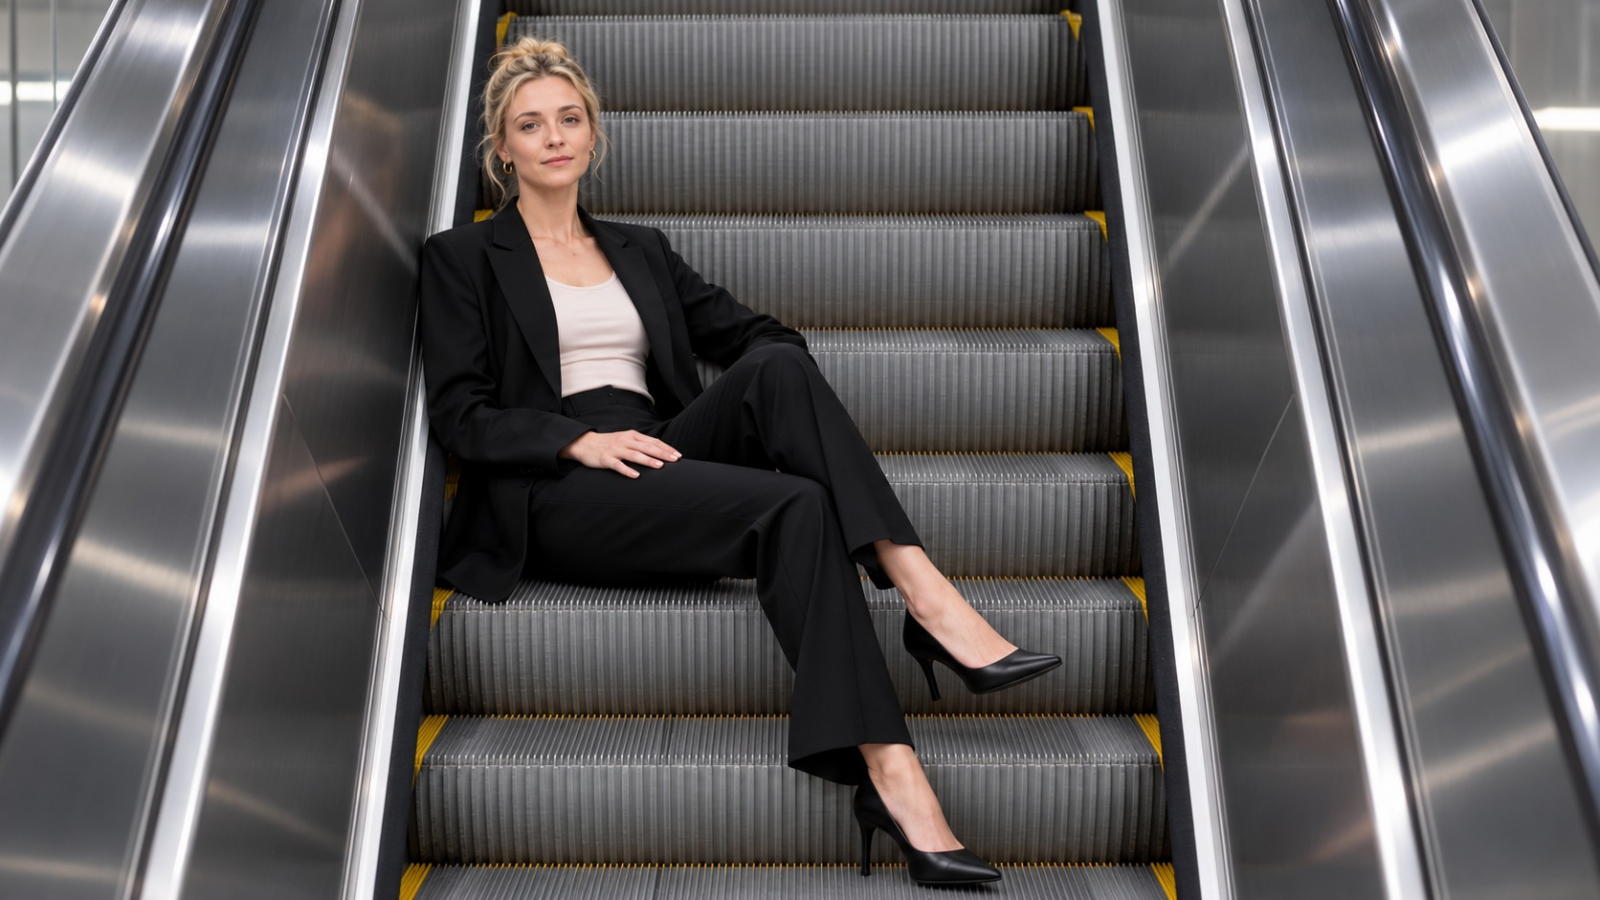
Поэтому особенно заметно работают референсы, которые отличаются силуэтом, фактурой или общей стилистикой. Тогда каждое переодевание даёт новый визуальный этап, но сцена не распадается на отдельные фрагменты.
Частые вопросы
Сколько фотографий нужно для пресета?
Всего понадобится четыре изображения: одна фотография человека и три референса одежды.
Должен ли человек быть на фотографиях одежды?
Нет. Для трёх референсов нужны изображения одежды без людей.
Что делать, если один из образов перенёсся неудачно?
Попробуйте заменить именно его референс. Лучше использовать изображение, на котором одежда хорошо различима и не закрыта лишними объектами.
Итоги
«Три образа на эскалаторе» позволяет показать три разных наряда на одном человеке внутри одной fashion-сцены. Для генерации нужны фотография героя и три референса одежды, а смена образов происходит прямо во время движения по эскалатору.
Путь короткий: SpeShu.AI → «Ворваться в тренды» → «Три образа на эскалаторе» → загрузить фото человека и три наряда → создать видео. Для более наглядного результата лучше брать хорошо различимые и заметно отличающиеся друг от друга образы.