Как создать ИИ танец на заправке как у Литвина через нейросеть Seedance: Готовый промт
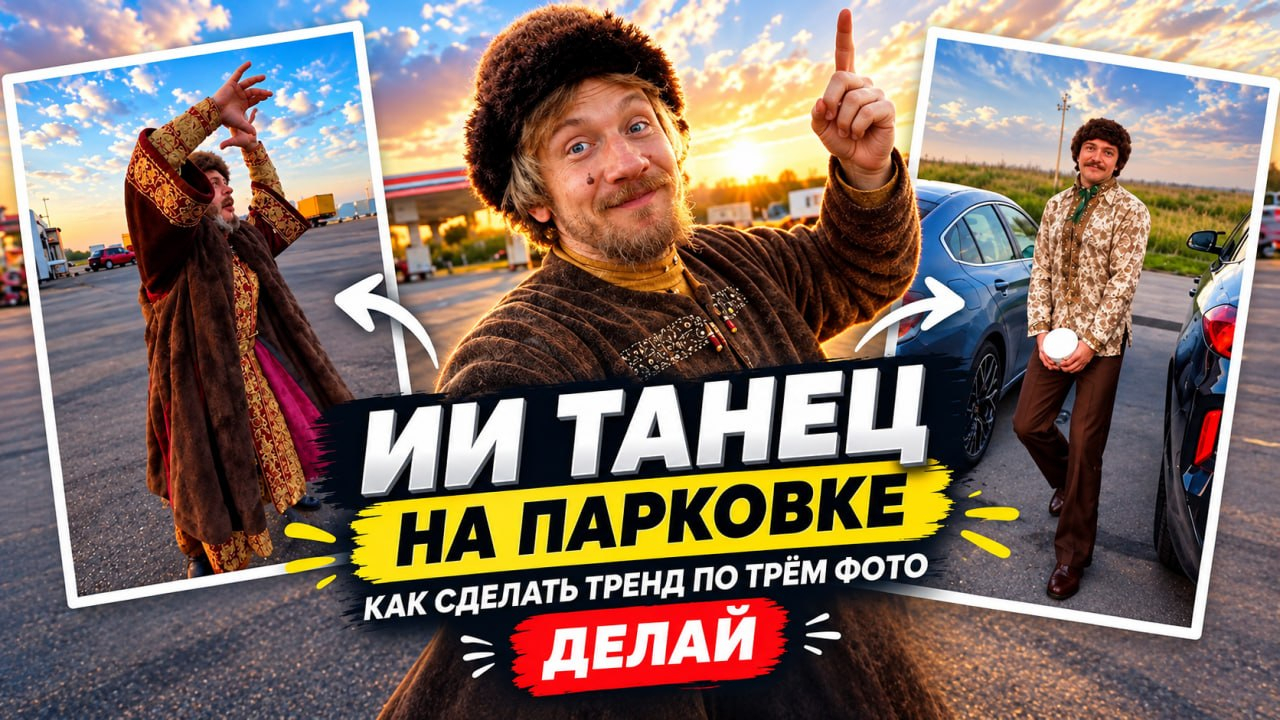
Еще недавно для такого ролика пришлось бы собирать компанию, искать подходящую локацию, несколько раз переснимать танец и потом долго монтировать видео. Сегодня достаточно нескольких фотографий и правильно составленного промта.
Тренд с танцем возле машин на заправке и парковке быстро привлекает внимание именно за счет ощущения обычной съемки на телефон. Люди двигаются, камера резко поворачивается, кто-то выходит из автомобиля, а в кадре остается атмосфера дальней поездки. При этом теперь необязательно повторять сцену в реальности - похожую постановку можно воссоздать с помощью генеративной нейросети.
Для этого существуют готовые промты под Seedance, которые уже учитывают движение камеры, последовательность действий, внешний вид персонажей, освещение и формат вертикального видео. Один вариант подойдет для недорогого теста, другой - для более качественной финальной генерации.
Как сделать трендовый ИИ танец на заправке как у Литвина: Пошаговая инструкция
Создать такой ролик можно без самостоятельного написания сложного промта и длительной настройки параметров. Готовый шаблон уже содержит описание сцены, движения персонажей и работу камеры, поэтому процесс сводится к подготовке фотографий, выбору подходящего варианта Seedance и запуску генерации.
Шаг 1. Подготовка трех фото для генерации
Для начала подготовьте три фотографии людей, которые будут участвовать в видео. Лучше всего подходят четкие снимки анфас в полный рост, где хорошо видно лицо, фигуру и одежду человека. Чем качественнее исходные изображения, тем проще нейросети сохранить внешность персонажей во время движения.
Особенно важно правильно определить порядок фотографий. Фото 1 используется для человека, который начинает танцевать. Фото 2 - для участника, который снимает себя на камеру. Фото 3 - для персонажа, который выходит из машины. Поэтому фотографии желательно заранее подготовить именно в такой последовательности.
Шаг 2. Выбор готового промта для трендового танца на заправке
Готовые промты для Seedance Fast или Seedance 2.5 для тренда на парковке заправки
Seedance Fast подойдет для более дешевого тестового запуска. Это удобный вариант, если вы хотите сначала проверить, как нейросеть работает именно с вашими фотографиями, насколько хорошо сохраняет внешность и правильно ли выполняет движения. Готовый промт уже содержит основную сцену с автомобилями, заправкой, танцем и движением камеры, поэтому самостоятельно прописывать все эти детали не придется.
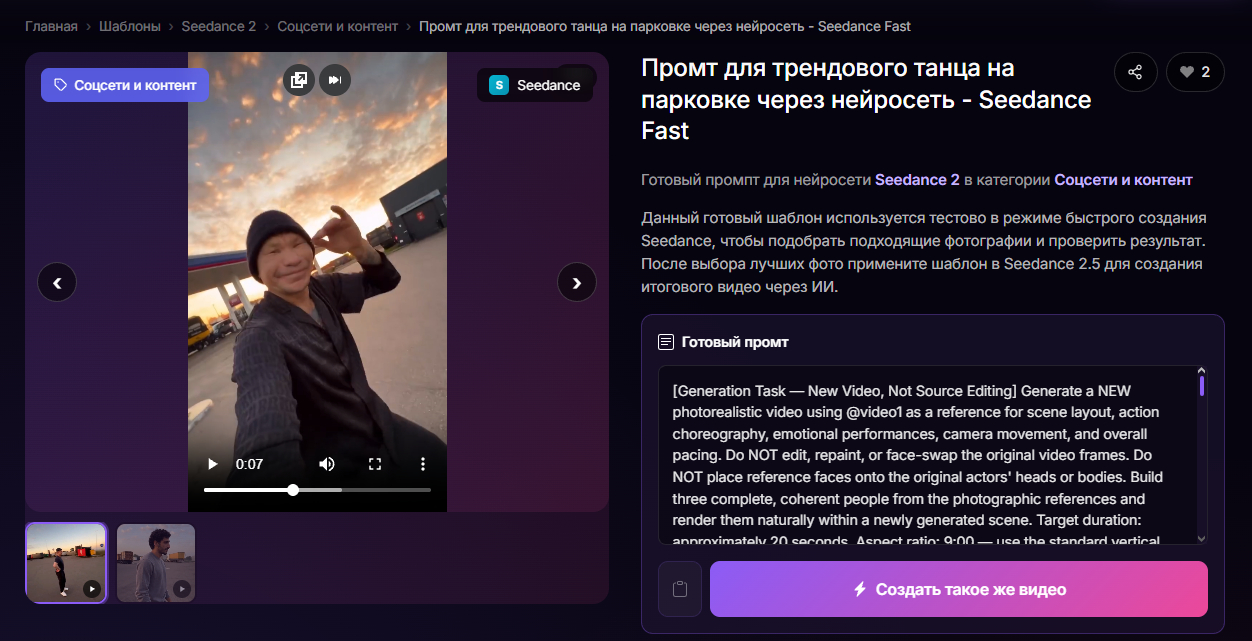
Seedance 2.5 стоит выбрать, если нужен более уверенный итоговый вариант. Готовый промт рассчитан непосредственно на сцену с танцем на заправке и включает последовательность действий трех персонажей, смену ракурсов, работу камеры и другие детали постановки. За счет использования более дорогой модели итоговая генерация обходится дороже, поэтому практично сначала протестировать идею через Seedance Fast, а затем переходить к Seedance 2.5.
Шаг 3. Генерация видео в пару кликов
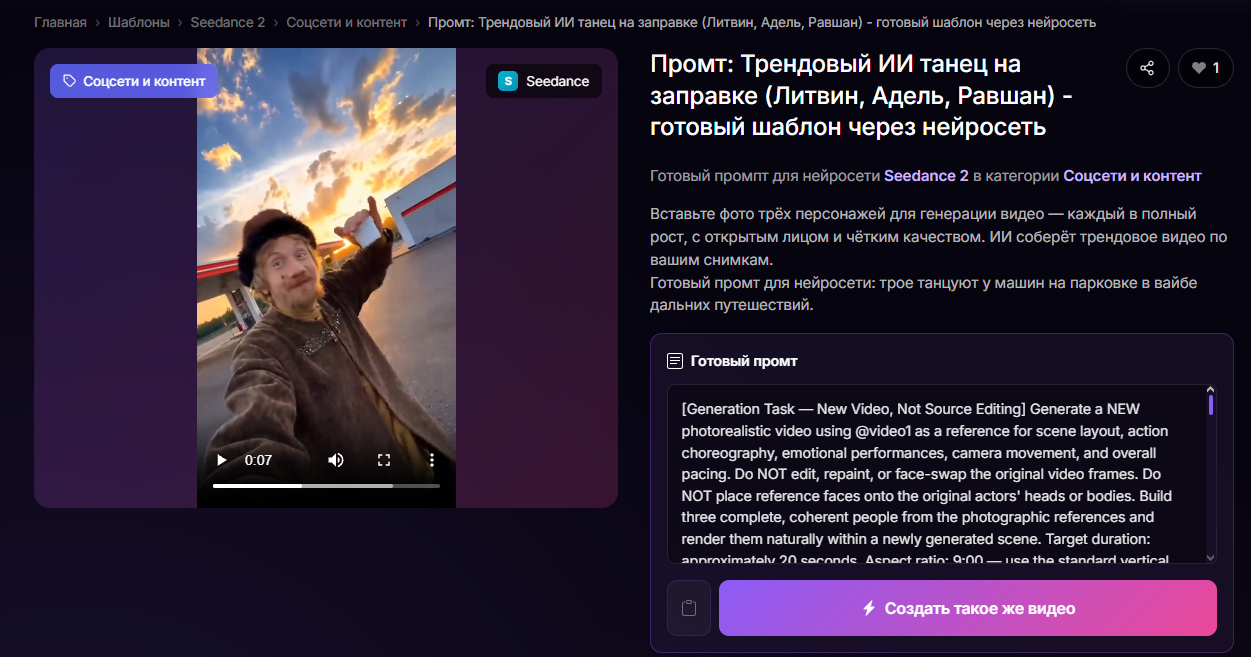
Когда фотографии подготовлены и готовый промт выбран, сама генерация не требует специальных навыков. Откройте шаблон, нажмите «Применить», вставьте три фотографии анфас в полный рост в соответствующие поля и запустите генерацию. Весь процесс рассчитан на простое взаимодействие с готовым интерфейсом. Не нужно самостоятельно писать длинные команды, разбираться в настройках движения камеры или описывать хореографию. За это уже отвечает подготовленный промт. В итоге достаточно буквально нескольких действий, чтобы получить готовый вертикальный ролик с тремя персонажами, танцем, автомобилями и динамичной съемкой. Такой способ подойдет даже тем, кто впервые пробует создавать видео с помощью нейросетей.
Готовые промты для генерации трендового видео на заправке
1. Промт: Трендовый ИИ танец на заправке (Литвин, Адель, Равшан) - готовый шаблон через нейросеть
2. Промт для трендового танца на парковке через нейросеть - Seedance Fast
Нейросеть для генерации трендового ИИ видео танца на заправке: Какую выбрать?
Если задача заключается не просто в создании короткой анимации по фотографии, а в том, чтобы получить полноценное ИИ видео с танцем на заправке, автомобилями, несколькими персонажами и движением камеры, большое значение имеет выбор модели. В этом сценарии особенно интересны Seedance Fast и Seedance 2.5.
Они подходят для разных задач. Seedance Fast удобнее рассматривать как более доступный вариант для быстрых тестов, когда хочется проверить идею и фотографии. Seedance 2.5 рассчитана на более сложные видеосцены, где важны последовательность действий, работа с несколькими персонажами, движение камеры и общее качество результата.
Какая нейросеть нужна для создания ИИ танца на заправке
Для трендового видео по фотографиям недостаточно просто попросить нейросеть "сделать танец". В хорошем результате одновременно должны совпасть внешность участников, движения тела, положение автомобилей, окружение, освещение и логика происходящего в кадре. Именно поэтому для такого формата важна модель, которая умеет работать не только с текстовым описанием, но и с визуальными референсами.
Seedance 2.5 относится к новому поколению моделей ByteDance для создания видео и объединяет генерацию аудио и видео. По официальному описанию, модель рассчитана на создание роликов продолжительностью до 30 секунд за одну генерацию, поддерживает несколько раундов продолжения и более точную работу с референсами.
Для обычного пользователя это означает главное: сложную сцену можно описать заранее, загрузить необходимые фотографии и получить уже связный видеоролик, а не набор отдельных анимированных кадров.
Что такое Seedance 2.5 для генерации видео с заправки
Seedance 2.5 - это современная модель для генерации видео от ByteDance. В официальной документации особый акцент сделан на длинных сценах, мультимодальных референсах и управляемом монтаже. Модель способна генерировать до 30 секунд видео за один запуск, а также поддерживает дальнейшее расширение ролика.
Для ИИ танца на заправке это особенно актуально. Сцена может состоять сразу из нескольких последовательных действий: один человек начинает танцевать, камера меняет положение, второй участник снимает себя, затем появляется третий человек и происходит новое действие возле автомобиля.
Вместо того чтобы отдельно создавать несколько коротких фрагментов и потом соединять их в редакторе, часть этой последовательности можно задать непосредственно на этапе генерации.
Еще одна важная особенность Seedance 2.5 - расширенная работа с референсами. Официально заявлена возможность использовать до 30 изображений, 10 видео и 10 аудиофайлов в одной генерации. Модель учитывает композицию, персонажей, сцены, стиль и другие элементы исходных материалов.
Для ролика с тремя людьми это дает больше возможностей контролировать исходную сцену и внешний вид участников.
Почему Seedance 2.5 подходит для танца по фото
Главная проблема при создании ИИ видео с людьми заключается в сохранении персонажа во время движения. Когда человек начинает танцевать, нейросети приходится одновременно генерировать лицо, тело, одежду, руки, ноги и движение камеры.
Seedance 2.5 специально развивает направление стабильного движения и работы со сложными сценами. В описании модели ByteDance отдельно отмечает более плавное движение, улучшенную реалистичность и более точное управление сценой.
Поэтому модель хорошо подходит для сценариев, где персонаж не просто стоит перед камерой, а двигается, поворачивается, взаимодействует с автомобилем или оказывается в разных планах.
При этом исходная фотография остается важнейшей частью процесса. Даже самая современная модель не сможет гарантировать одинаково хороший результат с нечетким, сильно обрезанным или неудобным исходником. Для трендового видео лучше использовать четкие фотографии анфас в полный рост.
Что такое Seedance Fast и зачем она нужна для генерации тренда с заправки
Seedance Fast в данном формате стоит рассматривать прежде всего как более доступный способ проверить идею перед использованием более дорогой генерации. Если пользователь впервые создает ИИ танец по фото, нет большого смысла сразу запускать несколько дорогих вариантов, не проверив исходные фотографии. С помощью готового промта для Seedance Fast можно посмотреть, насколько хорошо нейросеть распознает участников, сохраняет их внешность и справляется с заданной сценой.
Такой подход особенно удобен, когда необходимо подобрать наиболее удачную фотографию человека. Например, можно обнаружить, что на одном исходнике лицо сохраняется лучше, чем на другом, или что определенный ракурс приводит к нежелательным изменениям фигуры во время танца. В результате Seedance Fast становится своего рода первым этапом перед созданием финального ролика.
Чем отличается Seedance Fast от Seedance 2.5
Главное различие для пользователя заключается не только в названии модели, но и в задаче, для которой используется генерация. Seedance Fast логично выбрать, когда нужно быстро и дешевле протестировать концепцию. Готовый промт уже содержит основную идею сцены, поэтому пользователь может загрузить фотографии и посмотреть, как работает задумка именно с его материалами.
Seedance 2.5 имеет смысл использовать, когда требуется более уверенный финальный результат с комплексной постановкой. Официально модель ориентирована на 30-секундные истории, сложные переходы, работу с большим количеством референсов и более точное управление монтажом. Иными словами, Fast удобнее для проверки, а 2.5 - для более серьезной финальной генерации.
Какой Seedance выбрать для ИИ танца на заправке
Если вы просто хотите попробовать тренд и посмотреть, что получится из трех фотографий, разумно начать с Seedance Fast. Это позволяет сначала проверить исходные материалы и не тратить больше ресурсов на первый эксперимент. Если результат уже понятен и хочется получить полноценную версию ролика, можно перейти к Seedance 2.5. В случае с танцем на заправке это особенно актуально, поскольку готовый промт предусматривает несколько персонажей, движение камеры, автомобили и последовательное развитие сцены. Получается простая схема: сначала недорогой тест через Seedance Fast, затем финальная генерация через Seedance 2.5.
Почему готовый промт важнее, чем просто выбор нейросети
Даже хорошая модель не всегда дает нужный результат от одной короткой команды. Если написать только "три человека танцуют на заправке", нейросеть сама будет решать, кто и когда появляется, куда направляется камера, как располагаются автомобили и какие действия происходят дальше.
Готовый промт решает эту проблему за счет заранее продуманной постановки. В нем можно задать последовательность действий, роли персонажей, движение камеры, окружение, освещение и визуальный стиль.
Поэтому в данном случае пользователь выбирает не только нейросеть для генерации видео, но и готовый сценарий, который помогает модели понять, какой именно ролик требуется получить.
Какой промт Seedance выбрать для трендового видео на заправке как у Литвина
Для более дешевого эксперимента подойдет готовый промт на основе Seedance Fast. Его удобно использовать на этапе проверки: загрузить три фотографии, запустить генерацию и оценить, насколько хорошо нейросеть справляется с конкретными людьми.
Для финального варианта предназначен готовый промт под Seedance 2.5. Он рассчитан на более сложную сцену с танцем на заправке и несколькими последовательными действиями. Более высокая стоимость здесь связана с использованием более мощной модели.
Таким образом, не обязательно сразу выбирать самый дорогой вариант. Если задача заключается в тестировании идеи, достаточно начать с Fast. Если же хочется сразу получить максимально проработанную версию, можно использовать Seedance 2.5.
Подойдет ли Seedance новичку для создания ИИ видео
Несмотря на сложность самой технологии, пользователю необязательно разбираться в принципах работы генеративных моделей. При использовании готового шаблона большая часть технической работы уже выполнена заранее.
По сути, остается выбрать готовый вариант, применить шаблон, загрузить фотографии и запустить генерацию. Это значительно проще самостоятельного написания большого промта с нуля.
Именно поэтому формат готовых промтов подходит не только создателям контента, но и обычным пользователям, которые хотят впервые сделать трендовое видео по фото через нейросеть.
Seedance 2.5 для реалистичного видео с людьми и автомобилями
Для сцены на заправке важна не только анимация людей. В кадре одновременно присутствуют автомобили, дорожное покрытие, освещение, здания или элементы заправочной станции и камера, которая перемещается между персонажами.
Seedance 2.5 развивает именно такие возможности комплексной генерации. ByteDance отдельно указывает на улучшения в движении, переходах между сценами, визуальной реалистичности и работе с референсами.
Кроме того, модель поддерживает более точное управление отдельными моментами видео и расширенные функции редактирования, включая работу с перспективой камеры и референсным редактированием.
Это делает ее интересной именно для постановочных роликов, где заранее известно, что должно происходить в каждом фрагменте.
Как выбрать нейросеть для ИИ танца: Fast или 2.5
Выбор можно свести к простой логике. Если хочется дешевле проверить идею, подойдет Seedance Fast. Если нужно создать более сложный итоговый ролик, имеет смысл выбрать Seedance 2.5.
При этом один вариант не обязательно исключает другой. Наоборот, их можно использовать последовательно: сначала проверить фотографии и концепцию через Fast, а затем повторить удачный вариант в Seedance 2.5.
Такой подход особенно удобен для трендового контента, где результат во многом зависит от исходных фотографий. Вместо того чтобы несколько раз использовать более дорогую генерацию, сначала можно найти подходящие изображения и только после этого создавать финальную версию.
Итог: какая нейросеть лучше для танца на заправке
Для создания ИИ танца на заправке по фотографии обе модели могут использоваться в рамках одного рабочего процесса, но с разными задачами.
Seedance Fast подходит для быстрого и более доступного тестирования готового промта. Это хороший способ проверить фотографии, персонажей и общую идею ролика.
Seedance 2.5 рассчитана на более сложные видеосцены и предлагает расширенные возможности для длительных последовательностей, референсов, движения и редактирования. Официально ByteDance позиционирует ее как модель для 30-секундного повествовательного видео с точным управлением референсами и сценой.
Поэтому для такого тренда оптимально использовать их не как конкурирующие варианты, а как два этапа одной генерации: Seedance Fast - для проверки, Seedance 2.5 - для финального результата.
Попробуйте создать ИИ танец на заправке по фото уже сейчас
Хотите повторить тренд и сделать собственное ИИ видео с танцем на заправке? Начните с готового промта для Seedance - вам не придется самостоятельно писать сложные инструкции для нейросети или разбираться в настройках генерации.
Для первого теста подойдет более доступный вариант на 👉Готовый промт Seedance Fast👈, а если нужен более проработанный итоговый ролик 👉Готовый промт для Seedance 2.5👈. Загрузите три фотографии в полный рост, примените готовый шаблон и запустите генерацию. Несколько простых действий - и у вас будет собственное трендовое видео с танцем по фото через нейросеть.
Попробуйте создать свой ИИ танец на заправке и проверьте, как ваши фотографии будут выглядеть в готовом видео!