Контент, который читает не только человек. Как писать для LLM?
Рассказываем, почему тексты для ChatGPT и других нейросетей требуют новой логики копирайтинга и как к ней адаптироваться.
У текста появился второй читатель
Редактор готовит статью. Шлифует структуру, убирает воду, публикует. Потом заходит в аналитику и видит там трафик. Но не из Google, а из ChatGPT.
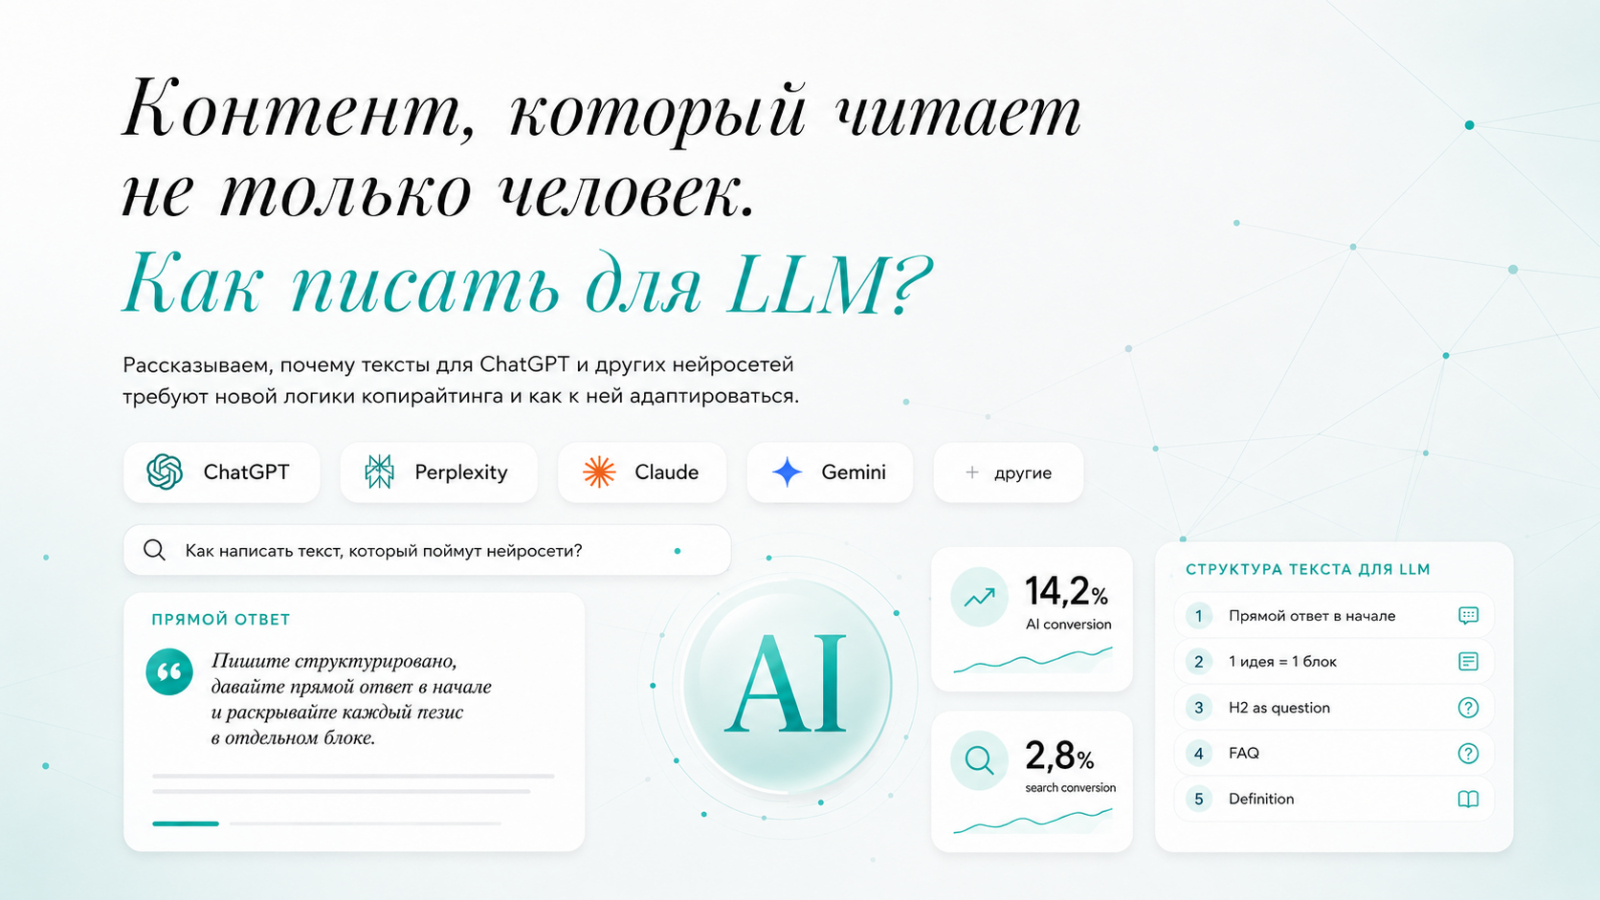
Кто-то задал модели вопрос и получил ответ, в котором оказалась ссылка на эту статью. Зашёл на сайт. Провёл там в четыре раза дольше времени, чем средний посетитель из поиска. И сразу оставил заявку. Звучит, как утопия, но данные по конверсии не оставляют сомнений. Исследование Superprompt (347 компаний, 12,3 млн визитов) показывает, что конверсия составляет 14,2% против 2,8% в пользу AI. Разрыв в пять раз.
Но чтобы попасть в этот поток, надо сначала оказаться в ответе. И для этого текст должен понравиться не только человеку.
Как нейросеть «читает» текст
LLM не читает так, как читаем мы. Нет перечитывания, нет уточняющих вопросов, нет догадок из контекста. Модель разбивает текст на фрагменты, ищет в них вероятные связи и собирает ответ из того, что нашла.
Вывод простой. Выигрывают тексты с явными смыслами. Сравните два варианта:
- «В современном мире существует множество CRM-решений, каждое из которых имеет свои особенности».
- «CRM – это система для управления клиентами: хранит историю контактов, напоминает о задачах и считает конверсию по воронке».
Первое написано обтекаемо и бесполезно. Второе – конкретно и самодостаточно. Такие фрагменты модель и вставляет в ответы.
Определения, факты, структурированные списки, прямые ответы – вот с чем нейросети работают хорошо. Маркетинговый воздух, длинные вступления, намёки – с этим они не работают вообще.
Текст больше не просто читают, его интерпретируют и пересобирают. Пользователь часто не открывает сайт, ведь он уже получил ответ. В нём может быть фрагмент вашего текста. Или не вашего.
Пять принципов, которые делают текст цитируемым
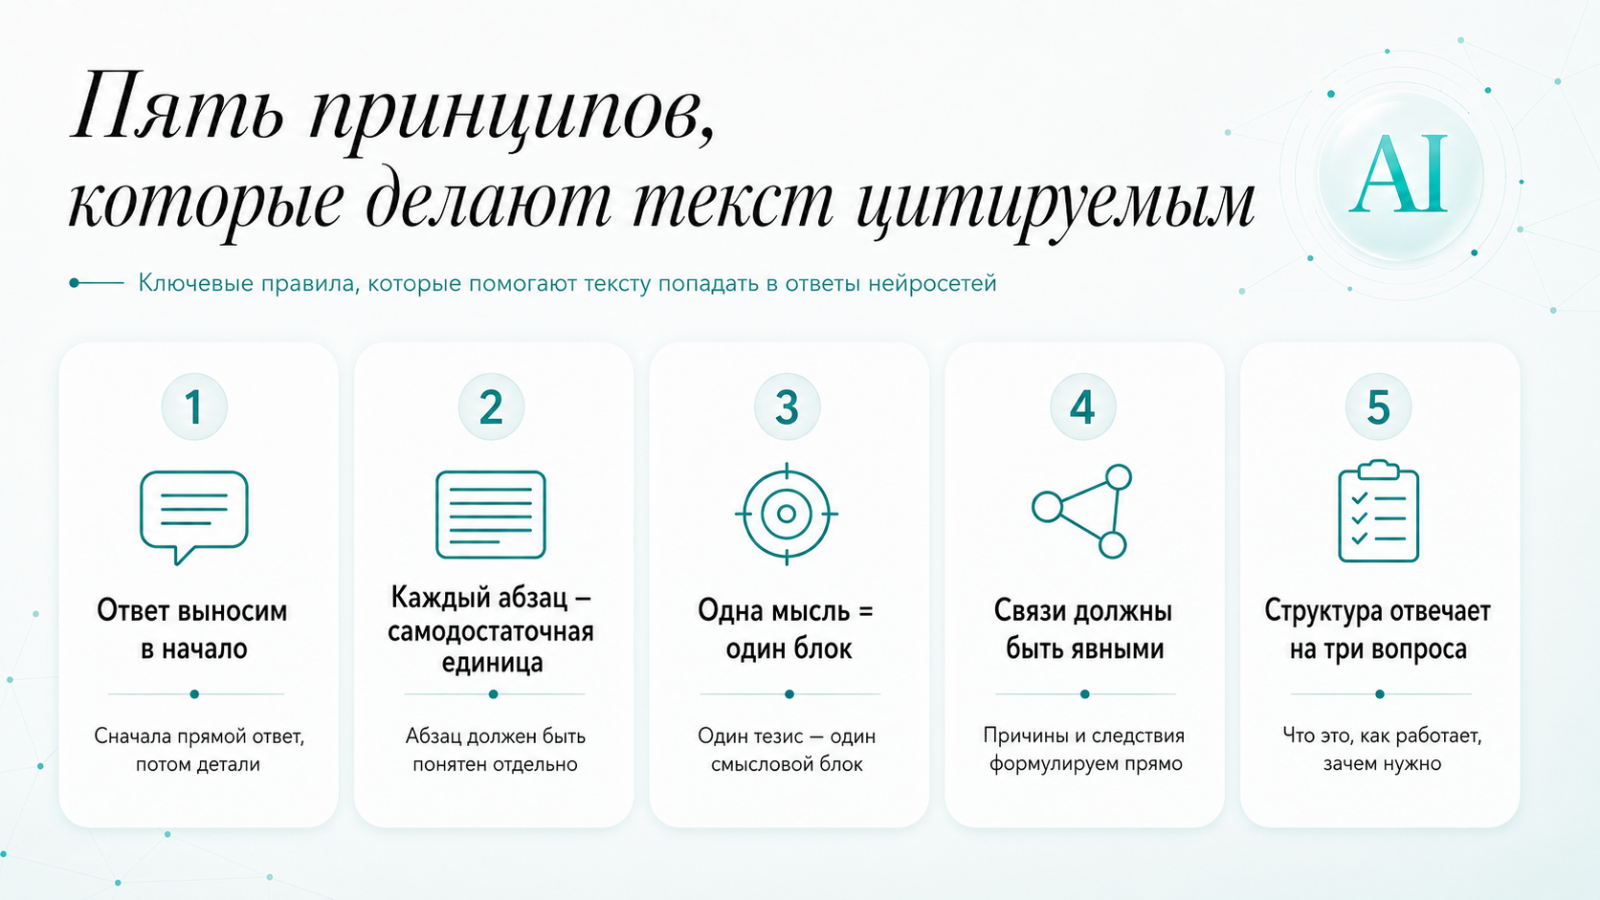
Принцип 1. Ответ выносим в начало
Классический копирайтинг работал через разогрев интереса. Сначала шла интрига, потом мы медленно подбирались к сути. Для нейросети всё работает в обратную сторону.
Если ответ на вопрос не попадает в первые 150–200 слов, то модель, скорее всего, его не использует. Простая схема. Сначала прямой ответ, а уже потом объяснение, примеры и нюансы.
Пример:
- Плохо: «Многие задаются вопросом, стоит ли внедрять CDP. Давайте разберёмся вместе...»
- Хорошо: «CDP стоит внедрять, если у вас больше двух каналов привлечения и данные о клиентах хранятся в разных системах. Вот почему...»
Принцип 2. Каждый абзац – самодостаточная единица
Задаём к каждому кусочку всего один вопрос: можно ли вырезать этот абзац и вставить в AI-ответ без потери смысла? Если нет, тогда он написан для непрерывного чтения. А, чтобы LLM нас заметила, каждый блок должен работать отдельно от предыдущего.
Принцип 3. Одна мысль = один блок
Длинные абзацы с несколькими идеями – главная ошибка контента прошлого десятилетия. Нейросети путаются в том, «что же хотел сказать автор», и хуже извлекают смысл из перегруженных блоков.
В блоке делаем пять-шесть предложений максимум. Каждый тезис «упаковываем» под свой заголовок.
Принцип 4. Связи должны быть явными
Нейросеть не достраивает логику. Она читает: «Такое решение помогает бизнесу расти», но связи не улавливает. Она не уточнит, а просто проигнорирует.
Пример:
- Плохо: «Автоматизация помогает экономить время».
- Хорошо: «Автоматизация отчётов сокращает работу аналитика с шести часов в неделю до сорока минут»
Конкретные утверждения удерживают фрагмент в ответе. Абстракция приводит к исключению из него.
Принцип 5. Структура отвечает на три вопроса
Каждый раздел должен явно давать ответы: что это, как работает, зачем нужно. Если хотя бы один ответ чётко не прописан, то цитируемость падает.
Почему структура – уже не просто оформление?
Заголовки в статье для нейросетей становятся смысловыми якорями. Модель воспринимает H2 как потенциальный вопрос пользователя, поэтому заголовок в форме вопроса даёт преимущество для цитируемости.
Анализ 158 публикаций, который провела команда HumanswithAI, зафиксировал, что заголовки-вопросы поднимают цитируемость на 19%. А таблица сравнения или чек-лист в тексте дают ещё 18%.
Как устроен блок текста, который хорошо цитируется?
- H2 в виде вопроса («Как X влияет на Y?»).
- Прямой ответ (одно-два предложения).
- Пояснение (три-пять предложений).
- Список или пример (готовые фрагменты для цитирования).
Бонусы:
- Таблицы помогают показать сравнение без лишних слов.
- Короткий абзац, из которого удобно брать смысл.
- FAQ в конце статьи – самый быстрый способ поднять цитируемость без переписывания всего остального.
Пять ошибок, которые делают текст невидимым
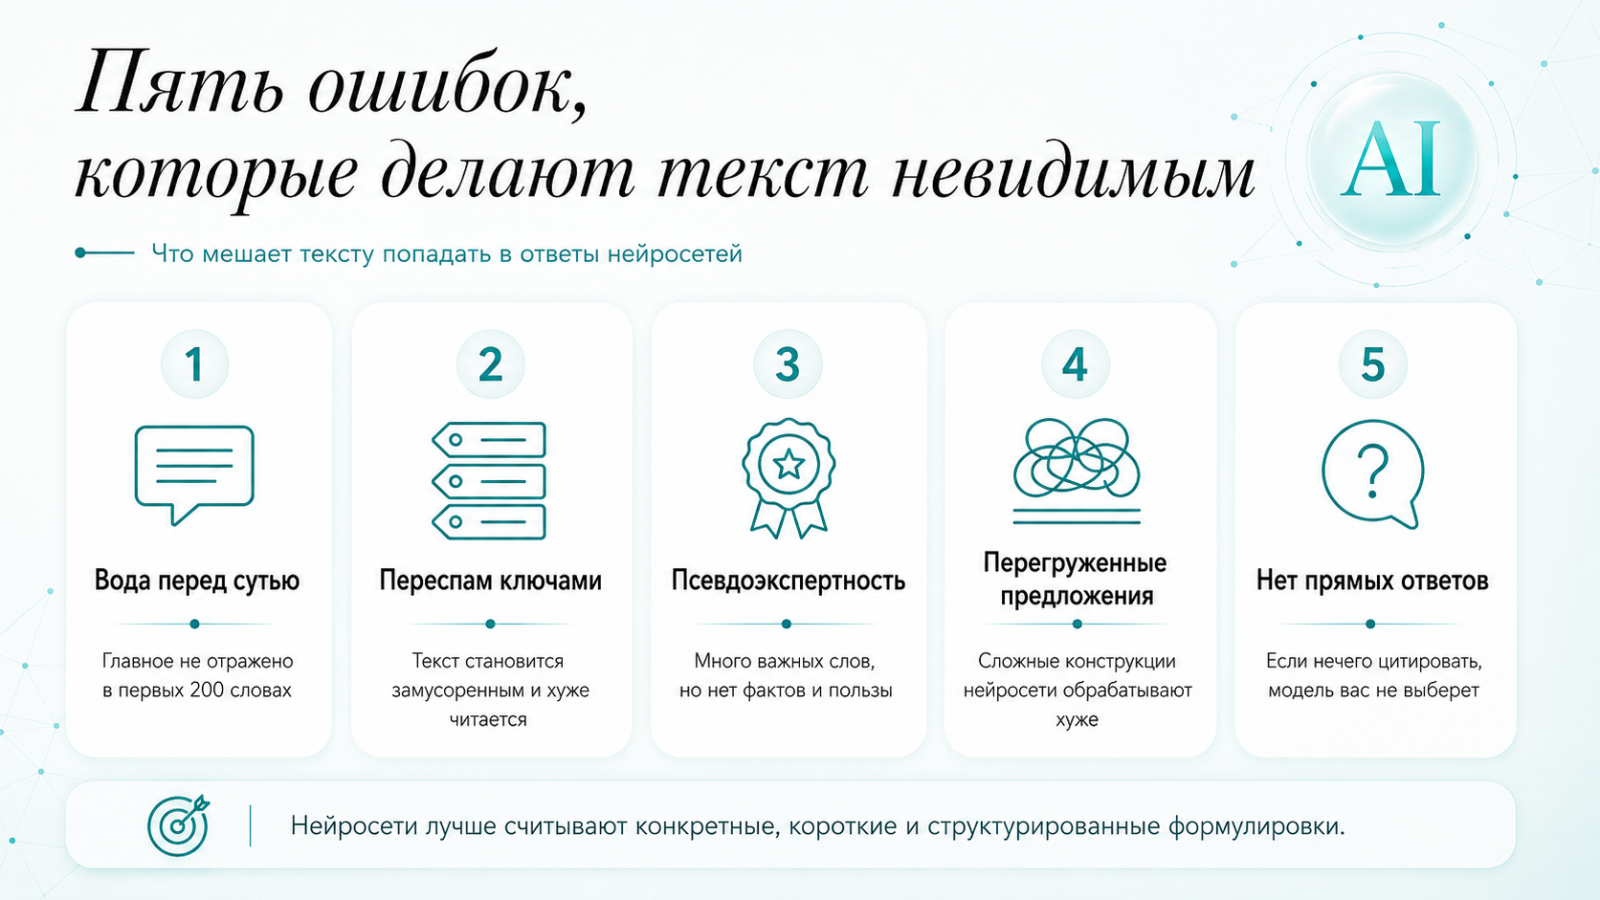
Ошибка 1. Вода перед сутью
«На сегодняшний день всё больше компаний задумываются о важности цифровой трансформации...»
Такие формулировки LLM пропускает. Если главное не отражено в первых 200 словах, то для модели его не существует.
Ошибка 2. Переспам ключами
«Контент-маркетинг и контент маркетинг – важная часть контент стратегии любой компании...»
Ломает смысл. Нейросеть ищет не ключи, а ответы. Замусоренный текст хуже читается и хуже цитируется.
Ошибка 3. Псевдоэкспертность
«На сегодняшний день одним из важнейших факторов является...»
Звучит солидно, не несёт ничего. Замените на факт или цифру, и абзац сразу изменится.
Ошибка 4. Перегруженные предложения
Сложноподчинённые конструкции на несколько строк нейросети обрабатывают хуже, ведь риск искажения при воспроизведении выше. Правило простое: предложения лучше делать не длиннее 25 слов.
Ошибка 5. Нет прямых ответов
Нечего цитировать, нет упоминания. Всё просто.
Как адаптировать контент? Пять шагов до результата
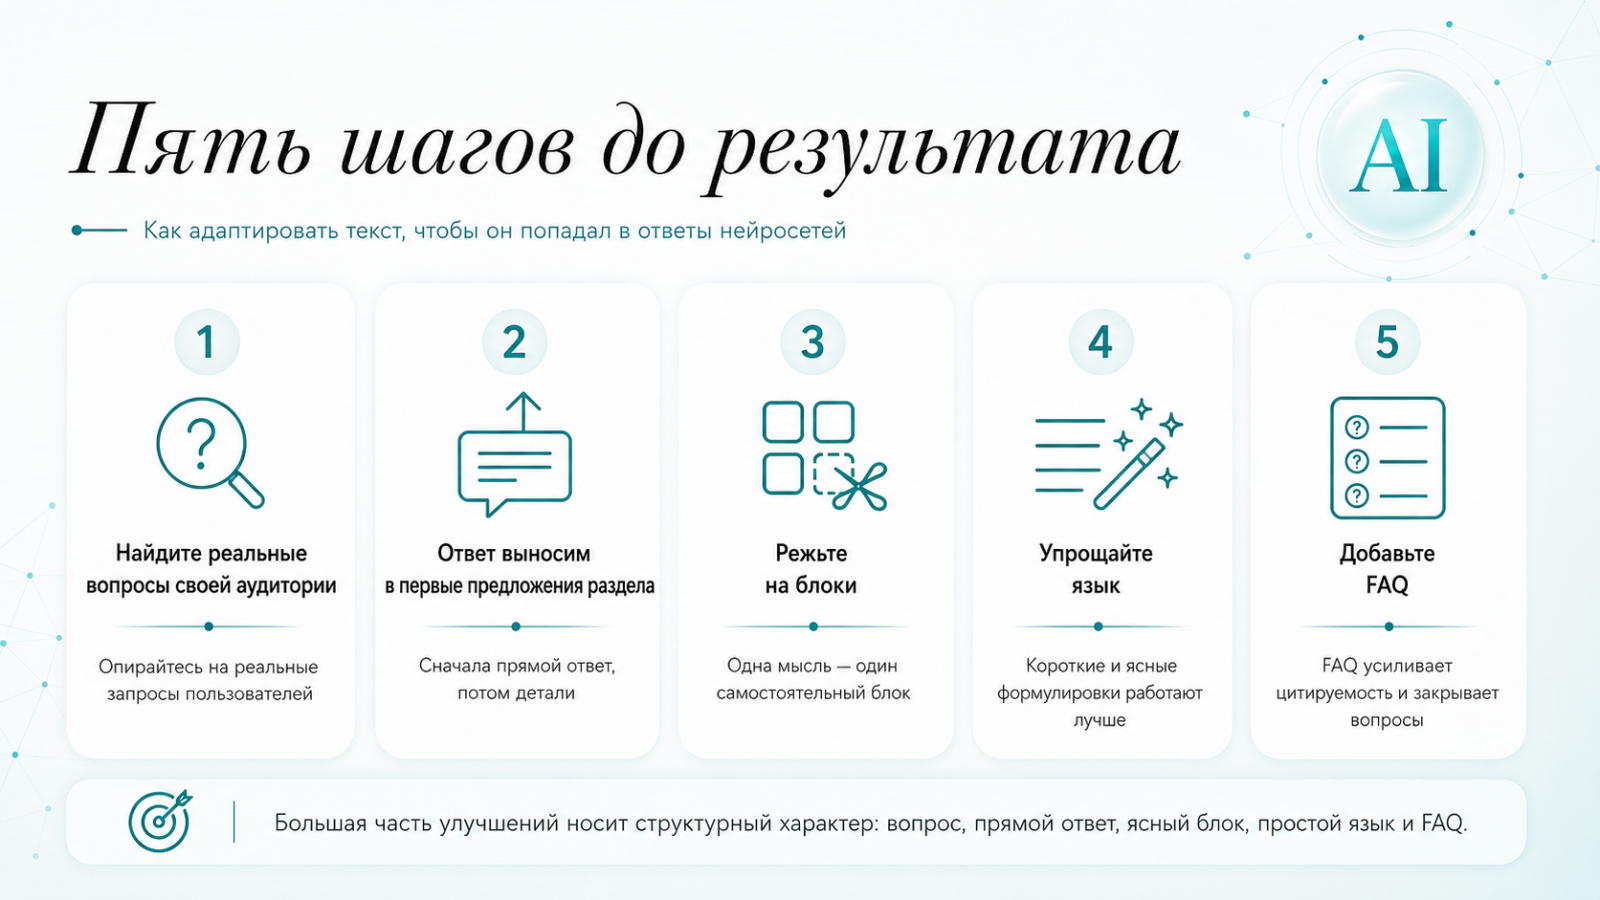
Большая часть изменений носит структурный характер.
Шаг 1. Найдите реальные вопросы своей аудитории.
Что люди спрашивают у ChatGPT, когда ищут то, чем занимается ваша компания? Введите эти вопросы в модель и посмотрите, кто в ответах. Так, вы найдёте конкурентов в AI-выдаче, а не тех, с кем боретесь в Google.
Шаг 2. Ответ выносим в первые предложения раздела.
Первые одно-два предложения = прямой ответ на вопрос заголовка.
Шаг 3. Режьте на блоки.
Один раздел – одна идея. Абзац длиннее шести предложений режьте без сожалений. Тема не уместилась в один заголовок? Значит, добавьте второй.
Шаг 4. Упрощайте язык.
Не до примитивности, а до ясности. «Осуществить взаимодействие» замените на «связаться». «Имплементировать решение» меняем на «внедрить». Если текст читается без усилий, то и модель поймёт его правильно.
Шаг 5. Добавьте FAQ.
Четыре-шесть вопросов с короткими ответами в конце статьи. Минимальная правка с заметным эффектом.
Что показал реальный эксперимент
Мы проверяли всё на практике. Взяли 158 материалов разных форматов – статьи, посты, видео – и прогнали через семь нейросетей: ChatGPT, Claude, Perplexity, Google AI Overviews и другие.
Результат был неожиданным.
Из vc.ru нейросети подхватывали каждую вторую статью – 52%. Medium – ноль. YouTube Shorts: 30 роликов, ни одного цитирования.
Теперь самое странное. Тексты, которые нейросети игнорировали, получали в среднем 62,5 балла по формальным критериям качества. Те, что попадали в ответы – 60,4 балла. Хуже написанные тексты цитировались чаще. Решает не мастерство копирайтера. Решают площадка, тема и структура.
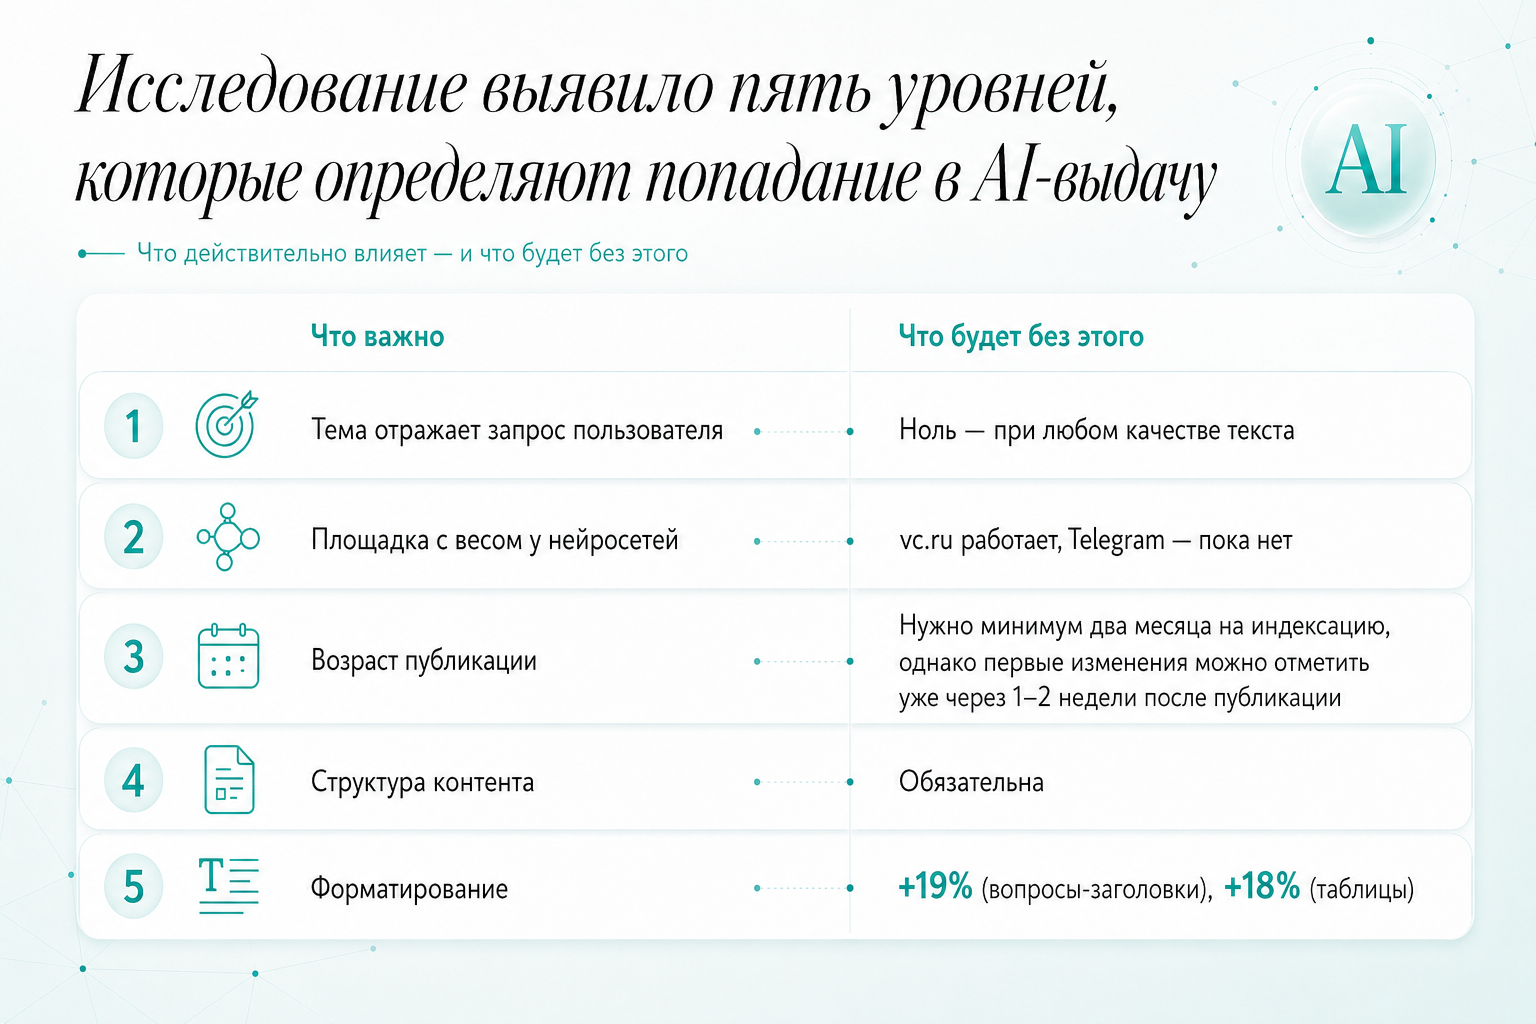
После эксперимента TenChat и YouTube Shorts убрали из контент-плана полностью. 70% публикационных ресурсов перебросили на vc.ru и Дзен. Все заголовки разделов переформулировали в вопросы. В каждую статью добавили хотя бы одну сравнительную таблицу.
Как не написать инструкцию для роботов?
Здесь можно перестараться. Ясность ≠ это не скучность. Структура ≠ не сухость. Хороший текст для нейросетей отличается от инструкции к холодильнику ровно так же, как любой хороший текст отличается от плохого. Структура становится жёстче, но голос остаётся.
Можно писать чётко и при этом живо. Второе предложение может быть неожиданным, если первое даёт прямой ответ. Личная история работает, если за ней идёт факт. Лучшие тексты сейчас понятны и человеку, и машине одновременно. Человек читает с интересом. Машина берёт чёткий фрагмент. Так и рождается новый стандарт.
Копирайтинг меняется
Задача убеждать людей никуда не делась, но к ней добавилась другая – объяснять так, чтобы модель могла превратить текст в ответ.
Материалы становятся модульными. Каждый абзац превращается в потенциальный ответ на чей-то вопрос. Ценность теперь отражается в ясности, не в объёме. Две тысячи слов с прямыми ответами, FAQ и таблицей дают больше, чем шесть тысяч слов воды с хорошим SEO-заголовком.
И последнее. Конкуренция в Google перегрета, но в AI-выдаче она только начинается. Большинство авторов ещё не перестроились. Пока окно возможностей открыто, но надолго ли?
Текст готов к LLM, если...
- Прямой ответ есть в первых 150–200 словах.
- Каждый абзац самодостаточен без контекста.
- Нет разгона перед сутью.
- Все H2 сформулированы как вопросы пользователя.
- Структура читается по заголовкам.
- Смысл раздела не зависит от предыдущего.
- Есть таблица.
- Есть FAQ в конце.
- Нет предложений длиннее 25 слов.
- Каждая оценка подкреплена фактом.
Материал подготовлен на основе исследования цитируемости 158 публикаций в AI-системах, опубликованного на vc.ru. Данные по конверсии – Superprompt, 347 компаний, 12,3 млн визитов.