50 отраслевых отчетов Metricore: семь причин, по которым бренды теряют AI-видимость
Низкая AI-видимость выглядит как одна цифра, но за ней скрываются разные поломки. У одной компании нейросеть не видит сайт технически. У другой видит, но не находит ясных фактов. Третью знает по названию, однако не включает в категорийный выбор. Одинаковое значение метрики здесь требует трех разных планов.
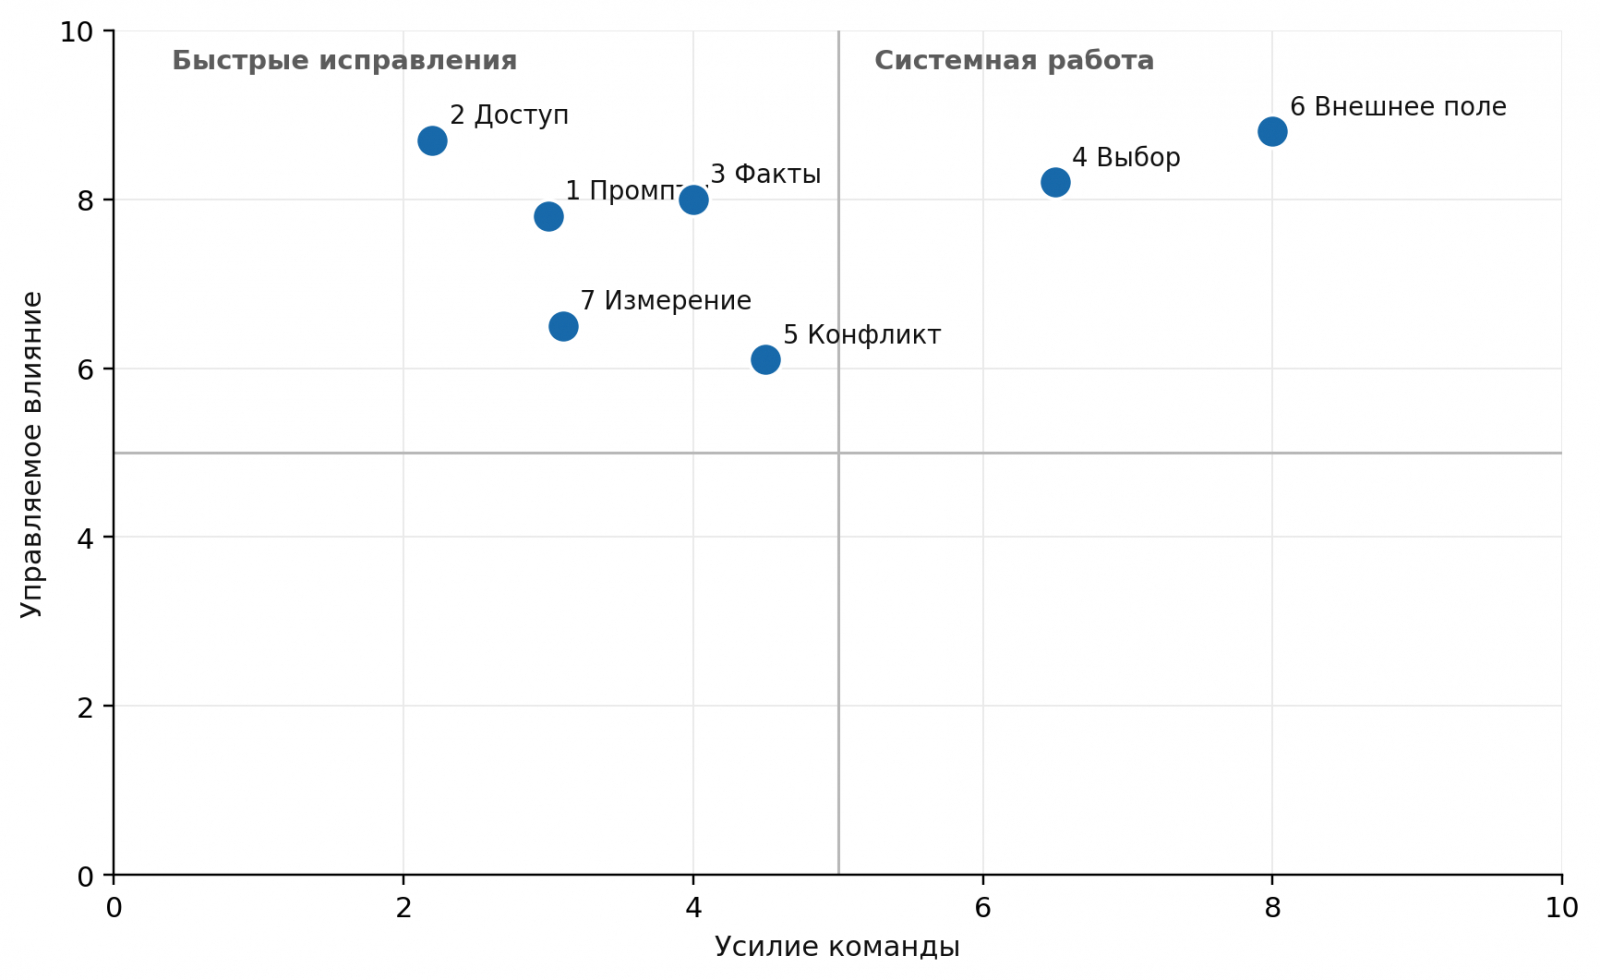
При подготовке 50 отраслевых отчетов Metricore повторялись семь типов разрывов. Ниже они собраны в единую диагностическую схему. Это типология, а не рейтинг: порядок причин не означает их частоту или тяжесть. Отчеты относятся к разным рынкам, поэтому сравнивать их одной абсолютной шкалой было бы некорректно.
Как кодировались проблемы
Единицей анализа был не бренд и не отдельное упоминание. Мы смотрели на разрыв между запросом пользователя, ответом модели, источниками и тем, что компания считает своим продуктовым фактом. Например, отсутствие бренда в одном прогоне - наблюдение. Отсутствие во всех категорийных запросах при наличии в брендовых - уже диагностический паттерн.
Причина 1. Промпт-сет измеряет удобную версию рынка
Частая ошибка методики - проверять только вопросы, в которых уже назван бренд или точный профессиональный термин. Компания получает высокую видимость в контрольной группе и делает вывод, что присутствует в выборе. Но клиент может формулировать проблему иначе: не «GEO-мониторинг», а «как понять, почему ChatGPT не рекомендует нашу компанию».
Проверка проста: разделить запросы на брендовые, категорийные, проблемные, сравнительные, альтернативные и коммерческие. Если результат держится только на брендовых формулировках, проблема находится не в отчетности, а в покрытии реального спроса.
Причина 2. Сайт формально опубликован, но плохо доступен
Страница может существовать для человека и одновременно быть неудобной для поискового доступа: запрет в robots.txt, блокировка на уровне CDN или WAF, тяжелый JavaScript, закрытая авторизация, ошибки ответа сервера. OpenAI рекомендует не блокировать OAI-SearchBot, если сайт должен участвовать в поисковых ответах ChatGPT. Perplexity публикует отдельные требования к PerplexityBot и доступу через защитные системы.
Причина 3. Факты есть, но их трудно извлечь
На странице много текста о лидерстве и инновациях, но нет короткого ответа на базовые вопросы: что делает продукт, кому подходит, какие есть функции, ограничения, цены, регионы и условия внедрения. Модель находит слова, но не получает законченный факт.
Рабочее исправление не сводится к нарезке текста подзаголовками. Нужны проверяемые утверждения, таблицы сравнения там, где параметры сопоставимы, автор и дата обновления. Google в рекомендациях для AI-функций отдельно подчеркивает доступность важной информации в текстовом виде и соответствие структурированных данных видимому содержимому.
Причина 4. Контент объясняет категорию, но не помогает выбрать
Блог может хорошо отвечать на вопрос «что это такое» и ничего не давать для shortlist. На этапе выбора нужны другие страницы: кому решение не подходит, чем варианты отличаются, сколько занимает внедрение, как проверить подрядчика, какие данные потребуются, где проходят ограничения.
Причина 5. Факты о бренде расходятся между страницами
Старый тариф в обзоре, новая функция на лендинге, другое позиционирование в каталоге и третье описание в пресс-релизе создают конфликт. Модель может выбрать устаревшую версию или сформулировать компромисс, которого компания никогда не утверждала.
Для диагностики нужен реестр критичных фактов: название, категория, аудитория, функции, цены, география, юридическое лицо, ограничения и дата актуальности. Затем проверяются собственные страницы и ключевые внешние источники. Для e-commerce к этому списку добавляются наличие, доставка и характеристики товара.
Причина 6. Внешнее поле подтверждает конкурентов
Официального сайта недостаточно для всех типов утверждений. Сравнение рынка, опыт использования и независимая оценка чаще живут во внешних источниках: отраслевых медиа, каталогах, исследованиях, рейтингах и пользовательских обсуждениях. Если там подробно описаны конкуренты, а бренд присутствует только в собственной рекламе, у модели меньше оснований включать его в сравнительный ответ.
Типовой паттерн промышленного B2B: сайт хорошо отвечает на прямой запрос о компании, но в категории лидируют поставщики, присутствующие в отраслевых обзорах и проектных кейсах. Задача здесь - не размножить пресс-релиз, а дать площадкам проверяемую фактуру, методику и понятный редакционный повод.
Причина 7. Отчет смешивает платформы и случайные прогоны
Один ответ легко принять за стабильную позицию. Еще опаснее объединить ChatGPT, Gemini, Perplexity, DeepSeek и YandexGPT в одну среднюю цифру без разреза. Платформы используют разные модели, режимы и источники, а повторный запуск может дать другой shortlist.
В отчете должны храниться платформа, режим веб-поиска, дата, регион, точный промпт, номер повтора и правила агрегации. Средняя метрика допустима только рядом с исходными разрезами. Иначе рост на одной платформе может спрятать падение на другой.
Чем отличаются B2B и B2C
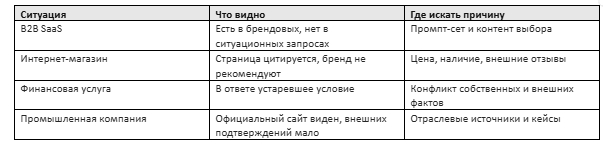
В B2B ответ чаще должен связать продукт с отраслью, размером команды, интеграциями, безопасностью и длинным циклом внедрения. Поэтому особенно заметны провалы в проблемных и сравнительных запросах. Сайт знает собственные функции, но редко объясняет, почему они важны для конкретной роли или сценария.
В B2C сильнее влияют ассортимент, цена, наличие, регион, отзывы и свежесть карточек. Типовой паттерн интернет-магазина: модель цитирует товарную страницу, но не включает магазин в рекомендацию из-за противоречивых условий доставки на внешних площадках. У финансовых и других регулируемых услуг добавляется цена ошибки: устаревший тариф или условие нельзя прятать за общим маркетинговым текстом.
Четыре типовых паттерна в отчете
Что можно исправить быстро
- проверить robots.txt, ответы сервера, CDN и доступ поисковых ботов;
- обновить критичные факты, даты, тарифы и названия функций;
- развести брендовые и небрендовые запросы в отчете;
- добавить ясный текстовый блок о продукте и ограничениях;
- сохранить сырые ответы, ссылки и условия каждого запуска;
- исправить устаревшие карточки на приоритетных внешних площадках.
Что требует трех-шести месяцев
- Пересобрать постоянный промпт-сет по этапам выбора и сегментам.
- Создать контент, который закрывает сравнение, ограничения и реальные сценарии применения.
- Выстроить внешнее поле: исследования, отраслевые публикации, каталоги и независимые обзоры.
- Завести реестр критичных фактов и процесс их обновления на всех площадках.
- Настроить повторяемый мониторинг по платформам без скрытого изменения методики.
Как читать низкую AI-видимость
Первый вопрос должен звучать не «как поднять цифру», а «на каком слое возникает разрыв». Если сайт недоступен, задача идет к технической команде. Если факты противоречат друг другу, нужен владелец данных. Если конкурентов поддерживают отраслевые площадки, потребуется PR и редакционная работа. Если результат держится только на брендовых запросах, придется менять саму панель измерения.
В Metricore отраслевой отчет можно использовать как исходную карту: отдельно посмотреть запросы, ответы, конкурентов и источники, а затем повторить ту же панель после изменений. Полезная диагностика не обещает место в рекомендации. Она показывает, какой разрыв проверяем, кто за него отвечает и какое наблюдение будет считаться изменением.