Как мы заменили разработчика ИИ-агентом и что получили в итоге
Недавно мы реализовывали проект с жестким дедлайном и решили протестировать ИИ-агентов в действии. Нашей целью было проверить, способен ли ИИ-агент реализовать полный объем работы разработчика самостоятельно, а не отдельные части. Мы готовы были делегировать весь цикл - от реализации функциональности и DevOps до подготовки проектной документации. На себе мы замкнули утверждение планов, проверки полученных результатов и постановку задач.
План активной разработки предполагал 6 месяцев работы команды, состоящей из пяти инженеров. Мы определили объем задач для одного из них и передали их на исполнение ИИ-агенту. В рамках эксперимента мы определили, что даже самые незначительные изменения будут проходить через ИИ-агента, даже если бы команда смогла внести их быстрее. Позднее мы убедились, что это условие серьезно усложнило нашу работу, но позволило придерживаться одного процесса работы: изменения в код вносил агент, а команда контролировала результат.
О том, какие модели мы использовали, как организовали работы, как выстроили валидацию и с какими ограничениями столкнулись, рассказываем далее.
Как мы организовали работу ИИ-агента
Весь рабочий процесс ИИ-разработчика мы разделили на 5 направлений.
- Первое: разработка функциональности. В задачи агента входило: получение требований, составление плана, передача его команде на утверждение, реализация функциональности, отладка и подготовка изменений в индексе Git (staging area)..
- Второе: работа с Git. Здесь от агента требовалась подготовка изменений в коде. При этом за командой мы оставили создание коммитов и отправку изменений в удаленный репозиторий (push).. Так мы сохраняли контроль над изменениями в проекте.
- Третье: документация кодовой базы. Перед началом работы над каждой задачей ИИ-агент должен был фиксировать состояние проекта в AGENT.md и после каждой итерации обновлять документацию.
- Четвертое: DevOps. На плечи ИИ-агента мы возложили первоначальную настройку тестов, конфигурацию сервисов и инфраструктурные задачи.
- Пятое: проектная документация. Агент должен был описывать архитектуру, проектные решения, писать руководства администратора и пользователя. Для этого он использовал документацию, которую формировал и обновлял в процессе разработки. Черновики передавались техническому писателю для подготовки документов в готовом виде.
Мы организовали работу таким образом не для ускорения отдельных операций с помощью моделей, а для проверки - получится ли делегировать агенту полный цикл разработки, то есть весь объем задачи, за который обычно отвечает один инженер.
Что мы в итоге оставили команде на исполнение? За людьми мы закрепили ответственность за постановку задач, проверку планов, приемку результатов, создание коммитов и отправку изменений в репозиторий.
Какие LLM-модели мы использовали
Одной модели для исполнения задач было недостаточно, поэтому в ходе эксперимента мы использовали три: Kimi K2.5, MiniMax M2.7 и GLM-5.1. Для всех трех моделей провайдеры предоставляли гарантии, по которым передаваемые данные не сохраняются в логах и не используются для обучения. Это было одним из условий выбора моделей.
Выстраивали архитектуру так, чтобы она не зависела от выбора конкретной языковой модели. Одна и та же схема могла работать как в частном облаке, так и на собственной инфраструктуре.
Во время работы с этими тремя моделями мы обнаружили важную закономерность: даже при одинаковых промтах и наборе инструментов, они ведут себя по-разному. Причем различаются не только способы рассуждения и глубина анализа задач, но и частота использования инструментов для их решения. Эти различия напрямую влияют на качество исполнения задач и меняют подход к выбору моделей.
К примеру, GLM-5.1 в нашей конфигурации вела себя крайне вдумчиво и скурпулезно. Она многократно анализировала код перед тем как приступить к задаче. С одной стороны, такая особенность поведения во время планирования и отладки полезна, но в то же время она приводила к увеличению расходов на API и продолжительности рабочих сессий.
При этом речь идет именно о поведении модели в нашей конфигурации, а не о том, что GLM-5.1 всегда работает медленнее или обходится дороже других моделей.
Что мы в итоге вынесли из этого опыта? Ориентация на рейтинги, личные предпочтения и результаты прошлых тестов - все это, конечно, важно, но главное правило таково: модель нужно выбирать исходя из того, насколько она хорошо справляется с конкретными задачами в заданной архитектуре.
Как изменилась роль документации
Одним из наиболее существенных изменений стало отношение к документации. Обычно над документацией работают после завершения разработки, пишется код и только после этого описывается, как все работает. Но в работе с нашим ИИ-агентом роль документации изменилась. Она стала входным источником информации. В нашей архитектуре агент не сохранял рабочий контекст автоматически между сессиями, и для продолжения работы нужно восстановить информацию о состоянии проекта, его архитектуре, ограничениях и решениях, принятых ранее. В нашем эксперименте эту функцию выполняла хорошо структурированная документация.
Мы перед каждой задачей фиксировали состояние системы, а после каждой итерации разработки обновляли документы. По большому счету, документация в нашем процессе была похожа на входные данные компилятора. Когда она устаревала, содержала противоречивые сведения или не имела достаточных сведения, ИИ-агент выполнял задачу с ошибками.
В одном из наших проектов мы столкнулись с показательной ситуацией. В AGENTS.md осталась устаревшая инструкция по переключению кэша. Она описывала один сценарий, тогда как актуальная архитектурная документация предусматривала другой. В результате в контексте агента оказались два противоречащих друг другу указания.
Противоречие обнаружили три независимых ревьюера во время проверки. Ошибка не успела перейти в реализацию, но этот случай показал, что даже подробная документация не гарантирует правильную работу агента, если в ней есть устаревшие или противоречивые инструкции.
Как мы организовали AGENT.md
Для небольшого проекта может быть вполне достаточно и одного актуального файла AGENT.md.
В нашей структуре такой файл содержал:
- обзор проекта и его структуру;
- технологический стек;
- принятые соглашения;
- известные проблемы;
- чек-лист ревью;
- краткую справочную информацию;
- описание тестовой инфраструктуры;
- зависимости и архитектурный контекст.
Если вы реализуете крупный подобный проект, то мы рекомендуем в таком случае разделить документацию на отдельные файлы под каждый модуль, а в главном файле разместить ссылки на них и информацию о самом проекте. Для систем сложнее можно использовать RAG-подход - то есть организовать поиск по базе знаний проекта, чтобы агент мог получать нужные фрагменты документации без загрузки всей документации сразу.
Если в документе содержится противоречивая информация, то ИИ-агент может следовать некорректным инструкциям и допускать ошибки. Такие ошибки могут быть незаметными с самого начала, но со временем накапливаться и приводить к проблемам.
Что важно знать об инструментарии
Если у агента нет возможности исследовать кодовую базу, анализировать зависимости и проверять состояние работающей системы, то он будет компенсировать недостаток информации предположениями. В случае с масштабными разработками, такие предположения могут приводить к дорогостоящим ошибкам.
Понимая это мы определили минимальный набор возможностей. Без них агенту сложно качественно работать над проектом. В их числе:
- навигация по файловой системе;
- поиск по кодовой базе;
- анализ графа зависимостей;
- запуск тестов.
Все эти инструменты позволяют агенту получать фактическую информацию о проекте, а не строить предположения на основании контекста промпта.
Во время работы мы столкнулись еще с одной проблемой: многие инструменты не соответствовали нашим требованиям к надежности, чтобы использовать их в корпоративных проектах. И не всегда понятно, качественно ли они поддерживаются и будут ли развиваться в дальнейшем. По этой причине мы разработали часть инструментов самостоятельно. Например, для управления агентами мы создали собственные MCP-серверы на языке Go, потому что их разработка оказалась быстрее и дешевле, чем если бы мы внедряли и адаптировали уже готовые решения. При это в нашей архитектуре мы все равно могли использовать разные языковые модели без изменения ее структуры.
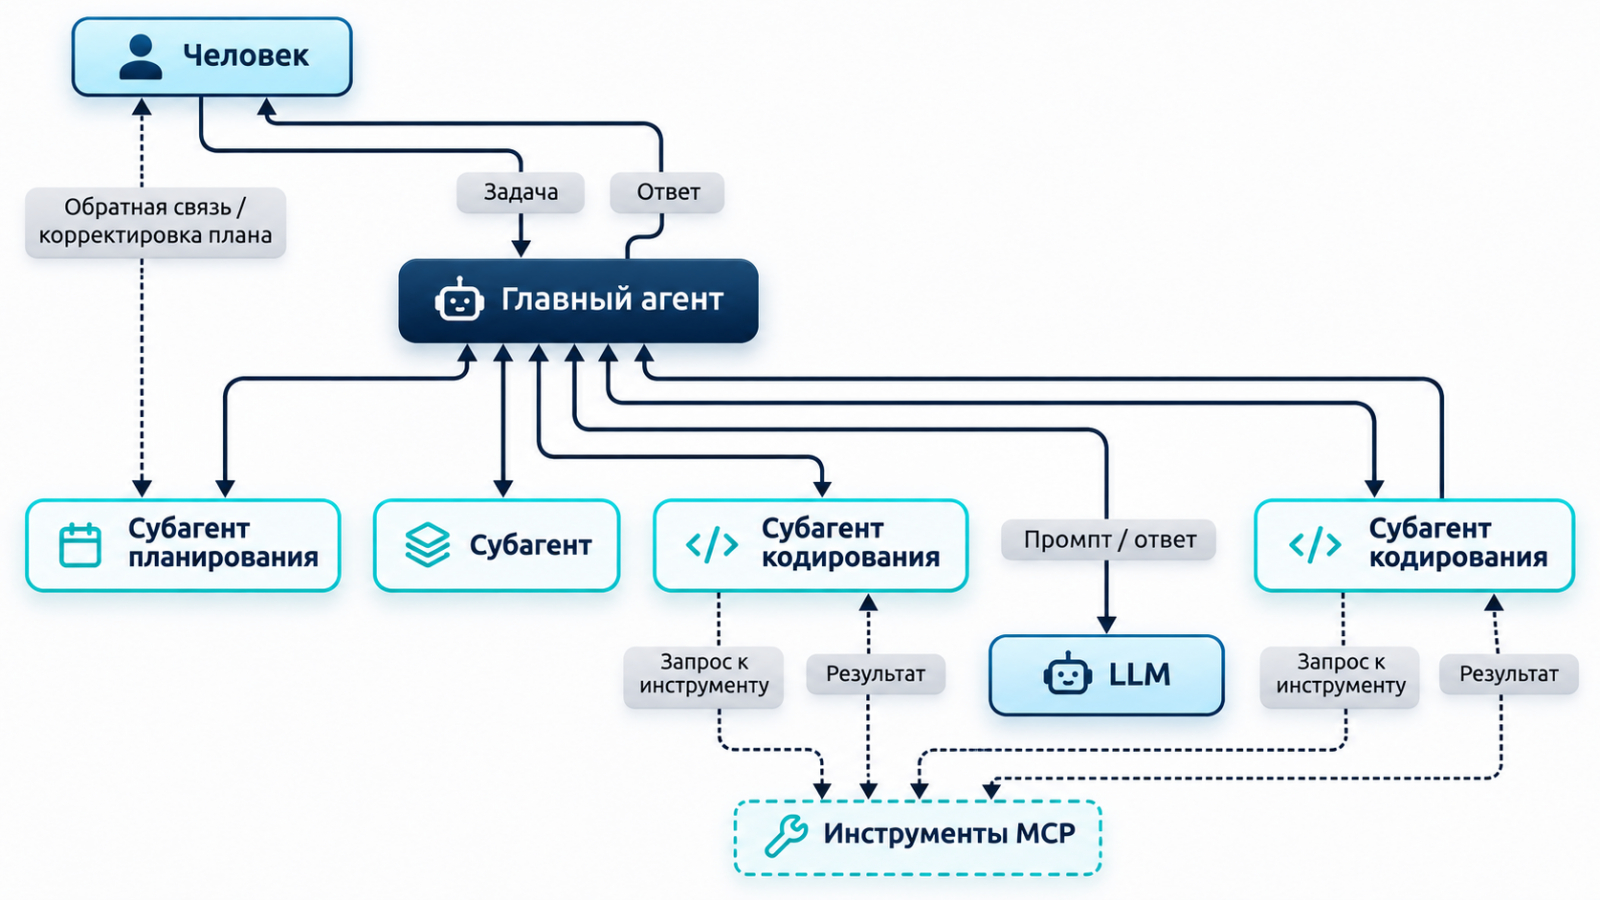
В нашей схеме человек взаимодействует с главным агентом, который координирует работу специализированных агентов: планирования, исполнения и разработки. Для обращения к инструментам используется MCP. При необходимости человек может вернуть обратную связь и скорректировать план работы.
Как мы обеспечивали качество работы ИИ-агента
ИИ-агент может допускать ошибки на любом этапе разработки, а команда не всегда способна их заметить, особенно при большом объеме работы и жестких дедлайнах. Поэтому мы решили проводить проверку результатов в несколько этапов.
- Перед разработкой мы проверяли план на соответствие требованиям и текущему состоянию проекта.
- После выполнения задачи происходила проверка результат перед сохранением изменений в Git.
- После завершения всего плана проводилась финальная проверка и только потом результаты передавались команде.
Для этого мы использовали дополнительные проверки с помощью моделей. Человек оставался последним уровнем контроля, но уже не единственным.
Важно не допускать ситуации, когда агент проверяет собственный результат, опираясь на те же предположения, с которыми выполнял задачу. Такая проверка может не обнаружить ошибку, поэтому мы уделяли внимание дополнительным этапам валидации.
С какими ограничениями мы столкнулись
Во-первых, мы систематически находили ошибки в коде. Модель может уверенно выдавать неправильный результат и если постоянно контролировать каждое ее действие вручную, то можно создать чрезмерную нагрузку на инженеров. Мы сделали ставку на автоматизированные проверки и статический анализ кода.
В-вторых, актуальность документации стала критически значимой. Если ее перестать регулярно обновлять, ошибки и несоответствия постепенно накапливаются. Со временем их исправление может оказаться настолько сложным, что систему будет проще переписать заново.
В-третьих, мы столкнулись с ограничениями самой технологии. Модели плохо справляются с устаревшими системами, low-code платформами и узкоспециализированными решениями. В итоге, потребуется больше работы над промптами, а иногда и дополнительное обучение моделей. Мы поняли, что специалисты с глубокой экспертизой в этих областях остаются незаменимыми.
Кроме ограничений моделей, мы выделили несколько ошибок в самой организации работы с агентами:
- Доверять уверенному ответу агента, не проверяя его по коду и результатам тестов.
- Передавать большой и размытый объем задач без четких критериев приемки.
- Не обновлять документацию после изменения архитектуры или функциональности.
- Поручать агенту проверять собственную работу, сохраняя те же исходные допущения, которые могли привести к ошибке.
Все эти ситуации повышают риск того, что ошибка останется незамеченной на этапе выполнения задачи и проявится позже, когда исправить ее будет сложнее.
Что мы получили в итоге
Наш эксперимент показал, что в работе с ИИ-агентами меняются не только процессы разработки, но и требования к самим инженерам. Среди них: умение самостоятельно управлять большим объемом задач, точно формулировать требования, разбивать сложные проблемы на отдельные этапы и выявлять ошибки в работе агентов. В целом, требуются широкие технические знания. По сути, в таких проектах роль разработчика становится ближе к роли технического руководителя.
Главный вывод нашего эксперимента состоит в следующем: надежность ИИ-агента зависит не только от выбранной модели, но и от того, насколько грамотно организована работа вокруг нее. Документация, доступ к инструментам и многоуровневая проверка оказались для нас не вспомогательными элементами, а необходимыми частями процесса. При этом команда все еще остается ключевым участником процесса, хотя и меняется объем ее работы.