Как сменить подрядчика по разработке и не потерять контроль над ИТ-продуктом
Смена подрядчика редко сводится к «найдём другую команду». Вместе с исполнителем уходит всё, что не записано: как устроена система, почему сделано именно так и что можно трогать безопасно.
Если переход не подготовить, продукт остаётся, а управляемость пропадает. Обновления выпускают с оглядкой: непонятно, что они заденут. Сроки оценить некому. Любая правка упирается в людей, которых уже нет в компании. А ведь речь не только о коде, а о предсказуемости: можно ли обещать сроки, планировать бюджет и не бояться, что релиз остановит продажи.
Мы собрали опыт технического директора, менеджера проектов и специалиста по тестированию АЙТИФОКС, которые принимали IT-продукты у предыдущих команд и знают, где всё обычно ломается. Разберём, когда менять подрядчика, как организовать передачу, что проверить в системе и как новой команде начать без лишних рисков.
Почему смена подрядчика — риск для бизнеса
Когда продукт годами делает одна команда, знания о нём оседают в головах. Формально у компании есть код, репозиторий, серверы и договор. А на простые вопросы ответа может не быть:
● Какая версия сейчас работает у клиентов?
● Как выпускается обновление?
● Какие интеграции критичны для выручки?
● Где хранятся доступы и секреты?
● Какие задачи запускаются автоматически по расписанию?
● Что будет, если обновление сломает систему?
● Можно ли восстановить данные из резервной копии?
Пока подрядчик на месте, эти вопросы не мешают. Острыми они становятся в момент передачи.
В одном из проектов компания принимала действующий сайт после двух предыдущих подрядчиков. Документации почти не было, а общение с прежними разработчиками шло формально и ничего не объясняло. Сайт работал, но заказчик не понимал, как он устроен и что в нём можно менять без последствий. Позже эту историю разобрали в отдельном кейсе: как перезапускали legacy-платформу после двух команд, ускорили загрузку и восстановили интеграции.
В этом и состоит главный риск: продукт остаётся, а понимание, почему он работает именно так, уходит. Чем меньше знаний передано, тем дольше бизнес живёт в неопределённости: бюджет тратится, а результат откладывается.
Когда пора менять подрядчика, а когда ещё можно всё исправить
Универсального момента нет, но есть сигналы, которые стоит проверить до решения.
Продукт тормозит по мере роста. Если простые операции стали заметно медленнее, когда данных прибавилось, дело может быть в архитектуре или в работе с базой. Для бизнеса это значит, что продукт плохо масштабируется, а рост аудитории будет сопровождаться сбоями.
Знания живут в людях, а не в команде. Документации нет, решения объясняют только на словах. Уход специалиста или смена подрядчика превращается в потерю управляемости.
Релизов боятся. Нет тестового контура, автоматизации выпуска или возможности отката, и каждое обновление рискованнее предыдущего. Это может закончиться простоем.
О проблемах узнают от пользователей. Если сбой обнаружился на важном мероприятии или у клиентов, ключевые сценарии не проверялись. Для бизнеса это потери денег, репутации и клиентов.
Критичные процессы зависят от одного человека. Знания о развёртывании или отдельных компонентах сосредоточены у одного разработчика, а помощь от него получить трудно. Заказчик в такой ситуации уязвим.
Многие тянут со сменой подрядчика из-за уже вложенных денег. Логика понятная, но не всегда рациональная. Иногда работу текущей команды действительно можно наладить, а иногда новые вложения только увеличивают потери. Поэтому решение стоит принимать не по сумме уже потраченного, а по прогнозу: сколько ещё потребуется ресурсов и с какой вероятностью они дадут результат.
Если ситуация неоднозначная, перед сменой команды полезна независимая техническая оценка проекта. Она поможет отделить проблемы разработки от проблем управления и понять, нужен ли вам вообще новый подрядчик.
Как передать IT-проект новой команде
Если передача уже началась, задача заказчика — не принимать проект вслепую. Новой команде нужен не только исходный код, но и всё, что позволит работать, проверять и развивать систему. Список будет отличаться от проекта к проекту, и часть документов может просто не существовать.
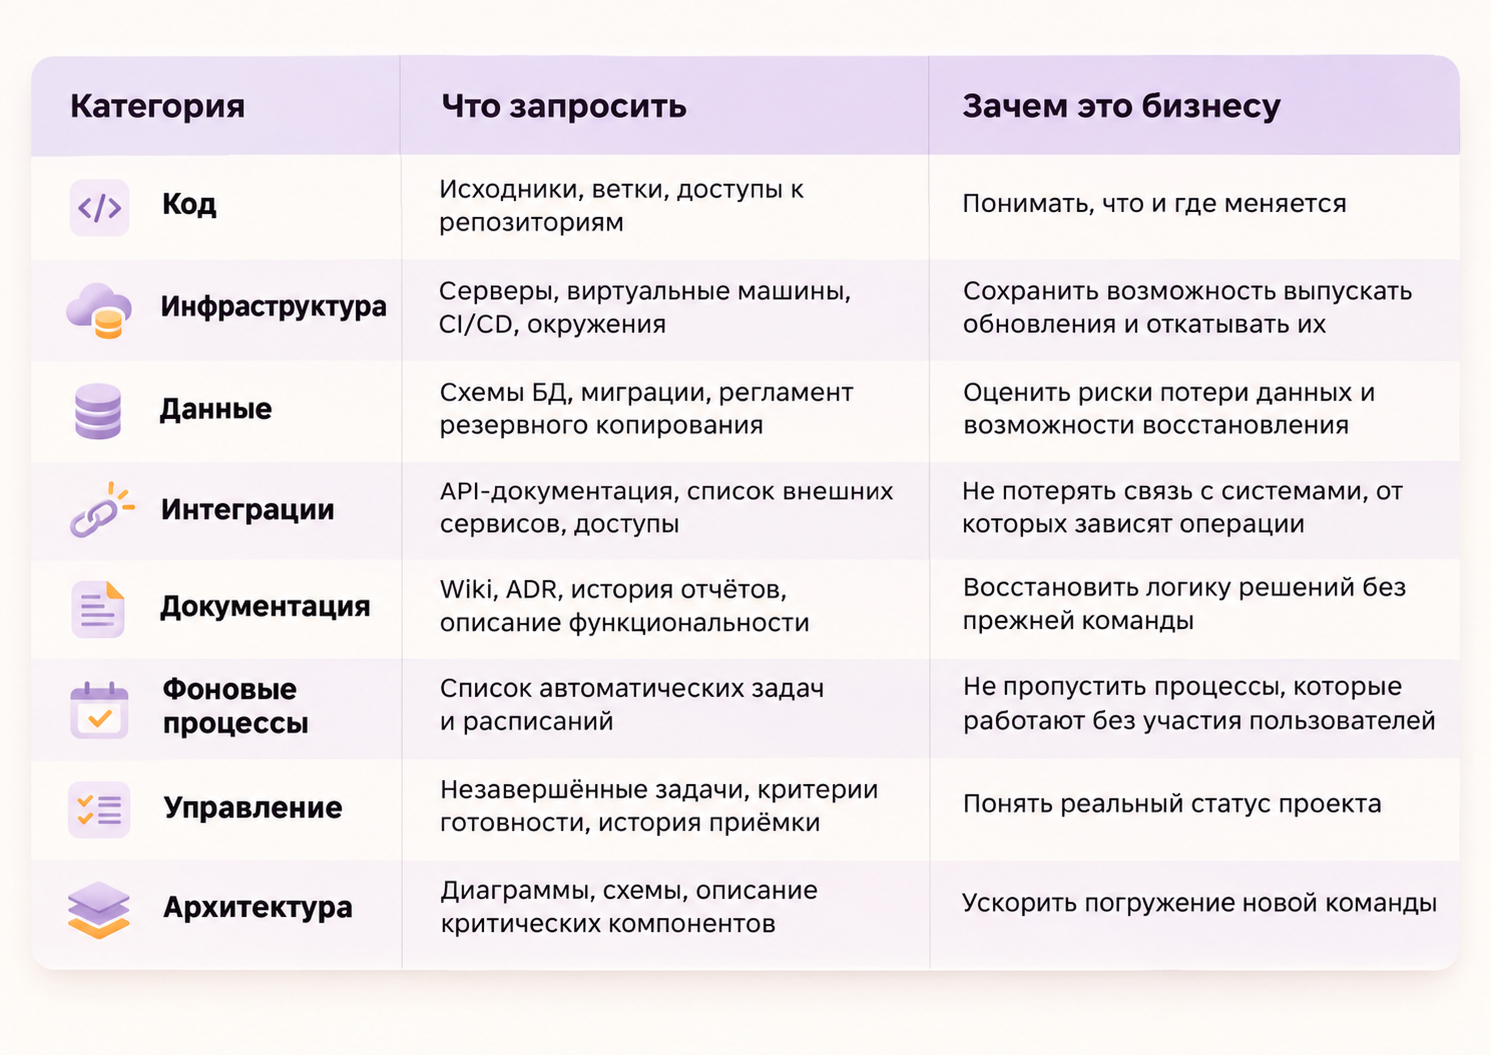
Отдельно про ADR, журнал архитектурных решений. Это не бумажка для галочки, а способ не восстанавливать заново историю того, почему система устроена именно так.
Если прежняя команда не помогает, изучение продукта затягивается: приходится самим разбираться в архитектуре и связях между компонентами. Сколько займёт такое погружение, заранее сказать трудно, это зависит от объёма кода, состояния документации и сложности интеграций. Но всё, что не передано, новой команде придётся восстанавливать за дополнительное время и деньги.
Как провести технический аудит существующего продукта
После передачи важно понять, в каком состоянии система на самом деле. Для этого проводят техническую диагностику: смотрят исходный код, архитектуру, инфраструктуру, базы данных, интеграции и работу основных функций.
Аудит нужен не ради списка замечаний. Его задача — определить, можно ли решить проблемы бизнеса на существующей архитектуре, какие риски требуют внимания немедленно и что можно развивать без полной переработки.
Код и архитектура
Проверка кода показывает структуру проекта, связи между компонентами, технический долг и ограничения для дальнейшей разработки. Но оценивать качество кода в отрыве от задач продукта нельзя. Если система не выдерживает нужную нагрузку или не закрывает важный пользовательский сценарий, техническое решение придётся пересматривать. А красивый код сам по себе не означает, что продукт решает задачу бизнеса.
Нагрузку проверяют исходя из того, как продукт реально используют, а не по случайным цифрам из интернета. В одном из обсуждений звучал пример с 10 и 20 тысячами пользователей, но это иллюстрация запаса, а не метрика для конкретного проекта.
Доработка или переписывание
Переписывать систему только потому, что технология старая, не стоит. Нужно учитывать задачи бизнеса, ограничения, стоимость изменений и доступность специалистов.
В практике АЙТИФОКС был случай, когда переписали не весь продукт, а только проблемную логику работы с данными, причём система всё это время оставалась доступной для пользователей. Иногда достаточно точечной доработки, а не полной замены. Похожий подход (сохранить legacy-ядро и построить вокруг него современный слой) описан в кейсе «Proxy API для legacy-системы».
По итогам аудита заказчик может получить схемы текущей и предлагаемой архитектуры, описание проблем, рисков и вариантов исправления. Для этого используют UML, C4, sequence diagrams и другие инструменты. Единого шаблона отчёта нет, он зависит от задач и состояния системы. Главное, чтобы результат помогал принимать решения: что сохранить, что исправить и сколько ресурсов это может потребовать.
Отдельно о коде, написанном с помощью ИИ. Он может выглядеть аккуратно, но не соответствовать бизнес-требованиям или плохо масштабироваться. Проверять его нужно так же строго, как любой другой.
Критические сценарии и интеграции: что проверять в первую очередь
При смене подрядчика сначала проверяют то, чем пользователи занимаются каждый день: вход в систему, привязку компании, заполнение и отправку заявки, получение ответа от стороннего сервиса.
Если автотестов нет, сначала вместе с заказчиком фиксируют ожидаемое поведение и проверяют его вручную. Автоматизацию планируют уже потом.
Статусу «всё работает» без проверки доверять нельзя. В одном из проектов заказчик сообщил, что подача заявок готова, и команда переключилась на другие задачи к мероприятию: аналитику, регистрацию и печать бейджей. А во время самого мероприятия выяснилось, что пользователь видел подтверждение отправки, но заявка до внешнего сервиса не доходила. Разбираться пришлось срочно, вместе с представителями этого сервиса.
Урок простой: при приёмке нужно проверять не только интерфейс, но и сквозную работу интеграций. Подтверждение на экране не равно доставке данных во внешнюю систему. Для бизнеса это разница между обработанной заявкой и потерянным клиентом.
Инфраструктура, релизы, доступы и резервные копии
Здесь экономия времени легко оборачивается серьёзными рисками. Перед любыми изменениями в рабочей системе проверьте:
● Исходный код и ветки. Ветка, из которой собирается релиз, должна соответствовать версии, работающей у пользователей.
● Логи, метрики и уведомления. Убедитесь, что есть доступ к мониторингу, например к Sentry или Grafana, если они используются.
● Тестовое окружение. Изменения нужно проверять до выпуска в рабочую систему. Если окружения нет, его стоит подготовить.
● CI/CD. Проверьте права на запуск, реальный успех обновлений и возможность отката.
● Доступы. Репозитории, серверы, интеграции, внешние сервисы и хранение секретов. Если всё оформлено на личные аккаунты прежнего подрядчика, компания рискует потерять контроль над системой.
● Резервные копии. Наличие файла не означает, что данные можно восстановить. Нужно сделать пробное восстановление и проверить важные сценарии.
Первый релиз новой команды лучше сделать небольшим, легко проверяемым и обратимым. Крупные миграции не стоит начинать, пока процесс выпуска обновлений не отработан: сначала убедитесь, что механизм работает, и только потом переходите к сложным изменениям.
Как расставить приоритеты после аудита
После диагностики обычно находится много всего: от ошибок в основных сценариях до устаревших компонентов и неудобств интерфейса. Исправлять всё сразу не нужно. Критичность определяется влиянием на пользователей и бизнес, а не возрастом технологии или внешним видом кода.
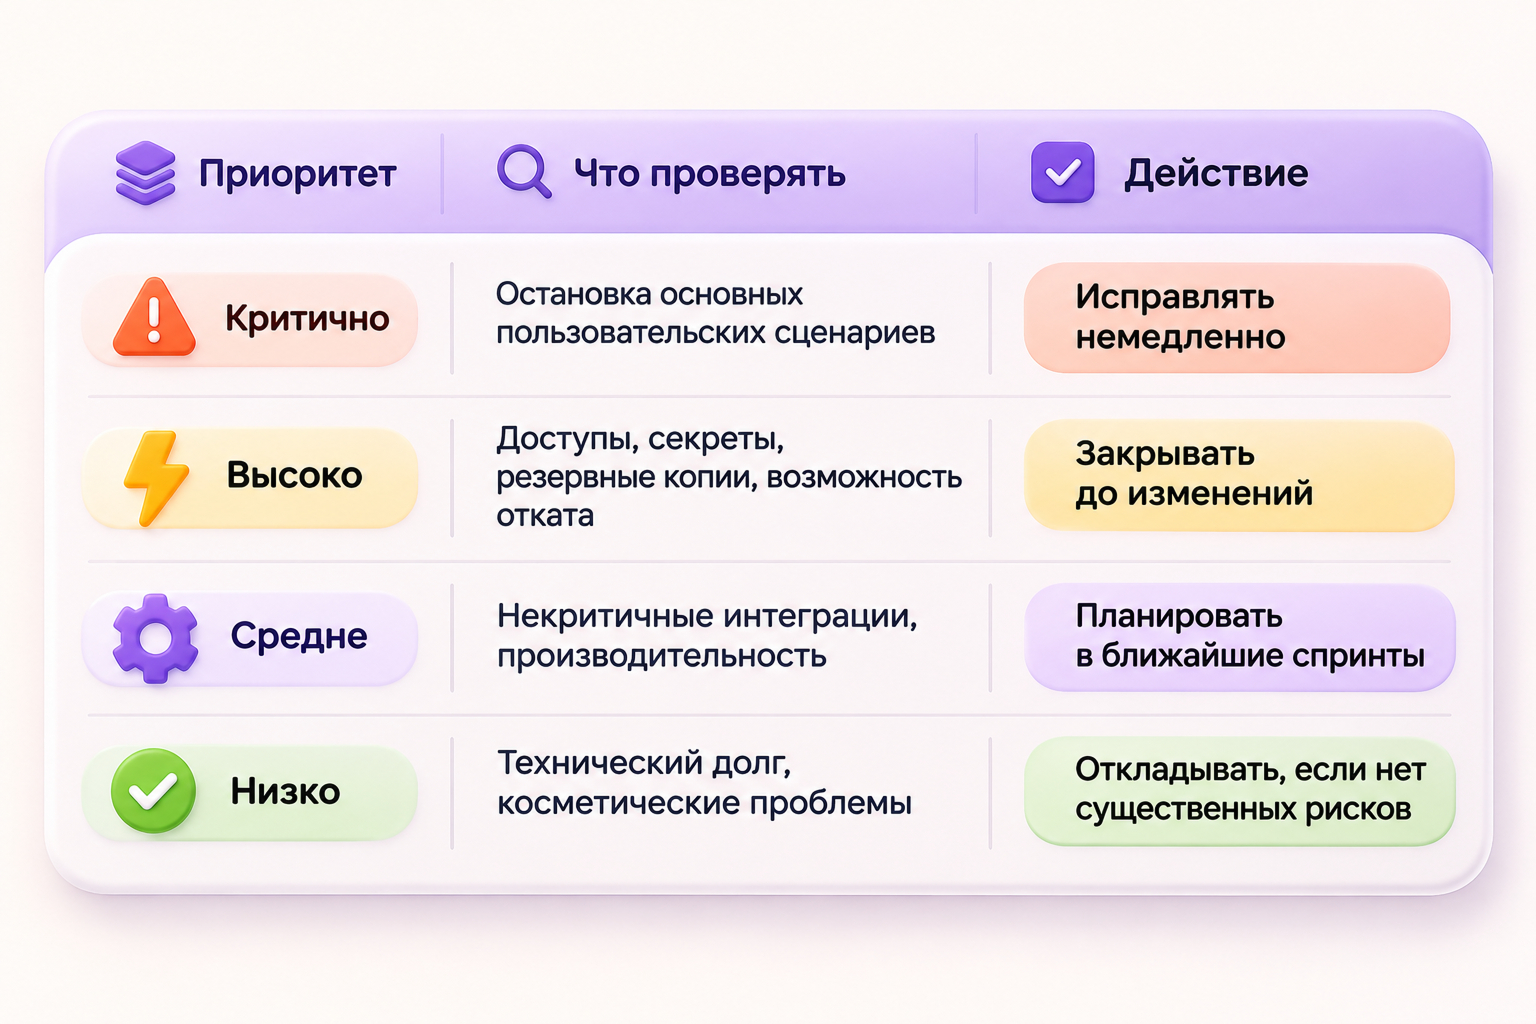
Пример из практики: в одном проекте при ручном создании пользователя через админ-панель не создавалась корзина, и у этого пользователя появлялся белый экран. Позже добавили защиту от такого некорректного состояния. Это отдельный случай из разработки, не обязательно связанный со сменой подрядчика, но он хорошо показывает, как работает приоритизация.
И не всё нужно переписывать. Иногда достаточно изолировать проблемный компонент и поправить его. Так можно обойтись без дорогой полной замены системы.
Как новой команде войти в проект и организовать приёмку
Управленческую сторону смены подрядчика часто недооценивают. После нескольких неудачных команд заказчик может требовать подробную документацию, видеозаписи приёмки и объяснения по каждой незавершённой задаче. Это понятно: доверия меньше, контроля хочется больше. Но у такого контроля есть цена: время команды.
В одном из проектов подготовка к пятничной приёмке съедала часть спринта, а на приведение документов к требованиям ГОСТ ушло около 4–5 дней. После двух спринтов переделок стало меньше. Команда упорядочила оценку и согласование приоритетов, перенесла приёмку на понедельник, а позже ввела критерии готовности задач и отдельную доску. Первые две недели ушли в основном на погружение в проект, затем продукт подготовили к мероприятию, а сотрудничество продолжалось ещё около двух лет.
Это не гарантированный результат смены подрядчика, а пример того, как доверие возвращается через прозрачную работу и проверяемые результаты. При этом чрезмерная отчётность тоже тормозит разработку. Нужен баланс: заказчик понимает, что происходит с продуктом, но контроль не становится самоцелью.
Чек-лист: что проверить при смене подрядчика
● Получить исходный код и доступы к репозиториям
● Сверить ветку релиза с версией, которая работает у пользователей
● Проверить тестовое окружение или подготовить его
● Проверить CI/CD, права на запуск и возможность отката
● Проверить резервные копии пробным восстановлением
● Зафиксировать критические пользовательские сценарии
● Проверить сквозные интеграции, включая передачу данных во внешние сервисы
● Проверить доступ к логам, метрикам и уведомлениям
● Проверить хранение секретов и отсутствие зависимости от личных аккаунтов прежнего подрядчика
● Собрать документацию: wiki, ADR, API, фоновые задачи, серверы, схемы БД, архитектурные диаграммы
● Оценить зависимость от отдельных специалистов
● Классифицировать технические риски по влиянию на работу продукта
● Определить, какие компоненты сохранить, доработать или заменить
● Сделать первый релиз небольшим, проверяемым и обратимым
● Настроить понятную приёмку и критерии готовности задач
Главное о смене подрядчика
Смена подрядчика по разработке — это управляемый переход, а не лотерея. Чем раньше компания получает доступы, документацию, понимание критических сценариев и возможность безопасно выпускать изменения, тем меньше она зависит от конкретной команды.
Технический аудит нужен не для поиска виноватых. Его задача — понять, какие решения можно сохранить, что исправить срочно, а что отложить. И дать новому подрядчику или внутренней команде возможность продолжить разработку, не начиная всё с нуля.